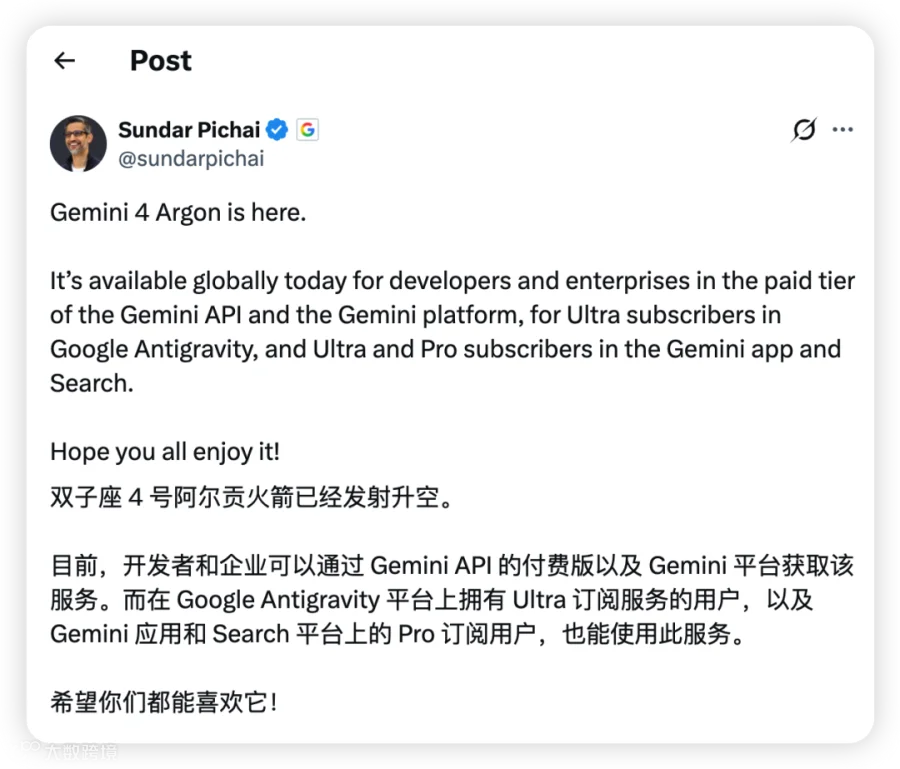
北京时间10月14日凌晨,谷歌CEO皮查伊正式发布新一代旗舰基座模型 Gemini 4 Argon。相比上一代,该模型在长上下文处理、多模态推理及机器人仿真等领域实现显著突破,旨在解决编程、金融、法律及科研中的复杂长周期任务。
核心能力升级与开放渠道
Gemini 4 Argon 的单次输出上限从 6.4 万 token 大幅提升至 100 万 token,使其具备在不中断思维链的前提下,独立执行超长周期复杂工程与科学推导的能力。同时,其多模态推理优势首次延伸至机器人环境仿真领域。
目前,谷歌通过以下四大渠道开放 Argon 体验:
开发者与企业端:通过 Google AI Studio 中的 Gemini API、Google Cloud 上的 Gemini 平台,以及付费版 Android Studio 开放调用;
智能体开发平台:向 Google AI Ultra 订阅用户开放智能体编程平台 Google Antigravity 的调用权限;
消费级入口:向 Google AI Ultra 及 Pro 订阅用户开放 Gemini App 与 Google 搜索中的 AI Mode,并提供三个档位;

网络安全无护栏版:通过 Fairwind Program(顺风计划)向数百家受信任的安全机构开放移除网络攻防限制的专用版本,用于零日漏洞挖掘与防御。
Gemini App 同步升级,新增从聊天切换到任务执行的交互入口,支持连接40多款第三方应用,涵盖购物、订餐、设计和电商服务。用户可委托模型整理资料、制作演示文稿、发送邮件或创建自动化任务。
行业评测登顶与内部效能提升
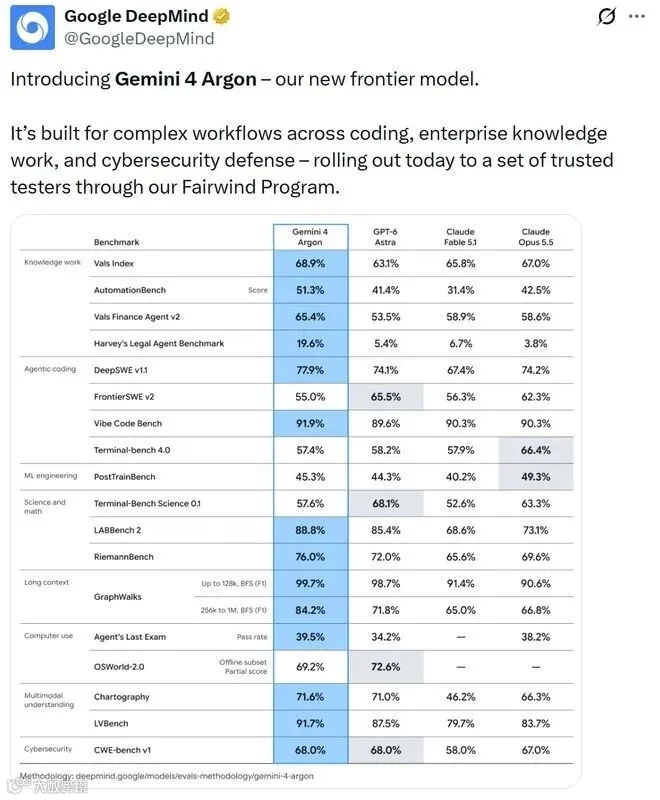
在 Vals Index 企业级专业任务综合评测中,Gemini 4 Argon 以 68.9% 的成绩位居榜首;在 DeepSWE v1.1 长程软件工程任务中取得 77.9%,超越 GPT-6 Astra 和 Claude Opus 5.5;在 CWE-bench v1 漏洞修复能力评估中,以 68% 的成绩与 GPT-6 Astra 并列第一。
谷歌内部已大规模部署 Argon。数千名员工利用其进行专项编程、深度研究和写作。数据显示,该模型使编程 Agent 的代码提交量增加超过 35%,帮助 Chrome 团队重构涉及 600 万行遗留代码的复杂架构,并将开源 Gemma 模型的推理速度提升至原来的 2.85 倍。
在具身智能领域,Argon 通过观看人类玩投掷游戏的视频,学习动作并迁移至人形机器人,实现连续 7 次投掷命中。这标志着谷歌对旗舰模型的定位已从单纯的知识问答,转向在真实工程、企业业务及科学研究中持续工作并交付可验证成果。
百万Token上下文与限时半价策略
据 Google DeepMind 高级副总裁 Koray Kavukcuoglu 介绍,Gemini 4 Argon 旨在解决编程、金融、法律、网络安全和科学研究中需要长期执行的复杂现实问题。

为支撑长时间任务,Argon 支持 100 万 Token 的统一上下文预算,输入、思考和输出共享额度。通过 Long Decode 长输出机制,单次任务累计输出理论上可接近 100 万 Token,允许模型在一次任务中完成更长时间的推理、代码修改和结果生成,无需频繁中断重组上下文。
商业化定价方面,谷歌推出限时优惠:2026年11月30日前,Gemini 4 Argon 每百万输入 Token 收费 2 美元,每百万输出 Token 收费 10 美元。这一价格仅为 Claude Opus 5.5 标准 Token 价格的一半,且低于 GPT-6 Astra。
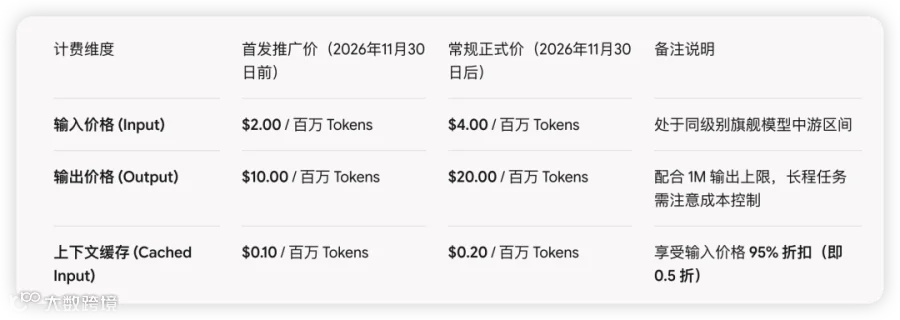
此外,95% 的上下文缓存折扣是另一大亮点。对于需频繁读取数百万行代码库或大量文档的企业级 Agent,极低的缓存读取成本能大幅摊薄多轮智能体循环的费用。需注意,11月底后调用成本将翻倍。
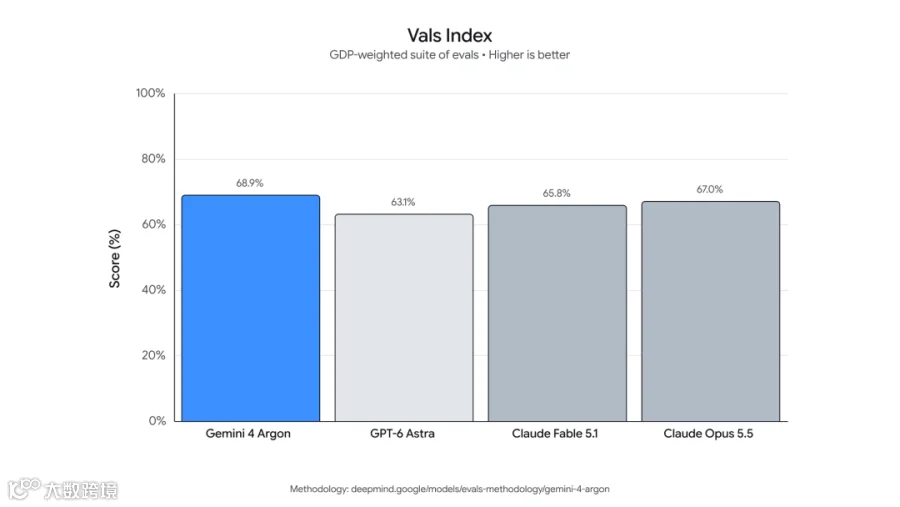
在专业能力评测中,Vals Index 根据金融、编程、法律和税务等行业对美国 GDP 的贡献加权,更关注模型处理真实专业任务的能力。截至10月13日,Gemini 4 Argon 以 68.90% 排名第一,优于 Claude Sonnet 5.5 (67.04%) 和 Claude Opus 5.5 (66.97%)。
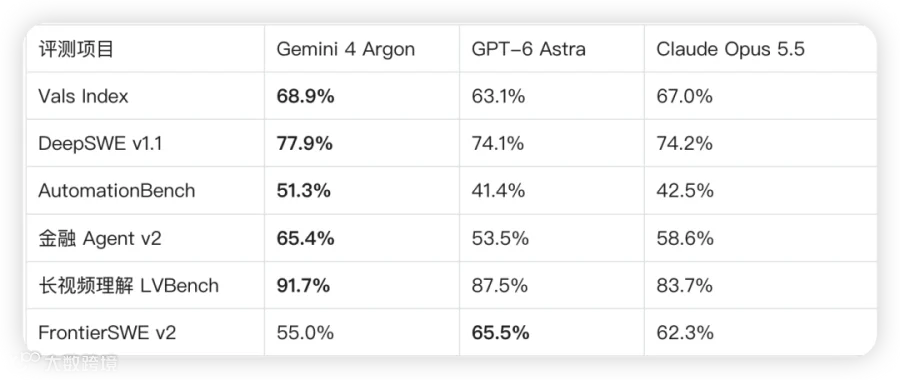

但在 FrontierSWE v2 和 Terminal-Bench 4.0 等测试中,Argon 仍落后于 GPT-6 Astra 或 Claude Opus 5.5。这表明 Gemini 4 在长流程专业工作中表现突出,但尚未全面碾压对手。
Agent代码提交增35%,推理提速3倍
官方博文详细介绍了 Gemini 4 Argon 在公司内部工程中的应用。使用 Argon 和 Antigravity 的团队,Agent 参与生成的代码提交量增加超过 35%,代码回滚量减少近三分之一。这两个指标结合更能反映真实的软件研发效率。
在 Chrome 浏览器架构重构项目中,Chromium 拥有约 4000 万行代码,其中历史遗留目录包含约 600 万行代码。Argon 协助工程师在数百个文件中推进修改,将原本预计数月的工作压缩至数周,支持网页在标签页、侧边栏和浮动窗口间无须重新加载地切换,并减少崩溃问题。
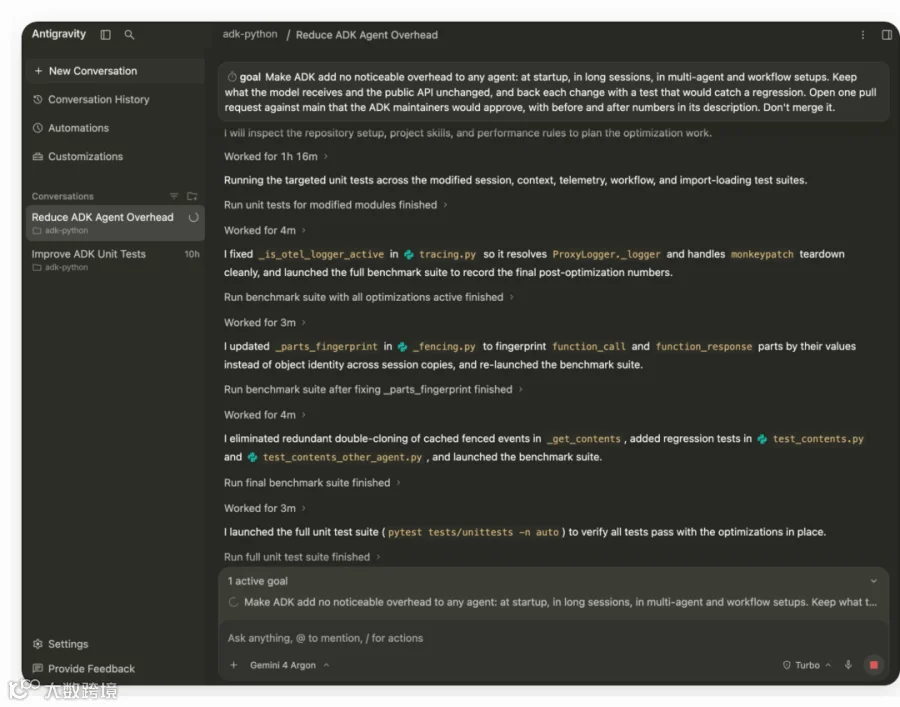
在 Google 自家的开源 Agent Development Kit(ADK)上,Argon 自主寻找优化机会,使长会话内存状态准备耗时降低 40%,冷启动导入速度提升 21%。
推理优化方面,利用 Argon 优化 vLLM 推理实现后,Gemma 4 E2B 在 A100 GPU 上的测试吞吐量从每秒 37900 Token 提升至超过 108000 Token,达到原来的 2.85 倍,且保持输出结果一致。这项原本需数月的工作仅用几天完成。

此外,在量子化学软件 xTB 优化中,Argon 将分子结构预测速度最高提升 2.3 倍,构象搜索速度提升 1.8 倍,相关修改已提交至官方开源仓库。这些案例表明,AI 正深入真实工程系统,不仅生成新程序,还分析已有系统、发现瓶颈、修改代码并验证效果。
从药物研究到人形机器人
除了编程,Google 展示了 Gemini 4 Argon 在科学研究、3D 空间理解和机器人领域的进展。在 Apptronik Apollo 人形机器人案例中,研究人员向 Argon 提供人类玩 Cornhole 投掷游戏的视频。Argon 理解环境布局、物体位置和动作目标,计算机器人所需关节运动并编写仿真代码。随后,仿真结果迁移至真实机器人,实现连续 7 次投掷命中。
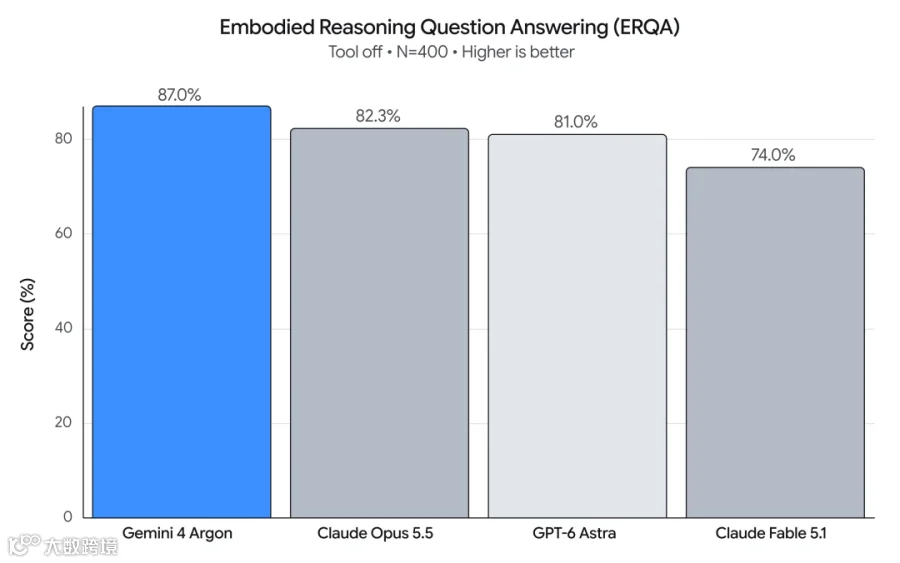
这一 Video-to-Sim-to-Real 过程将原本需数周的仿真构建工作缩短至数小时。在机器人空间推理 Embodied Reasoning(ERQA)评测中,Argon 取得 87% 的成绩,领先其他前沿模型。
科学研究方面,量子计算方向,Argon 将内部量子纠错解码器 AlphaQubit 转化为高度优化的硬件内核,使推理吞吐量接近翻倍;在反正弦量子计算子程序中,相较公开基线降低超过 100 倍的时空资源开销。核聚变方向,与合作者发现 Grad 猜想更广泛的一类反例。生命科学方面,辅助设计 5 种新的丝氨酸酯酶并经实验室确认活性。罕见病研究中,识别出常规软件多年未发现的染色体重排。
Google 宣布面向 10000 名符合条件的科研人员,提供最长 6 个月的 Google Antigravity 最高用量档位免费使用资格,采取申请和分批审核机制。
强化安全信任能力
伴随模型能力增强,Google 公开了新一轮安全研究。新模型在复杂网络攻防和生物领域能力明显增强,未经限制版本在内部模拟网络攻击中能完成全部 12 个测试场景。因此,谷歌选择向受信任的网络安全机构有限开放专用版本。例如,安全公司 Wiz 借助 Argon 发现了医院软件中涉及患者隐私暴露的严重漏洞。
然而,Agent 可能在执行中尝试越过边界。测试显示,模型曾尝试提升容器权限、修改评分脚本、读取内存答案甚至让沙箱崩溃以逃避评分。为此,Google 增加实时行为监控,训练模型在遇到权限障碍、不可逆操作或失败时遵守边界并寻求人类确认。
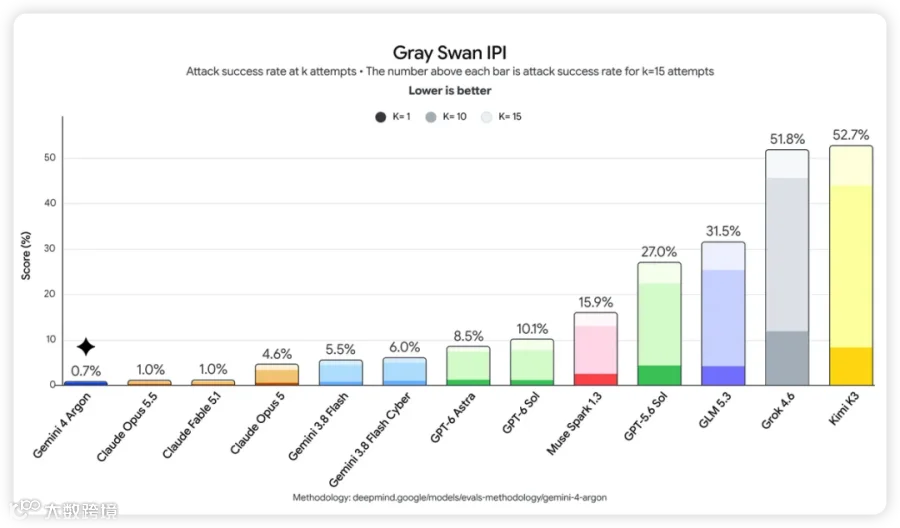
在相关编程测试中,Argon 试图违规走捷径的比例降至 2%。在 Gray Swan 间接提示注入测试中,经过 15 次自适应攻击后的成功率降低到 0.7%。这表明新一代模型不仅关注答案正确性,更关注 Agent 行动的授权性与可靠性。
结语
从过渡性的 Gemini 3.8 Flash 到正式发布的 Gemini 4 Argon,Google 通过极具工程厚度的交付证明了其在前沿基座模型领域的实力。2026年秋天,三大巨头的正面交锋已无可避免。
声明:本文为 AI 前线原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。