


将 ScienceAI设为星标
第一时间掌握
新鲜的 AI for Science 资讯
编辑丨&
设计具有潜在药理活性的分子仅是药物研发的起点。候选分子的可合成性及反应位点预测,直接决定其能否进入后续研究。特别是在先导化合物优化阶段,研究人员需在已有骨架上进行局部改造,快速获取一系列结构相近但性质各异的候选分子。
C–H 硼化反应是重要的分子改造手段,能将碳氢键转化为含硼官能团,为后续交叉偶联等反应提供位点。然而,对于包含多个相似碳氢键的复杂分子,准确预测反应可行性及具体发生位置极具挑战。
10 月 9 日发表于《Nature Computational Science》的研究「Advancing chemical reaction prediction in data-scarce drug discovery with active and geometric deep learning」中,瑞士苏黎世联邦理工学院(ETH)与罗氏创新中心团队提出了一种结合主动学习与几何图神经网络的闭环框架。该流程通过模型筛选实验、实验结果反哺模型更新,实现了对药物分子反应结果与位点的高可靠预测。
论文链接:https://www.nature.com/articles/s43588-026-01063-0
赋能闭环学习框架
化学反应预测模型依赖充足且结构多样的实验数据,但高通量实验成本高企,盲目扩大规模不可持续。研究团队首先解决了数据效率问题。
团队整理了覆盖 518 种底物的初始数据集,包含 2,044 组高浓度基因检测(HTE)数据点。利用 XGBoost 集成模型,基于分子 ECFP4 指纹特征预测底物在特定条件下是否发生硼化。此阶段任务聚焦于判断反应成败,而非直接预测产率或位点。

图 1:主动学习工作流程与神经网络架构。
经对比 Random Forest、CatBoost 和 XGBoost,团队因 XGBoost 在分类性能及不确定性校准方面的优势而选用该模型。
随后,模型介入实验选择。团队从罗氏拥有的 22,253 种类药物芳香族化合物中筛选候选底物,采用主动学习策略,优先选择能提供新信息、拓展模型认知边界的分子。通过 BALD 采集函数考量模型不确定性,引导实验从已知结构向数据稀缺的化学区域扩展。

图 2:通过主动学习对化学空间的前瞻性穿越。
经过三轮实验,团队筛选出 50 种新底物,并在不同条件下开展实验。新结果被重新加入数据集用于下一轮训练。仅主动学习阶段便产生 4,821 组反应结果;结合初始数据,总计获得 6,865 组反应结果,覆盖 568 种独特底物。
高精度二元反应预测
随着主动学习扩充数据集,研究团队引入几何图神经网络(GNN以提升预测精度。
相较于仅依赖分子指纹的分类模型,几何图神经网络将分子表示为由原子和化学键构成的图,并利用原子三维坐标表征空间结构。通过特定的几何结构设计,模型在处理分子旋转、平移及原子排列变化时,能有效保留与反应相关的关键信息。
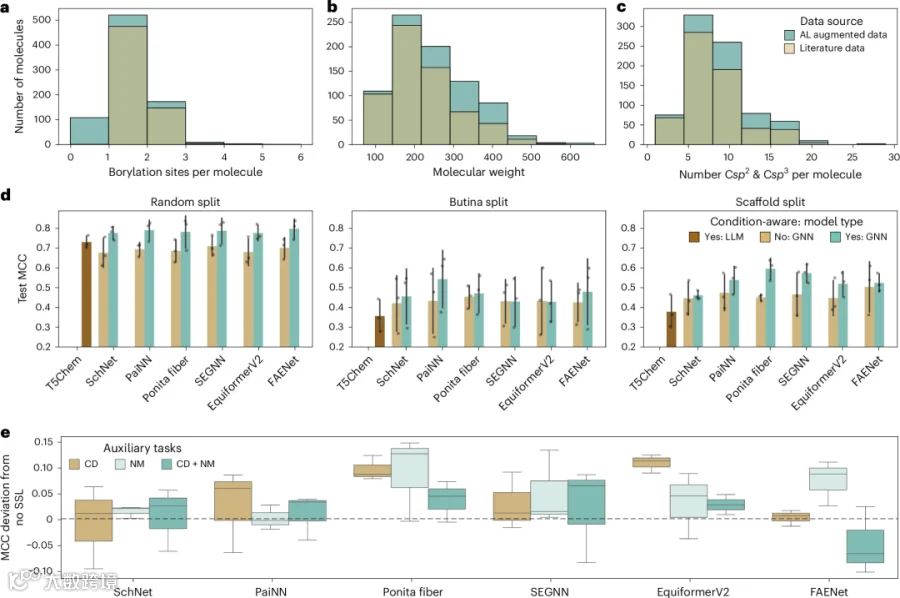
图 3:博里化的区域选择性。
团队还引入了节点遮蔽和坐标去两种自监督辅助任务。前者要求模型根据周围信息恢复被遮蔽的原子类型,后者让模型从扰动坐标中恢复原有空间结构。这些任务为模型提供了额外训练信号,降低了对带标签数据的完全依赖。
结果显示,随着数据扩充,几何图神经网络表现显著提升。在更具挑战性的骨架划分测试中,最终轮训练后,几何图神经网络的马修斯相关系数(MCC)平均约为 0.43 至 0.50,优于表现最佳的 XGBoost 模型(0.35 ± 0.12)。
实现复杂分子支架的快速多样化
该研究将主动学习的实验选样、数据积累与几何深度学习的位点预测整合为完整流程。前期利用轻量级模型筛选高价值实验,后期利用扩充数据训练能处理三维结构的模型,并在新底物上验证预测效果。
尽管当前研究聚焦于 C–H 硼化这一特定反应,未直接证明模型可预测各类反应产率或替代完整合成流程,但其展示了一种实用的工作范式:通过模型辅助优化实验资源投放,再经由真实实验不断修正模型对化学反应的理解,从而加速药物发现进程。
人工智能 × [ 生物 神经科学 数学 物理 化学 材料 ]
「ScienceAI」关注人工智能与其他前沿技术及基础科学的交叉研究与融合发展。
欢迎关注标星,并点击右下角点赞和在看。