


写在前面
目前关于Stable Fluid的NS流体和SPH/PBF粒子流体的资料较多,但经典的FLIP(Fluid-Implicit-Particle)方法相关实现较少。本文旨在填补这一空白,重点着眼于Unity中Compute Shader的工程实现,而非公式推导。
作者在RTX 4070显卡上,使用一次MGPCG求解,实现了规模达400万粒子和400万网格(256x128x128)的FLIP流体模拟,运行帧率约为140 FPS,单步耗时约7ms。
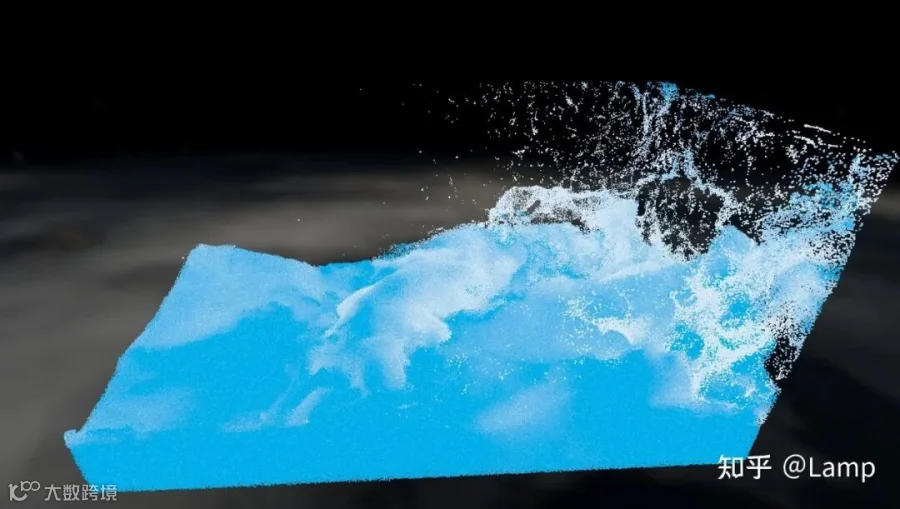
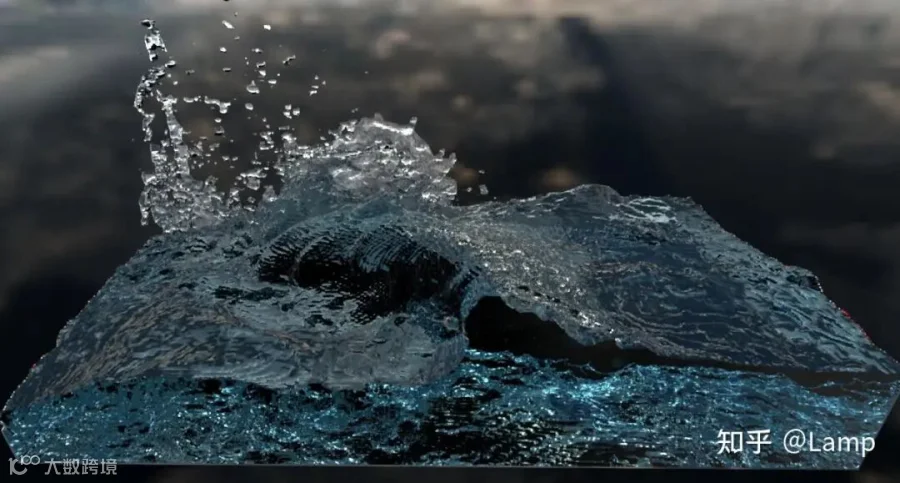
注:工程需开启DX12,目前仅在Nvidia显卡(测试环境为RTX 4070,Wrap线程数32)上验证通过。
FLIP算法简介
FLIP是一种混合欧拉-拉格朗日算法,结合了拉格朗日粒子与欧拉网格的优势:
相较于纯网格方法,FLIP解决了对流计算的数值耗散问题;相较于纯粒子方法,它具备欧拉方法的稳定性且求解更高效。
算法核心流程分为三步:
1. 粒子到网格 (P2G)
将离散粒子的速度和位置信息插值传递至固定背景网格,构建加权平均速度场,为后续计算做准备。
2. 网格求解
在网格层面求解纳维-斯托克斯方程的压力投影部分,确保流体满足不可压缩性。利用网格优势,采用预处理共轭梯度法(如MGPCG)高效求解压力泊松方程。
3. 网格回粒子 (G2P)
将求解后的网格速度变化量(增量)反馈给粒子。为平衡细节保留与噪声抑制,通常采用FLIP与PIC的混合更新方式(如95% FLIP + 5% PIC)。
压力求解与MGPCG实现
压力求解需在网格上解算压力泊松方程。本文采用交错网格(MAC Grid),其中压力存储在网格中心,速度分量存储在网格面中心。

边界条件处理:
- 固体边界:Neumann边界,相邻面速度设为0。
- 自由表面:Dirichlet边界,大气压设为0。
对于线性方程组 $Ax=b$,由于系数矩阵A对称正定,可采用共轭梯度法(CG)。为解决高分辨率下收敛慢的问题,引入多重网格作为预处理器,即MGPCG(Multigrid Preconditioned Conjugate Gradient)。
多重网格预处理器
多重网格通过“光滑-粗化-修正”循环,有效消除高频误差并加速低频误差收敛。流程如下:
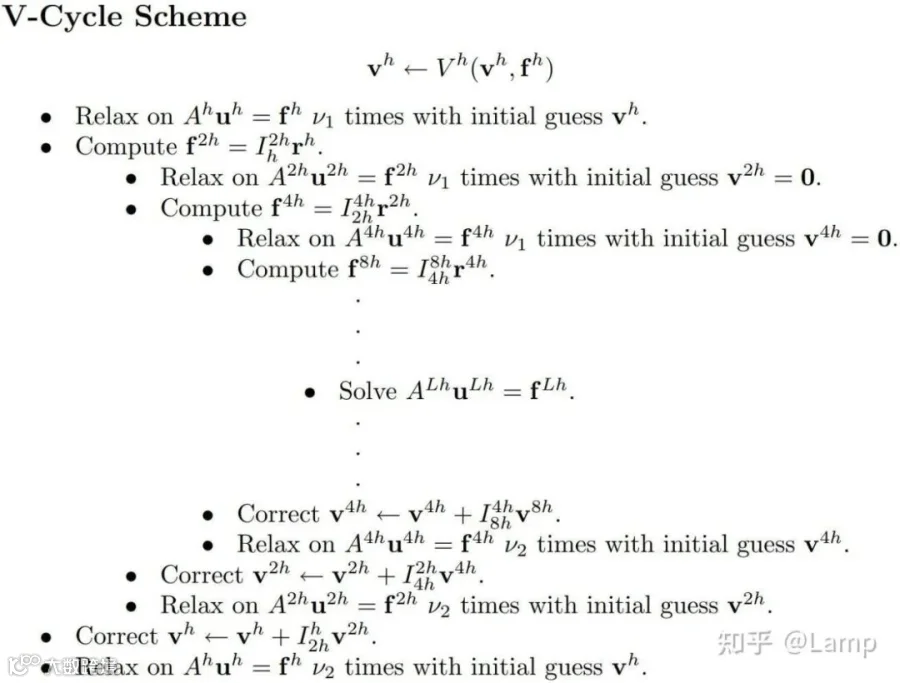
为保持矩阵对称性,采用红黑高斯-赛德尔方法作为光滑器。最佳实践为预平滑和后平滑各迭代3次,且顺序相反。
非平滑聚合代数多重网格 (UAAMG)
UAAMG已成为规则笛卡尔网格流体求解的主流选择。其核心在于粗化过程中不仅限制残差,还通过伽辽金原理粗化泊松系数。

在插值回细网格时,论文建议设置系数 $\gamma=2$ 以补偿误差修正量的低估,从而加速收敛。实测表明,作为预条件器时使用 $\gamma=2$ 效果显著。
最终采用一次MGPCG迭代求解,耗时仅约1.5ms,效果远优于传统迭代方法。
粒子与网格的信息传递
P2G:粒子到网格
P2G的目标是将粒子动量汇聚到网格节点。为保持动量守恒,通常传递动量而非直接传递速度。插值核函数常选用二次或三次B样条。
实现方式主要有Gather和Splat两种,均需对粒子进行基数排序(Radix Sort)以优化内存访问。本文采用GPU基数排序,耗时约1.5ms。
Gather:每个线程处理一个单元格,收集周围粒子累加动量。
Splat:利用Wave Instincts减少共享内存冲突。线程组处理块内粒子,先累加至共享数组再写入全局内存。尽管实现复杂,但在HLSL环境下性能提升有限。
G2P:网格到粒子
G2P将网格上的速度变化反馈给粒子。
- PIC:直接采样网格速度,稳定但存在数值耗散。
- FLIP:采样速度增量叠加至原速度,细节丰富但易产生噪声。
- 混合模式:结合两者优势,常用比例为95% FLIP + 5% PIC。
粒子移动采用四阶龙格-库塔法(RK4)以减少积分误差。
此外,还可引入APIC方法,通过Affine矩阵更精确地传递角动量,但本文未提供GPU实现版本。
参考链接
Unity FLIP Fluid Simulation GitHub项目
[2] A Fast Unsmoothed Aggregation Algebraic Multigrid Framework for the Large-Scale Simulation of Incompressible Flow
[3] GPU Radix Sort 实现详解
[4] 相关视频教程
[5] Cirrus: Adaptive Hybrid Particle-Grid Flow Maps on GPU