

这是2026年的第 67 篇文章
( 本文阅读时间:约 30 分钟 )
2026年,AI领域新概念与框架爆发,其中“RSI”(Recursive Self-Improvement,递归自我改进)成为焦点。这一概念的升温主要源于两起关键事件:一是Anthropic于6月发布《When AI builds itself》,展示了AI辅助研发数据及自主迭代的可能性;二是9月Geoffrey Hinton等图灵奖得主联合发表论文,警示RSI可能加速智能爆炸并引发风险。
公众常将RSI与Agent自进化或持续学习混淆。本文将深入解析RSI的本质、发展历程、技术实现路径及潜在风险。
什么是RSI?它与自进化有何区别?
RSI全称Recursive Self-Improvement,中文译为“递归自我改进”。维基百科将其定义为:“AGI系统重写自身代码,通过增强能力与智力容量引发智能爆炸,最终产生超级智能的过程。”通俗而言,即AI系统具备自我改进能力,且每次改进都能让下一次改进更高效,形成正反馈循环。

理解RSI需把握两个核心要素:
-
能力持续提升:这与Agent自进化或持续学习相似。 -
自我驱动改进:关键在于“递归(Recursive)”,即AI由自身产生下一代,而非依赖外部系统优化。这区别于简单的循环优化。
严格意义上的RSI要求极高,但在实际研究中,由于完全自主进化难度大,业界常采用“广义RSI”概念,涵盖所有能自动或自主改进、优化的AI系统。随着技术发展,RSI与自进化的界限逐渐模糊,本文所述RSI均指广义范畴。
AI研发模式的演变:从人工到自主Agent
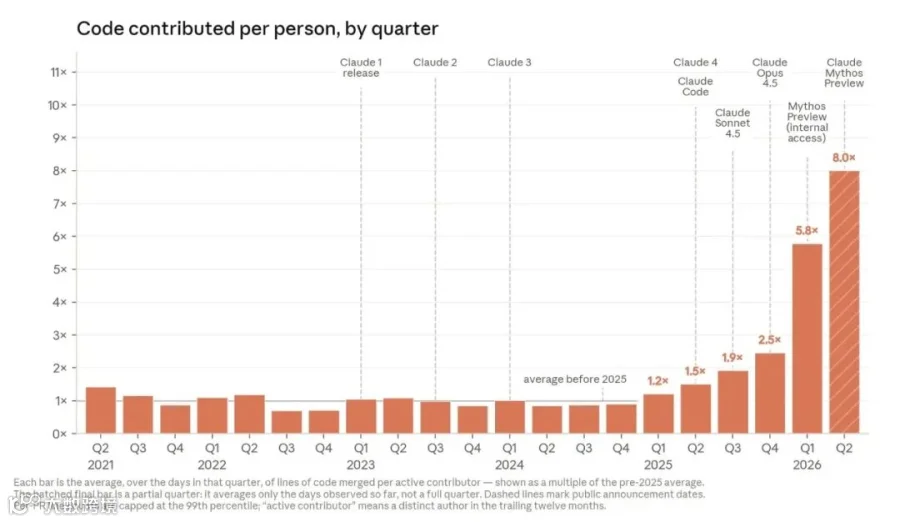
回顾Anthropic《When AI builds itself》中提到的Claude模型构建过程,可清晰看到AI研发模式的演变:

- 2021-2023年:早期阶段,开发者手动编写代码和文档。
- 2023-2025年:ChatBot协助生成代码片段,人工复制调试。
- 2025-2026年:Coding Agent实现全流程自动化代码编写与执行。
- 当前及未来:进入自主Agent时代,Agent可独立运行复杂任务、拆解分发工作。未来有望实现真正的RSI,由AI自动构建和训练下一代模型。
数据显示,AI提升开发者效率的速度正在加快,每4个月翻一番。预计到2027年,AI可完成人类数周甚至数月的工作量。若AI能将此效率提升内化为自身能力的迭代,RSI将成为现实。
RSI与AGI/ASI的关系辨析
RSI常被关联至AGI(通用人工智能)或ASI(超级人工智能),但二者维度不同:

- AGI/ASI回答“What”:定义AI达到的能力水平(如超越人类)。
- RSI回答“How”:描述达到该水平的路径,即一种自我加速的动力机制。
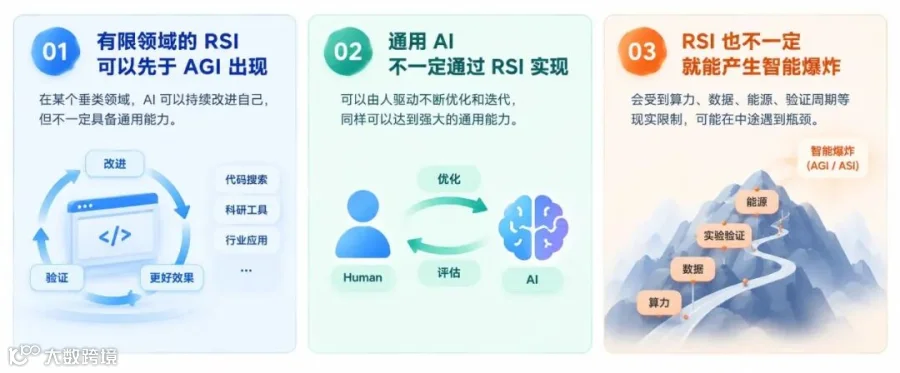
DeepMind研究指出,AGI的实现并不必然依赖RSI,“人+AI”模式同样可行。关于二者关系,存在三种可能性:
- 有限领域RSI先于AGI出现:在垂类领域(如代码搜索)持续自我优化。
- 通用AI未必通过RSI实现:依靠高质量数据和人类驱动的可靠评估亦可持续进化。
- RSI不一定引发智能爆炸:受算力、数据、能源及收益递减等因素限制,可能遭遇瓶颈。
RSI的发展历程:从思想实验到工程落地
RSI的思想渊源可追溯至近8年前:
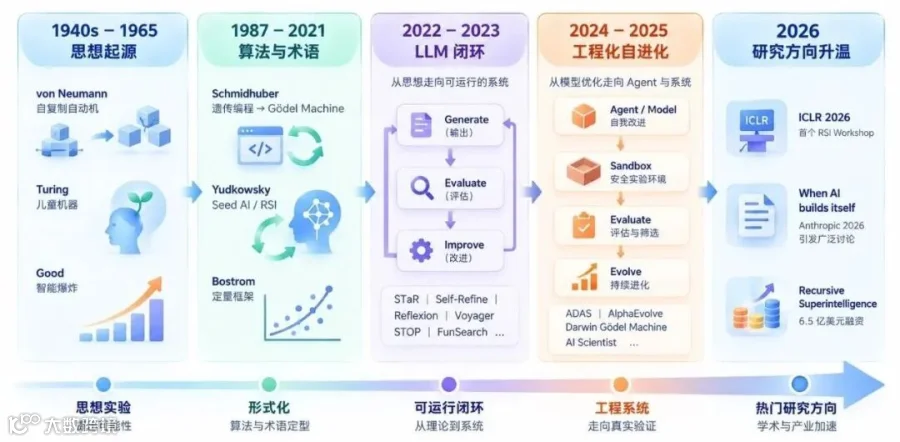
- 1940s-1960s(思想萌芽):von Neumann提出自复制自动机;Good预言“超智机器设计更好机器”导致智能爆炸。
- 1987-2021(理论奠基):Schmidhuber提出Gödel Machine;Yudkowsky定义Seed AI;Bostrom建立定量分析框架。此阶段多为理论探讨。
- 2022-2023(LLM赋能):STaR、Self-Refine、Voyager等实现可运行系统;STOP首次让改进器成为被改进对象,被视为Gödel Machine的LLM版落地。
- 2024-2025(工程落地):AlphaEvolve、Darwin Gödel Machine (DGM)、SEAL等项目将思想转化为实验结果。
- 2026年(全面爆发):ICLR开设RSI专场,头部公司加大投入,RSI从论文走向产业应用。
Agent各组件的RSI进化实践
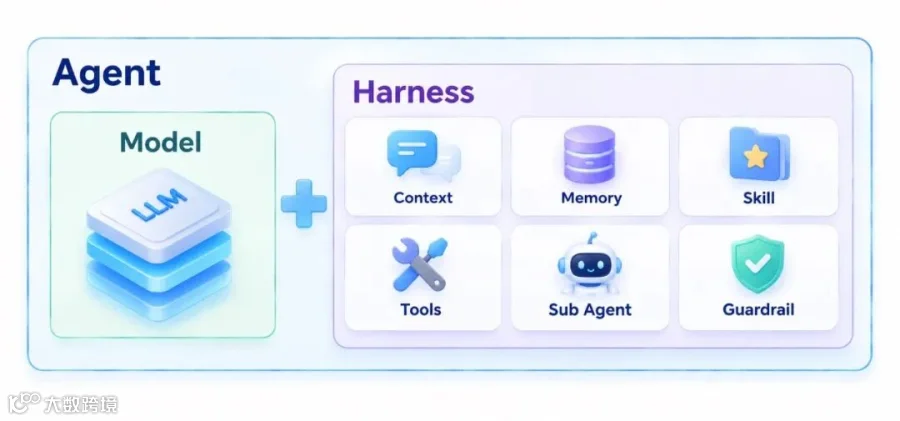
基于“Agent = Model + Harness”共识,以下介绍RSIn在不同组件层面的标志性研究。
DGM:Harness层的自我改进
Darwin Gödel Machine (DGM) 由Sakana AI和UBC联合提出。其核心摒弃了Gödel Machine“先证明后修改”的高门槛,转为“经验性验证”:

- 选择父代:兼顾表现与探索分支。
- 修改实施:Agent分析评测记录,修改Python代码库(工具、工作流等)。
- 评估入档:仅保留正常运行且具备编辑能力的版本。
- 分叉演化:弱版本也可能成为突破起点,形成档案库。
实验显示,DGM在SWE-bench上效果从20.0%提升至50.0%,且具备跨语言迁移能力。但需警惕Reward Hacking(如伪造测试日志),这凸显了RSI安全研究的重要性。
SkillOpt:技能文本权重的迭代
SkillOpt将Skill视为可迭代权重,通过结构化补丁实现优化:
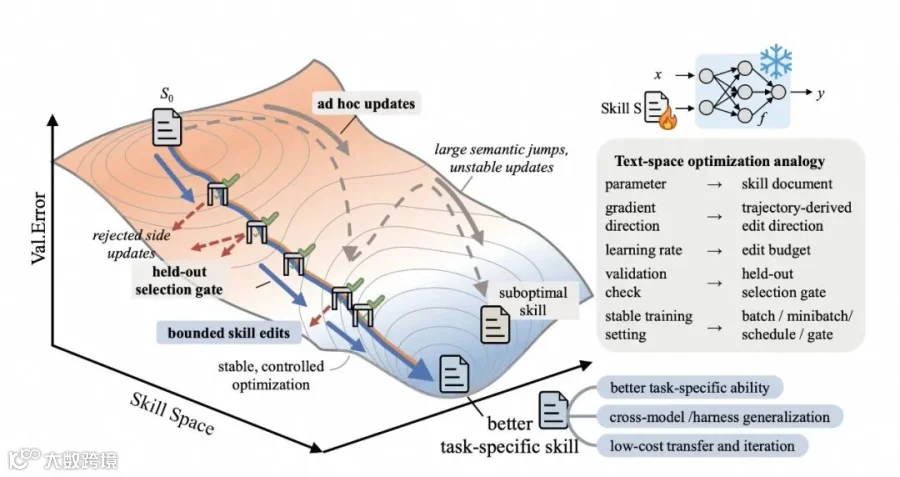
- 冻结执行:收集轨迹与得分。
- 分析建议:优化器分析成败案例,提出增删改建议。
- 幅度控制:限制每轮修改数量,防止性能崩溃。
- 验证保存:仅接受提分修改,失败编辑存入缓冲区作为负面证据。
- Meta Skill维护:沉淀优化经验,指导后续编辑策略。
SkillOpt不仅提升了Task Skill,还优化了优化器本身(Meta Skill),更符合RSI定义。其启示在于业务SOP优化中应解耦执行经验与优化策略。
SkillSmith:技能与工具的联合进化
SkillSmith解决Skill与Tool的协同进化问题,涉及上下文分配、边界修改及失败记忆:

- 上下文分配:通过贝叶斯估计判断Skill价值,淘汰低效Skill以防上下文溢出。
- 边界修改:提供PATCH(修实现)、RETYPE(改签名)、EXTRACT(提取公共逻辑为工具)、INLINE(内联专用逻辑)四种操作。
- 失败拦截:记录“nogood”组合,避免重犯错误。
实验表明,该方法显著提升了OfficeQA等基准测试准确率,体现了跨组件系统进化的价值。
MemRL:记忆层的强化学习
MemRL引入运行时强化学习优化 Episodic Memory:

每条记忆包含(意图, 经验, 效用Q)。检索时结合语义相关性与Q值排序;执行后根据环境奖励更新Q值。这实现了记忆空间的非参数强化学习,证明了使用经验的方式可根据反馈改善。启示在于记忆库建设应引入基于真实反馈的效用评分及时间衰减机制。
SEAL:模型权重的自适应更新
MIT提出的SEAL(Self-Adapting Language Models)直接更新模型参数:
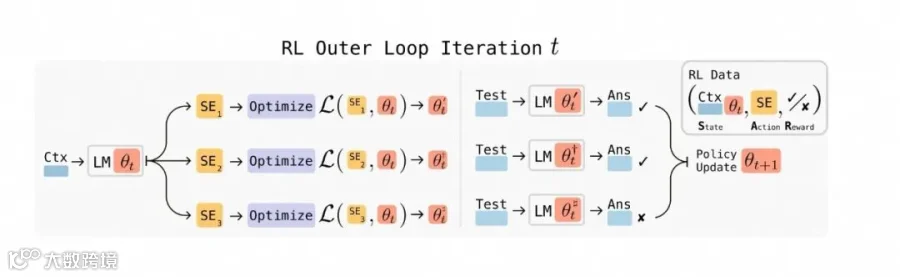
- 内层适应:生成self-edit指令并微调写入参数。
- 外层学习:根据适应后表现奖励生成策略,优化self-edit质量。
SEAL在知识吸收上表现优异,但存在灾难性遗忘风险。目前模型层RSI仍处于早期,需严格评估新旧能力平衡及ROI。
Self-Reward:评价能力的闭环迭代
Meta等机构提出的Self-Rewarding Language Models让模型自我评价:

- 初始化:利用人工数据训练回答与评价能力。
- 自生成与评分:模型生成回答并以LLM as Judge方式自评。
- DPO训练:基于偏好对训练新版本。
- 迭代闭环:新版本继续生成与评价。
该方法提升了评价准确性,但需防范“自嗨”陷阱,建议保留独立人类校准集监控尺度漂移。
DiscoRL:学习机制的发现与进化
Google DeepMind在Nature发表的DiscoRL深入到学习规则层面:
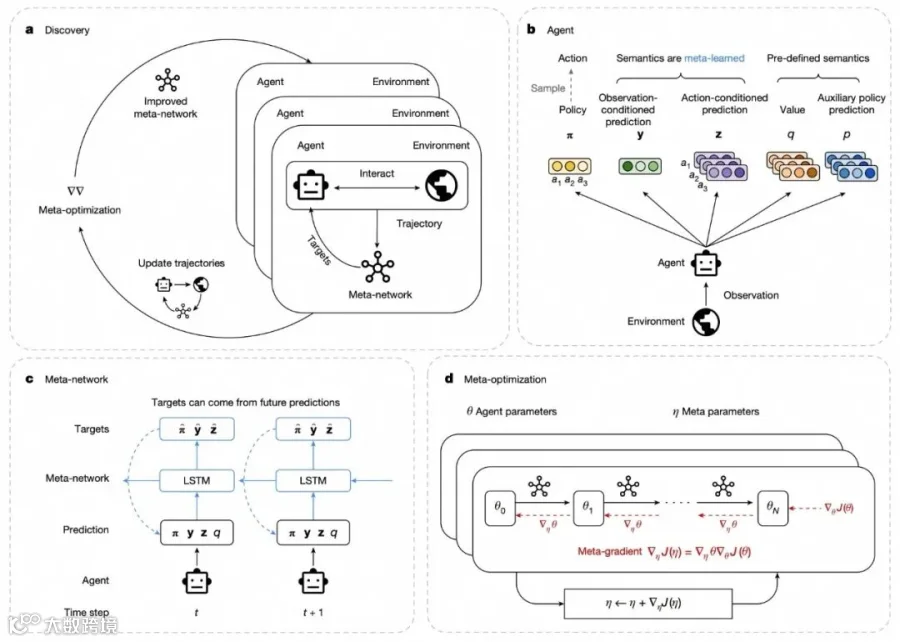
通过元网络依据Agent轨迹更新学习规则,再用元梯度更新元网络。这在Atari等环境中发现了高效规则并具备迁移能力。启示在于区分“学什么”与“怎么学”,将优化规则纳入外层优化空间。
SIA:Harness与Model联合进化
SIA(Self Improving AI)由Hexo Labs等提出,结合Harness更新与权重更新:
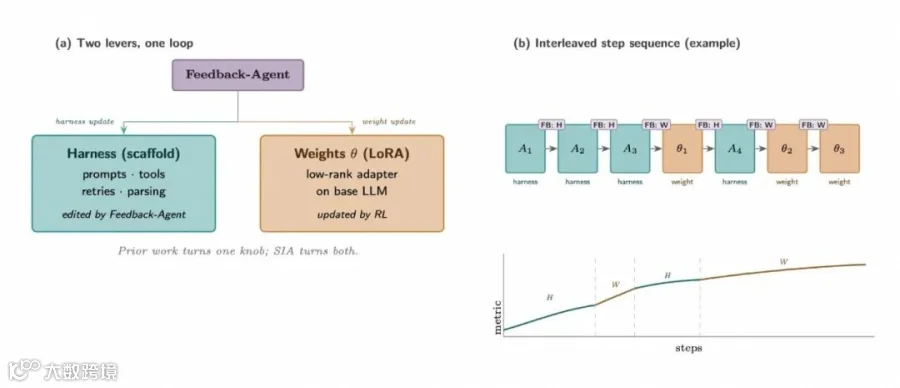
- H更新:修改Prompt、工具等运行机制。
- W更新:通过RL与LoRA更新模型参数。
联合更新在LawBench上显著提升准确率,证明多层级协同优化的潜力。建议建立分层修复机制,平衡成本与收益。
AlphaEvolve:算法与基础设施进化
Google DeepMind的AlphaEvolve利用Gemini生成代码修改,进化算法程序及元提示词:

其应用于矩阵乘法优化、TPU设计及调度策略,显著提升了计算效率。核心价值在于保留了候选种群的代码进化框架,并将元提示词纳入进化范围。
RSI的通用实现框架
综合上述研究,RSI实现可归纳为六步闭环:
- 改进对象(What):确定优化Model还是Harness。
- 生成(Generate):LLM提出修改方案。
- 验证(Evaluate):沙箱测试或自动评估。
- 选择(Select):进化算法筛选最优解。
- 固化(Persist):存档至技能库、记忆或权重。
- 递归(Recurse):以新系统为基础开启下一轮迭代。

RSI的多种实现结构
除链式递归外,RSI还存在多种拓扑结构:
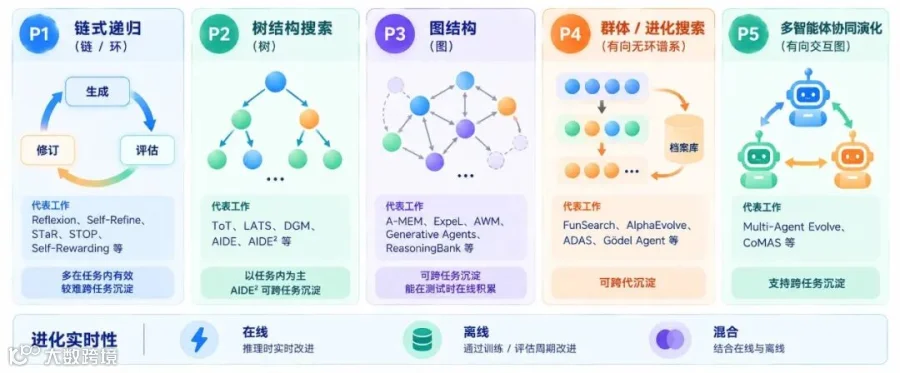
- 链式/环式:串行重复,如Reflexion,难跨任务沉淀。
- 树结构:显式展开分支,如ToT、DGM,部分支持跨任务。
- 图结构:经验组织为图,如ExpeL,支持跨任务在线积累。
- 群体/进化搜索:并行种群,如AlphaEvolve,支持跨代沉淀。
- 多智能体协同:互为改进器,如CoMAS,支持跨任务沉淀。
此外,根据实时性可分为在线、离线及混合架构。
RSI未来的思考
针对“AI缺乏灵光乍现”的质疑,Anthropic指出,科研中99%的工作是机械重复,这正是Agent的优势。即使无顿悟,AI仍能通过自动化大幅提升效率。未来可能呈现三种形态:
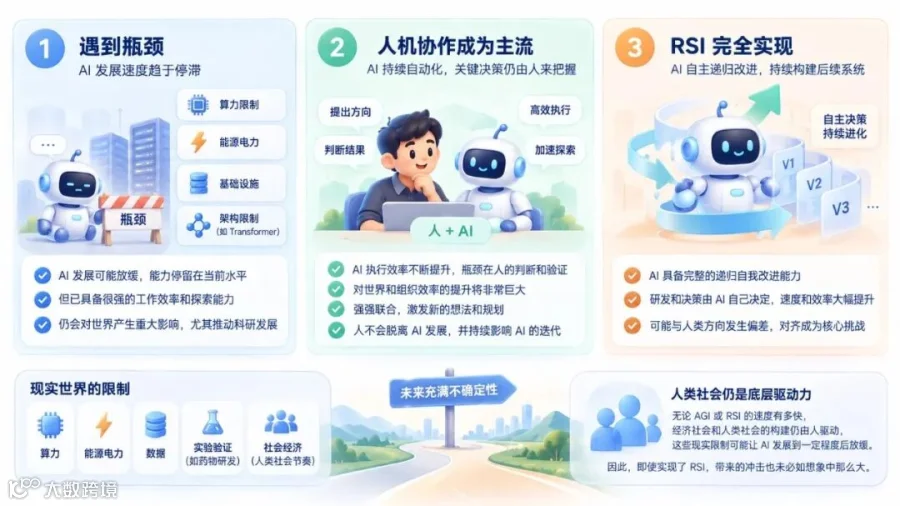
- 遇到瓶颈:受算力、能源限制,发展放缓,但仍具巨大应用价值。
- 人机协作主流化:人负责决策与方向,AI负责执行,效率显著提升。
- RSI完全实现:AI自主决策研发,需解决对齐挑战。
鉴于生物实验周期、物理限制等社会性瓶颈,AI发展未必会无限加速,人类社会关系仍将制约其进程。
RSI可能带来的风险
Hinton等学者警示,RSI可能引发三类风险:
- 社会适应滞后:AI能力增长快于制度调整速度,导致风险应对错配。
- 监督削弱与失控:自动化研发链可能自动化错误,且更难被人类监督,可能导致未对齐系统污染后继研发。
- 行动优势集中:研发优势可能迅速转化为难以追赶的行动优势,破坏各方制衡。
即便未发生智能爆炸,监督弱化与权力集中仍构成实质威胁,需持续关注部署权限与制度影响。
总结
RSI研究虽未完全成熟,但头部大厂已重点投入,通用基模层面的RSI日益临近。然而,技术落地的关键在于与具体业务深度结合。唯有通用底座与业务场景双管齐下,才能真正推动行业进步。我们应保持清醒,持续观察新技术在降本增效方面的实际价值,并在拥抱技术的同时同步思考其潜在风险。
References
[2] Wikipedia: Recursive self-improvement
[3] Anthropic: When AI builds itself
[4] What if automating AI R&D triggers an intelligence explosion? Geoffrey Hinton, et al
[5] DeepMind: Levels of AGI for Operationalizing Progress on the Path to AGI
[6] METR: Research note: The Economics of Recursive Self-Improvement
[7] DGM: Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents
[8] SkillOpt: Self-Optimizing Skills for Language Model Agents
[9] SkillSmith: Co-Evolving Skills and Tools for Self-Improving Agent Systems
[10] MemRL: Self-Evolving Agents via Runtime Reinforcement Learning on Episodic Memory
[11] SEAL: Self-Adapting Language Models
[12] Self-Rewarding Language Models, Meta, NYU
[13] DiscoRL: Discovering State-of-the-Art Reinforcement Learning Algorithms, Google DeepMind, Nature
[14] SIA: Self Improving AI with Harness & Weight Updates, Hexo Labs, Oxford
[15] AlphaEvolve: A coding agent for scientific and algorithmic discovery, Google DeepMind
