


在 Anthropic 等闭源模型厂商收紧 AI 辅助生物探索权限的背景下,开源社区迎来了重要突破。10 月初,Hugging Face 的生物研究团队 HuggingFaceBio 正式发布开源基因注释模型 Carbon-A,并同步公开了基于该模型生成的 Carbon 注释数据库(CADB)。
CADB 收录了 48,167 个基因组组装和 22,617 个分类单元,涵盖约 27 万亿个碱基对,预测出约 5.66 亿个蛋白编码位点。相较于训练数据源 NCBI RefSeq,CADB 的分类单元数量约为其 11 倍,序列量约为 9 倍,预测基因候选数约为 16 倍。这一成果将原本耗时数月的物种注释工作压缩为一次查询请求,首次为两万多物种提供了标准统一的基因图谱。
Hugging Face 指出,生物学正成为继网络安全和数学之后的 AI 新前沿,并预测“2027 年将是属于生物的一年”。作为开源托管领域的代表,Hugging Face 的此次行动进一步印证了行业对 AI 生物学的高度押注。
测序数据激增与解读滞后的矛盾
Carbon-A 旨在弥合基因组学中测序通量飞速提升与人类解读能力滞后之间的巨大鸿沟。
随着因美纳新一代测序平台将人类全基因组测序成本降至约 200 美元,以及长读长技术的成熟,高质量基因组组装数据迅速积累。然而,测序产出仅为由四个碱基组成的超长字符串,缺乏功能性标注。
基因注释需标出基因位置及翻译片段,是生物功能研究、演化分析及药物靶点发现的基础。目前主流注释方法依赖转录组数据、已知蛋白及专家人工校对,不仅速度缓慢,且证据分布在模式生物与非模式生物间极不均衡。
Carbon-A:从头预测跨越生命树
Carbon-A 采用 12 亿参数模型进行“从头预测”,仅依据 DNA 序列即可覆盖哺乳动物、脊椎动物、无脊椎动物、植物、真菌和原生生物六大类群,无需额外实验证据。
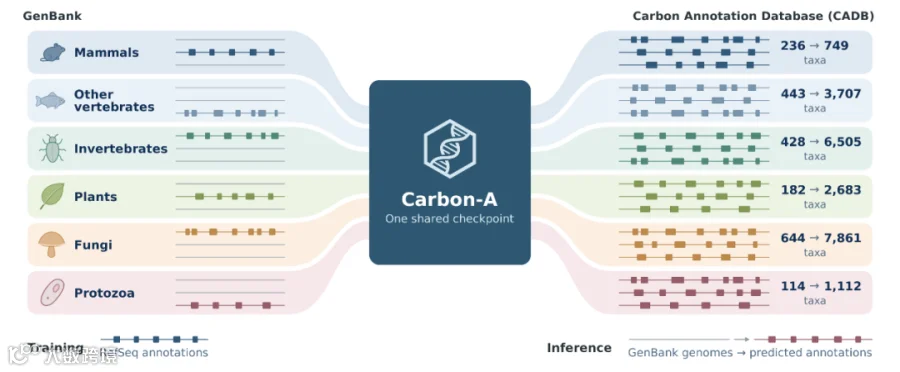
(来源:Hugging Face)
该模型底座源自阿里云和中关村学院等机构发布的 GENERator,经改造为双向注意力编码器。它将每 6 个碱基合并为一个 Token,支持 98,304 个碱基对的读取窗口。输出端通过正负链分类头逐个碱基计算编码序列概率,并经后处理管线生成完整基因模型及置信分。
在 42 个基准基因组测试中,Carbon-A 的宏平均核苷酸级 F1 值达到 0.944,在核苷酸、外显子及基因层级上均超越 AUGUSTUS、Helixer 等主流工具。即便在最严苛的基因级标准下,其 F1 值仍保持在 0.74 左右。
压力测试显示,Carbon-A 具备出色的跨物种泛化能力。在仅用动物基因组训练的情况下,其对未见过的植物物种标注表现优异;对于遗传密码特殊的嗜热四膜虫,其核苷酸级 F1 值亦达到 0.960,证明模型习得的是编码序列底层规律而非机械记忆。
超越参考库:模型发现遗漏基因
针对参考注释本身可能存在缺陷的问题,研究团队利用新版猪基因组组装进行了验证。结果显示,使用 2017 年版数据训练的模型,在 2026 年版高质量组装上的表现反而更优,显示出模型对基因组理解的深度可能超越传统静态标签。

(来源:Hugging Face)
Hugging Face 联合加州大学圣迭戈分校等机构,对猫、叙利亚仓鼠、鸡和拟南芥进行 PacBio 全长转录本测序验证。结果发现,239 个未被 RefSeq 收录的候选基因获得了 RNA 证据支持,Carbon-A 预测的完整编码序列获转录组支持的比例约为 0.62,显著高于其他工具。
这一结果改变了以参考库为绝对标准的传统评价体系,表明即使是经过数十年人工注释的数据,仍存在大量遗漏。团队计划后续通过核糖体图谱和质谱进一步验证这些序列的蛋白翻译及功能。
开源策略:安全与效率的平衡
尽管华大研究院 OrionGeno 和西安交大 ANNEVO 等模型在注释速度上已有显著提升,但大多需研究者手动部署。Carbon-A 的优势在于直接提供覆盖两万多个物种的可查询公共数据库,每条预测均包含组装编号、坐标、序列及置信分。
Hugging Face 选择全面开放模型与数据,旨在避免科研生态对封闭前沿模型的过度依赖。团队指出,Carbon-A 仅回答“基因在哪里”,不涉及 DNA 设计或功能预测,安全风险极低,开放收益远大于潜在隐患。
目前,Carbon-A 主要适用于真核生物编码区预测,尚无法解析可变剪接和多转录本。团队已将显式建模多转录本列为下一步重点,并计划在三周后发布下一批覆盖 GenBank 剩余一半基因组的数据。
随着“找基因”变得便捷,生命科学的门槛正转向功能揭示。面对模型生成的 5.66 亿个候选位点,现有的核糖体图谱、质谱等实验验证手段通量仍显不足。AI 生物学的真正爆发,有待于实验自动化能力的同步提升。