

企业 AI 的核心挑战已从“模型能否回答”转向“AI 能否在真实业务场景中安全执行”。
一位安全专家曾指出:“比起 AI 说错话,更可怕的是 AI 错误分配工单。”这揭示了企业 AI 项目的演进路径:从接入大模型、构建 RAG 到开发 Agent,如今已进入生产环境深水区,面临“如何让 AI 真正办事”的难题。
以“分配高危漏洞”为例,落地时需解决定义标准、数据一致性、权限校验、日志审计等复杂问题。因此,研究 Palantir Ontology 至关重要,但需纠正一个误区:Ontology 并非知识图谱的简单更名。
Palantir 将 Ontology 定义为企业的运营层(Operational Layer),整合了数据、逻辑、动作与安全。本文将聚焦于 Ontology 的工程化落地实践。
本文看点
01
Ontology 四层拆解
02
LLM 只能“申请”执行
03
先跑通一个业务闭环
WHY NOT ENOUGH
有图、有 RAG、有 Agent,为什么还是不够?
大型企业虽具备 CRM、ERP、RAG 等组件,但往往缺乏连接底层数据库与上层 Agent 的关键层级。该层级需完成三项核心任务:
1. 语义翻译:将技术数据(如 cust_id)转化为业务概念(如客户、责任人),建立语义建模。
2. 能力封装:将业务逻辑封装为可调用接口(如 AssignWorkOrder),使 AI 调用的是业务能力而非直接操作数据库。
3. 受控执行:通过参数校验、权限检查、状态验证及审批流程,确保执行安全可控。
完整链路应为:
自然语言 → LLM → 业务意图 → Ontology → Function/Action → Policy/Permission → 业务规则 → 执行 → 审计
这与简单的“LLM+Tool Calling”存在本质区别,属于更高的工程层次。
ONTOLOGY VS KG
Ontology 和知识图谱,到底差在哪儿?
知识图谱擅长组织关系(如三元组关联),GraphRAG 擅长从非结构化文本中挖掘关系。而 Ontology 关注企业世界的运行逻辑,核心在于业务实体(如 Customer、Order)及其对应的动作(如 CreateOrder、AssignWorkOrder)。
「GraphRAG 关心知识怎么关联,Ontology 关心业务世界怎么运行。」
两者可并存:GraphRAG 补充知识,Ontology 支撑操作,共同服务于 Agent。
FOUR LAYERS
把 Ontology 拆成四层来看
从工程角度,Ontology 由以下四层构成:
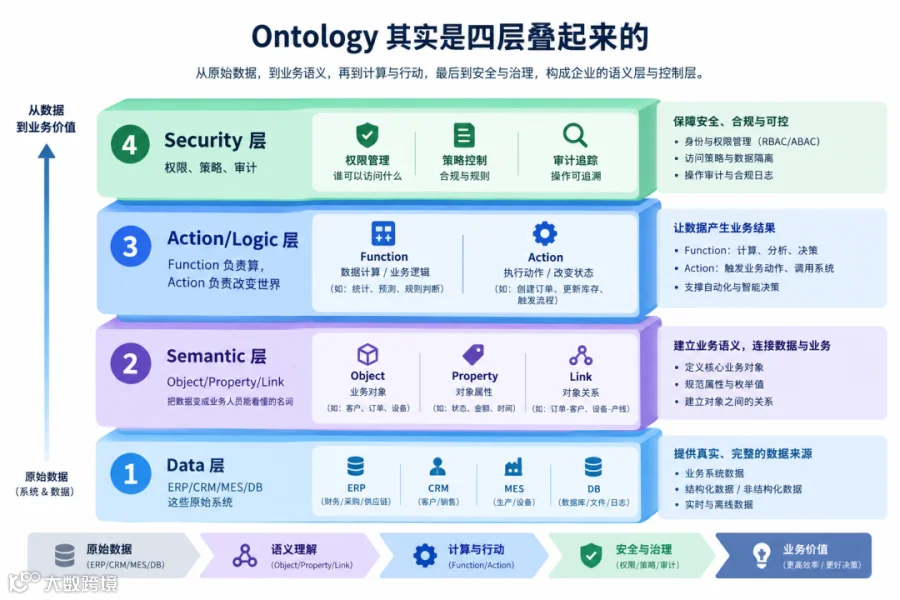
Data 层:ERP、CRM、MES 等原始系统。
Semantic 层:Object、Property、Link,将数据转化为业务名词。
Action/Logic 层:Function 负责计算,Action 负责改变状态。
Security 层:涵盖权限、策略及审计。
Ontology 的目标已从优化数据展示转向对企业决策过程的建模。
BUILD ON EXISTING
别推倒重来,让 Ontology 长在现有数据之上
避免新建全套数据平台导致项目周期过长。应映射已有数据资产,例如将 work_order 表映射为 WorkOrder 对象,保留原有业务系统,仅在之上叠加业务语义和执行能力。
NOUNS & VERBS
名词和动词:Object、Link,然后是 Function、Action
Ontology 基础包含 Object、Property、Link,对应面向对象编程中的类、字段和引用。但仅有静态结构无法产生业务价值,必须引入动词:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Object 是企业的名词,Action 是企业的动词。
Function 负责计算(如风险评估),Action 负责改变世界(如升级漏洞状态、建工单)。工程上,Function 处理查询与评估,Action 处理创建、修改及流程触发。
REQUEST VS EXECUTE
LLM 只能“申请”,平台才能“执行”
LLM 生成的请求需经过严格校验链路:
LLM 生成 Action Request → Schema 校验 → 权限检查 → 前置条件 → 业务规则 → 人工审批 → 执行 → 审计
LLM 仅作为意图解析器,最终执行权在平台。Schema Validator 如同编译器,对中间代码进行语法、类型、权限及业务规则检查。
建议将校验结果分为四档:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
SYSTEM OF RECORD
业务系统才是“事实”,Ontology 只是它的投影
ERP、CRM 等业务系统是记录系统(System of Record)。Ontology 应作为统一语义和编排层。修改数据时,应先写入业务系统,成功后再同步至 Ontology,以避免数据不一致。
一致性策略需分级:历史数据允许最终一致,关键状态(如库存、审批)需实时读取。可通过标记 consistencyLevel 平衡风险与性能。
SUBGRAPH SPLIT
子图别按数据源切,按业务闭环切
避免按 CRM、ERP等数据源划分子图,应按业务闭环(如安全运营、供应链)划分。这有助于 Agent 跨系统回答问题,并实现天然的权限隔离。
SEMANTIC ROUTING
别把整个 Ontology 一股脑塞给 LLM
全量 Schema 会导致上下文过长且效率低下。应建立语义路由链:用户提问 → 意图路由 → Ontology 检索 → 上下文组装 → 规划 → 校验 → 执行。
关键在于优化语义描述(Semantic Description),确保 AI 能准确召回相关结构。每个 Ontology 元素都应具备丰富的语义标签。
NOT EITHER-OR
GraphRAG 和 Ontology,从来不是二选一
GraphRAG 适用于非结构化知识(文档、合同),Ontology 适用于结构化业务操作。两者可并存,分别作为知识平面和操作平面。
MCP 作为连接层,暴露工具接口;Ontology 作为业务语义层,定义可调用的能力;底层系统负责执行。三层架构清晰分离。
AS SOFTWARE ENGINEERING
把 Ontology 当软件工程,不是当一份配置文档
Ontology 应纳入软件工程流程:定义 → Git 版本管理 → Review → 测试 → CI/CD → 部署。Action 需包含输入 Schema、前置条件、权限、业务规则及审计,公式为:
Action = API + Policy + Business Rule + Audit
通过完善的测试(对象、链接、函数、动作、权限),精准定位错误源头,避免归咎于模型幻觉。
START SMALL
别一上来就想建“企业全量 Ontology”
建议从单一业务闭环入手,如安全漏洞处置。初期仅构建少量 Object、Link、Function 和 Action,快速验证业务价值,避免陷入大规模建模泥潭。
FULL CASE
完整案例:AI 自动处理高危漏洞是怎么跑通的
以“分配超时高危漏洞”为例:系统识别意图,检索相关对象,调用函数筛选符合条件的漏洞,沿链路查找负责人,生成行动计划。经校验对象存在性、权限及当前状态后,执行分配或转入审批,并全程记录审计日志。
SIMULATE FIRST
往前一步:先模拟,再执行
对于高风险决策,应在隔离场景(Scenario)中进行模拟执行,评估结果并经人工确认后,再合并至主 Ontology。这是保障生产安全的必要步骤。
ASK THE BUSINESS
真正难的从来不是技术,是把业务问明白
Ontology 建模的核心在于厘清业务定义。建议步骤:
确定 AI 需完成的具体任务。
梳理数据骨架,明确主数据源及 ID 映射。
先构建静态结构,再逐步添加动态能力。
每步均通过测试验证后再投入生产。
THE END
几条红线,与一道分水岭
最后强调四条红线:
LLM 严禁直接访问生产数据库,必须通过业务能力与策略执行。
图数据库不能作为事实主库,业务系统才是。
敏感数据严禁无条件传入 LLM 上下文。
避免大而全,优先跑通单一业务域。
Ontology 的本质是将企业世界转化为 AI 可理解、推理并在约束下安全执行的运行环境。这是企业 AI 从“问答”走向“业务参与”的关键分水岭。
「Ontology 不是把企业数据画成一张图,而是把企业世界变成一个 AI 能理解、能推理、能调用,并且在权限和规则约束下能安全改变的运行环境。」
END