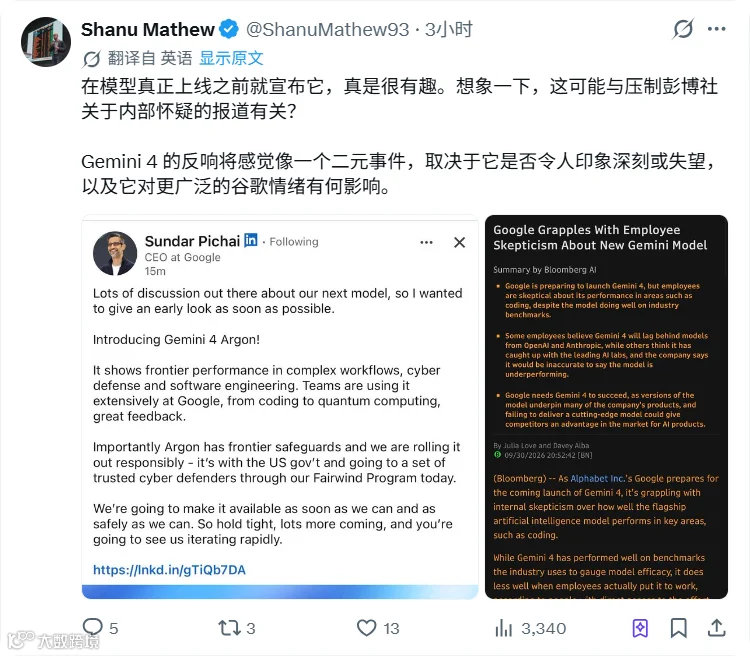
停更长达七个半月的 Gemini 旗舰模型迎来更新。Google 相关账号同步宣布正式发布 Gemini 4 Argon。
该模型在写作、知识储备和长文本处理能力上表现突出,显著强于其编程与 Agent(智能体)能力。目前,Gemini 4 Argon 仅通过 Fairwind 计划向少量网络安全合作伙伴开放,后续将优先面向付费 API 用户和 Google AI Ultra 订阅者,普通用户仍需等待。

命名由来与发布策略
Gemini 4 沿用了测试期间的内部代号“Argon”(氩),作为第 18 号元素,其惰性气体属性与 Chrome(铬)形成有趣对仗。官方未对命名做过多解释。
出于安全考量,该模型目前并未全面公开。此前测试场流出的版本因未经官方确认,其比对结果参考价值有限。以下分析主要基于官方释出的数据。
性能评测:知识与长文本优势显著
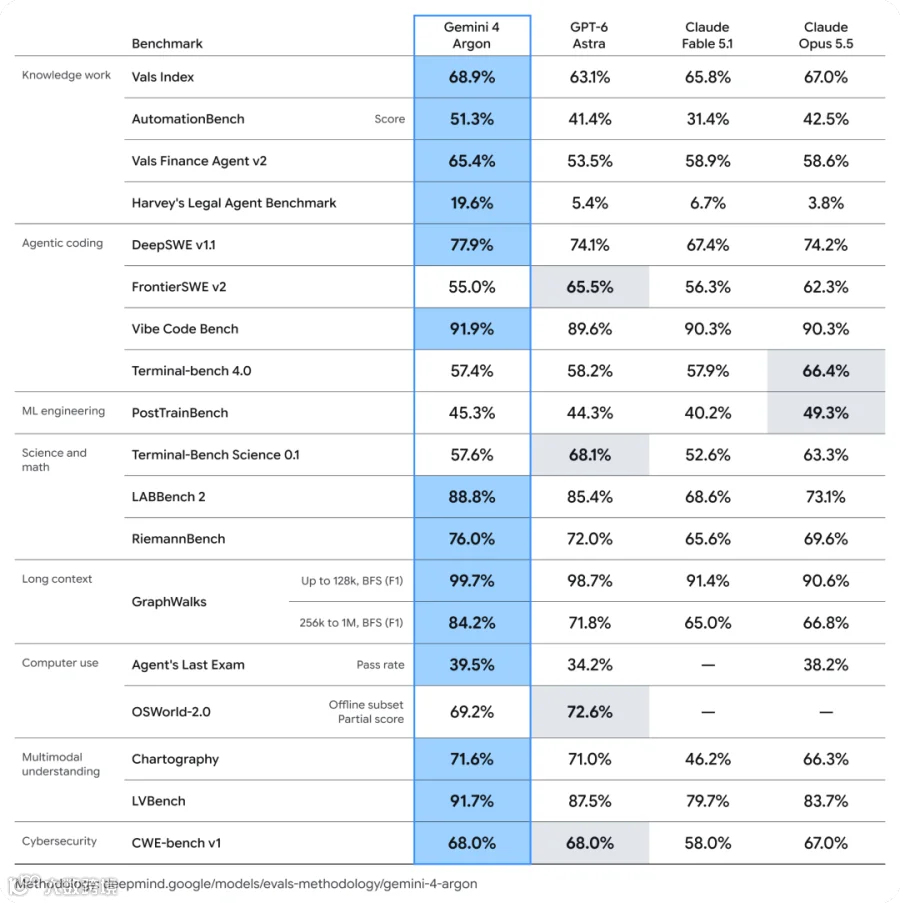
官方数据显示,Gemini 4 Argon 在 18 项测试中的 13 项取得领先,核心优势集中在知识工作与长上下文处理。
知识工作领跑
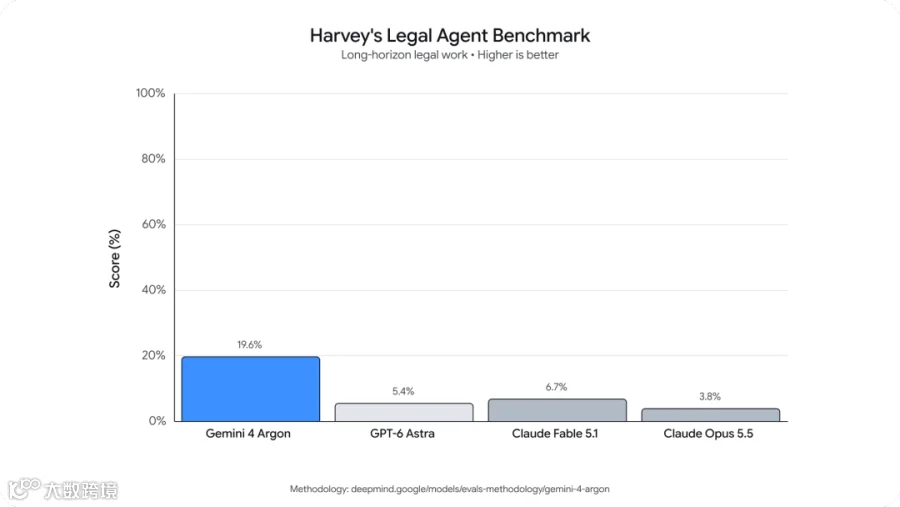
在 Vals Finance Agent v2(金融分析)与 Harvey's Legal Agent Benchmark(法律工作)等真实场景测试中,Gemini 4 的表现大幅领先其他模型两档以上,延续了 Gemini 系列在世界知识方面的传统优势。
长上下文与输出升级
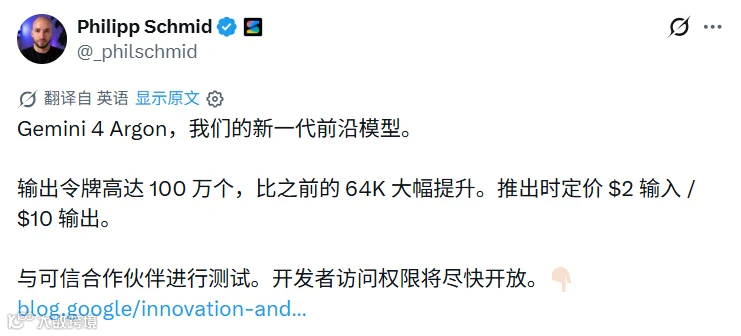
在 GraphWalks 测试中,Gemini 4 处理 256k—1M 超长上下文的能力领先竞品超 10%。这一提升得益于输出上限从上一代的 6.4 万 token 跃升至 100 万 token。
这意味着模型可一次性输出约 70 万至 100 万个汉字,为复杂推理和思维链构建提供了极大空间,有助于单次解决棘手问题。
编程能力分化与幻觉率降低
相较于知识与写作,Gemini 4 的编程表现呈现两极分化。
编程实测:强弱并存
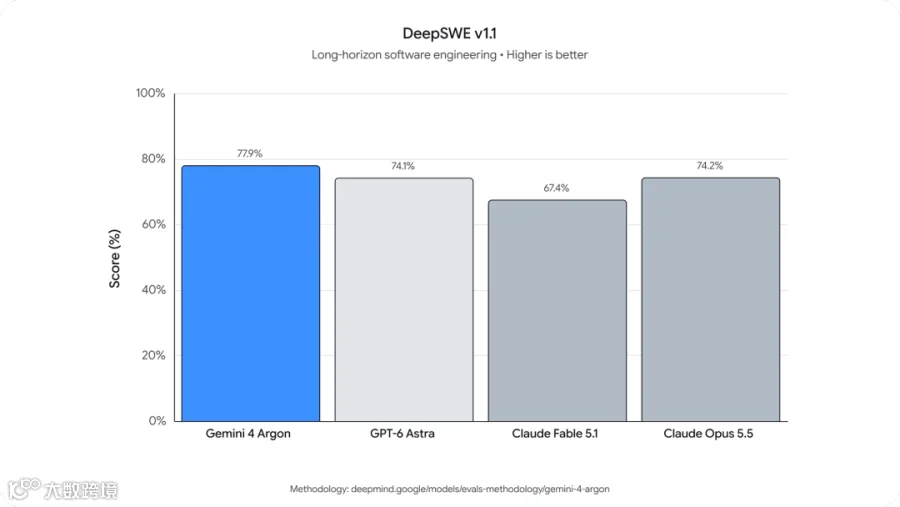
- 优势领域:在 DeepSWE v1.1(真实世界长周期软件构建)测试中,得分 77.9%,领先 GPT-6 Astra 和 Claude Opus 5.5 近 4 个百分点。
- 弱势领域:在 FrontierSWE v2(从零构建项目)和 Terminal-Bench 4.0(Linux 终端复杂任务)中表现垫底。
第三方平台 Arena.ai 的盲评数据佐证了这一观点:Gemini 4 在 Text Arena(文本处理、创意写作)中排名第一,但在 Code Arena: WebDev 和 Agent Arena 中仅排第八。总体特性可总结为:知识/写作 > 编程 > 终端操作。
幻觉率大幅下降
Artificial Analysis 测试显示,Gemini 4 的幻觉率仅为 15%,在前沿模型中最低。面对不确定问题时,模型更倾向于承认“不知道”而非编造答案,提升了回答的可信度。


定价策略与市场定位
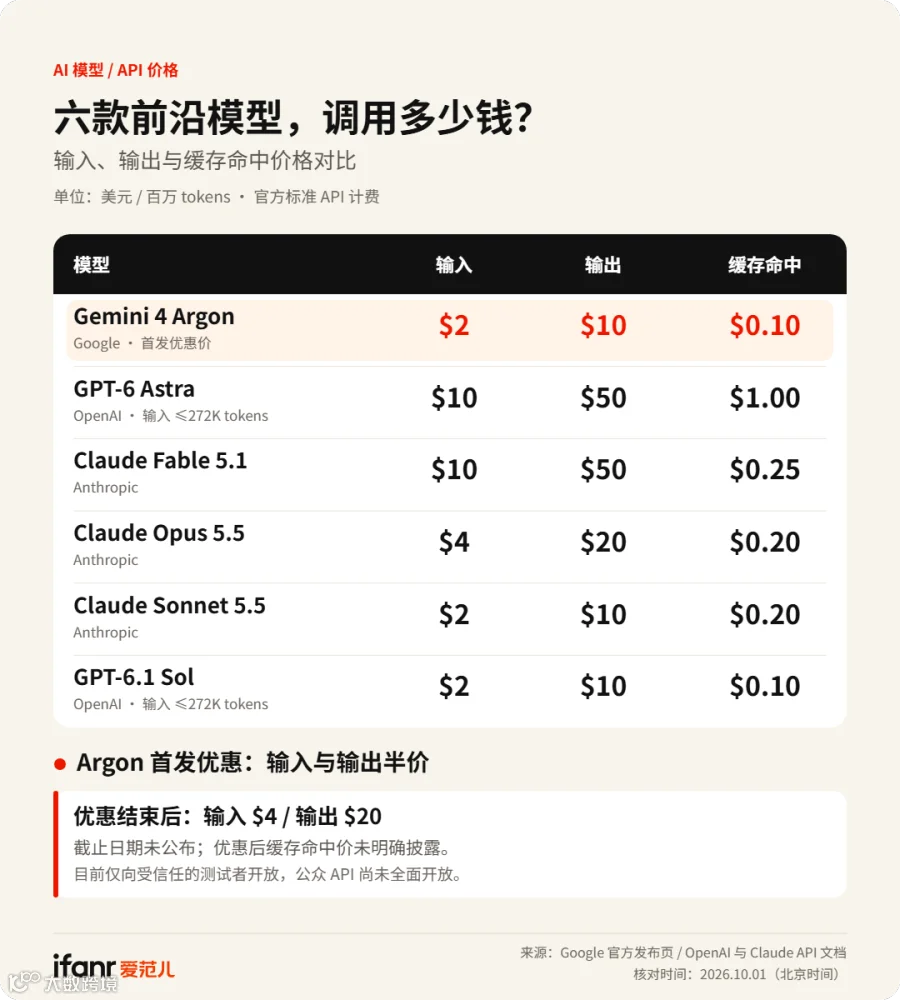
Gemini 4 Argon 延续了 Google 极具竞争力的定价策略:
- 输入价格:每百万 token 2 美元
- 输出价格:每百万 token 10 美元
- 缓存命中:0.1 美元(即原价的 5%)
尽管官方称首发优惠结束后价格将翻倍,但参照过往经验,优惠期可能持续至下一代模型发布前。以此计算,Gemini 4 的价格约为 GPT-6 Astra 和 Fable 5.1 的五分之一,与 GPT-6.1 Sol 和 Sonnet 5.5 持平。若性能属实,其“智价比”极高。
此次更新也解决了 Google AI Pro 套餐长期缺乏顶级模型支持的尴尬局面,提升了会员服务的实际价值。

行业观察:回归赛场与理性预期
Gemini 4 的发布标志着 Google 重新回到大模型竞争的第一梯队。然而,对于其实际表现需保持理性。
大模型研发类似制造业,需要持续迭代。此前 Gemini 3.8 Flash 跑分与实测的巨大落差曾引发对“刷榜优化”的质疑。彭博社报道指出,部分 Google 内部员工对 Gemini 4 的实际编码处理能力持保留态度,认为其在真实任务中未必能完全复现基准测试的高分。
尽管存在争议,Gemini 4 Argon 的上线至少保证了产品的下限。随着 ChatGPT 和 Claude 的快速迭代,Google 需通过持续的工程优化来缩小差距。对于用户而言,一个在写作和知识处理上具有独特优势、且价格亲民的模型,丰富了市场选择。