浙大人物
李炳博 微珩科技创始人
本科就读于浙江大学信息与电子工程学系电子信息工程专业,博士毕业于浙江大学信息科学与工程学院信号与信息处理专业。曾任Nano Labs核心芯片研发骨干,长期从事高性能计算芯片、3D堆叠芯片及存算相关集成电路架构研发,在芯片前端设计、验证及工程化方面拥有丰富经验。2025年创立微珩科技,带领团队聚焦大模型端侧推理需求,推进3D AI LPU专用芯片及配套软件栈的研发与产业化。
随着大模型逐渐从云端走向本地设备,一道硬件瓶颈正在变得越来越突出。
即使芯片拥有强大的计算能力,模型运行速度仍可能受到内存带宽的限制。尤其在大语言模型逐字生成答案的过程中,大量模型参数需要被反复读取。当数据传输速度跟不上计算速度,再强的算力也难以充分发挥。
这一问题被业界称为“内存墙”。

近日,杭州微珩启元科技有限公司(以下简称“微珩科技”)完成新一轮融资,投资方包括TCL创投、翌马资本、华樟基金等。
这家由浙江大学博士李炳博创立的芯片企业,正在尝试通过3D堆叠内存与专用推理芯片架构的结合,为大模型本地运行提供新的解决方案。
一颗专门为大模型推理设计的芯片
微珩科技创立于2025年初,总部位于杭州市上城区,专注于端侧AI高速推理计算,其核心产品是一款面向大模型推理的3D AI LPU芯片,并配套开发完整的AI软件栈。
LPU即语言处理单元(Language Processing Unit),是一类面向大语言模型推理需求优化的专用处理架构。
大模型的计算任务通常可以分为训练和推理。训练需要消耗大量算力,让模型掌握知识与能力;推理则发生在模型投入使用之后,例如用户提出问题、模型生成回答。
目前,GPU凭借通用计算能力承担了大量AI训练和推理任务。但在边缘设备、小型服务器等本地部署场景中,功耗、成本、内存容量和带宽都会成为制约因素。
微珩科技选择针对推理环节进行专门优化。
公司希望通过LPU专用架构,提高模型推理过程中计算单元与存储系统的协同效率,使大模型能够在有限的功耗和硬件资源条件下,更快完成响应。
这一技术方向与李炳博此前的研发经历密切相关。
在创立微珩科技之前,李炳博长期参与高性能计算芯片、3D堆叠芯片及相关集成电路架构的研发,积累了从芯片前端设计、验证到工程化落地的经验。
而大模型推理对内存带宽与能效的要求,恰好为这些技术积累提供了新的应用方向。
2025年,李炳博创立微珩科技,负责公司整体技术路线、芯片架构规划及研发项目管理,带领团队推进LPU芯片与配套软件栈的开发。
用3D堆叠内存突破“内存墙”
微珩科技技术路线中的一个关键环节,是3D堆叠异构内存架构。
传统芯片系统中,计算单元与内存之间需要进行频繁的数据传输。当模型参数规模不断扩大,数据搬运产生的时间和能耗开销随之增加。
3D堆叠技术通过垂直集成存储芯片,并利用高密度互联提升数据传输效率,能够在有限空间内提供更高的内存带宽。
但高带宽内存也面临成本和容量方面的约束。
因此,微珩科技采用3D与2D相结合的异构存储思路,以高带宽存储承担对访问速度要求较高的数据任务,并通过扩展存储满足更大的模型容量需求。
在2026年世界人工智能大会期间,微珩科技披露了其规划中的“扶光”(Englight-LPU)端侧推理芯片。
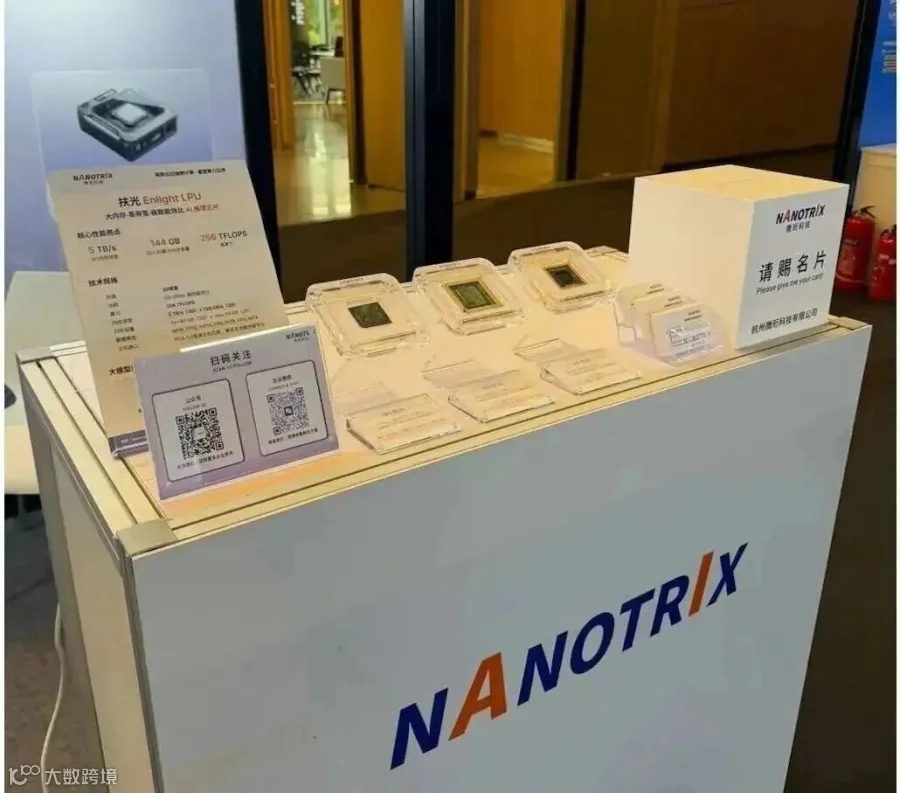
根据当时公开的产品规划,该芯片算力目标达到256 TFLOPS,采用3D+2D异构存储架构,其中3D堆叠内存容量规划为10—40GB,带宽达到5 TB/s;2D扩展存储容量为8—64GB,带宽达到136 GB/s,并以支持200B参数规模模型为设计目标。
除了存储架构,微珩科技还围绕专用计算架构、存算协同调度和AI编译器等方向进行布局。
其中,面向大模型推理的LPU芯片架构,针对大语言模型中的计算特点优化硬件资源配置,提高推理任务的执行效率。
存算协同调度与算子优化技术,则通过优化数据在存储与计算单元之间的流动方式,减少反复搬运带来的开销,并对大模型常用计算操作进行针对性优化。
此外,公司还开发AI编译器与模型部署软件栈,支持模型转换、量化、算子融合等环节,降低大模型迁移到专用芯片平台的适配难度。
从计算架构、存储系统到模型部署,微珩科技希望建立一套围绕大模型推理需求优化的软硬件系统。
从技术积累走向芯片商业化
对于一家成立不到两年的芯片企业而言,技术方案之外,产品落地同样重要。
微珩科技核心团队在高性能计算芯片领域积累了较为丰富的产业经验,曾参与多款近存计算架构芯片及3D堆叠芯片产品的研发、量产与市场交付。
这一背景为公司推进专用AI推理芯片的工程化提供了基础。
资本也在持续关注这条技术路线。
2025年9月,微珩科技曾完成数千万元Pre-A轮融资,投资方包括A股上市公司迎丰股份和纳斯达克上市公司Nano Labs(毫微科技)。
彼时,公司表示将重点推进端侧AI推理芯片与国产高带宽内存(HBM)模组研发,围绕端侧大模型原生支持、高效内存调度以及产业链协同进行布局。
如今,随着TCL创投、翌马资本、华樟基金等机构加入,微珩科技再次获得资本支持。
不过,从芯片架构设计到最终商业化,仍需要经历流片、测试验证、软件适配、客户导入和规模化交付等多个阶段。
尤其对于专用推理芯片而言,仅有理论算力与内存带宽还不够。不同模型下的实际推理速度、单位Token能耗、部署成本以及软件生态兼容性,都会影响产品的商业竞争力。
当大模型走向本地,新的芯片机会正在出现
当前,大模型的应用场景正在不断延伸。
在工业生产、智能终端、边缘服务器等领域,越来越多的AI任务需要在靠近数据产生的位置完成计算。
本地推理能够减少数据往返云端的需求,在网络连接受限、隐私保护要求较高或者实时响应要求严格的场景中具有应用价值。
但要让大模型真正进入这些设备,芯片必须同时平衡性能、功耗、存储容量与部署成本。

这为专用AI推理芯片提供了新的市场机会,也带来了更加激烈的技术竞争。
一方面,GPU仍在持续提升推理效率,通用NPU、存算一体架构及其他AI加速芯片也在快速迭代;另一方面,大模型的参数规模、计算方式和部署需求仍在变化,硬件企业需要不断调整产品设计与软件支持能力。
对微珩科技而言,3D堆叠与异构存储方案提供了一条差异化技术路径,但也意味着必须解决先进封装、内存成本、芯片良率及系统适配等工程问题。
当大模型从云端进入终端,计算与存储如何协同,正在成为AI芯片竞争的重要方向。微珩科技选择从“内存墙”切入,其技术路线能否转化为真实的推理性能和成本优势,值得持续关注。
图片来源 | 微珩启元
免责声明:文章版权归原作者所有。如涉及作品内容、版权和其它问题,请跟我们联系删除!文章内容为作者个人观点,并不代表本公众号赞同或支持其观点。本公众号拥有对此声明的最终解释权。