

给一张首帧图和一段提示词,按WASD走进场景,画面与空间立体声同步演化,转头时声场跟着转。香港科技大学联合Noiz AI开源HelixWorld,在单张NVIDIA H800上以24FPS实时生成,推理代码、预览权重与配套基准HelixBench一并放出。
香港科技大学联合Noiz AI提出的HelixWorld 是一个实时交互式音视频世界模型。只需一张图片和一段提示词,就能进入一个可以自由探索的世界。无论向前走还是转身回望,画面与声音都会同步生成,空间声场也随镜头一起转动。声音不是事后配上的背景音轨,而是与画面一同诞生。
相关链接
-
论文:https://arxiv.org/abs/2609.38123 -
代码:https://github.com/NoizAI/HelixWorld -
主页:https://helixworld.org -
模型权重:https://huggingface.co/NoizAI/HelixWorld-preview -
基准数据集:https://huggingface.co/datasets/NoizAI/Helixbench
内容介绍
一句话:给一张首帧图、一段提示词和连续的操作指令,输出画面与空间立体声同步生成的连续流。

与"先生成无声视频、再用V2A模型补配音"的常规做法不同,核心特点有三个:
-
视听原生联合演化:视觉latent与音频token在同一个扩散主干里几步联合去噪,声音不是后期贴上去的轨道。论文的鼓声案例里,演奏明显停顿时HelixWorld的瞬态随之消退、动作恢复时再起,而后期配音基线AudioX反而在停顿期间冒出一个不该有的瞬态。 -
相机锚定的空间音频:连续6-DoF相机位姿注入视频分支,跨模态注意力把视觉几何与声学特征绑定,相机自运动被自然转换成真实的立体声声像移动。 -
单卡实时可交互:单张H800上768×512、24FPS、RTF 0.77,把交互回路延迟压进实时区间。
适用场景:交互式世界模型与具身仿真环境、游戏与虚拟场景的快速原型、VR与沉浸式内容预演。
方法概述
一套机制管控制信号怎么进,一套机制管怎么把双向教师压成能实时跑的学生;支撑两者的,是一条把拍废素材洗成空间音频语料的流水线。
语料侧,4.1k小时footage来自三个来源:真实世界录像1.8k小时(43.9%)、游戏录屏1.4k小时(34.1%,自带引擎真值位姿与遥测)、开源语料0.9k小时(22.0%)。清洗按计算成本排序分四阶段:启发式过滤(剔除伪立体声与水印横幅)、片段标准化(按主干训练窗口切齐音视频)、语义过滤(音视频MLLM剔除非实拍内容与背景音乐旁白)、相机与字幕(VGGT-Ω估计位姿、Depth Anything V3恢复度量尺度,游戏片段用引擎真值)。字幕是三条解耦轨道分别生成:video-only、audio-only、把可见声源与声学绑定的联合描述。
1. 渐进式条件注入(PRoPE + AdaLN-Zero)
控制信号分两路进视频分支:连续6-DoF相机位姿通过Projective Relative Positional Encoding(PRoPE)变换视觉注意力的query,改变视角就等于改变注意力几何;离散动作被量化成81类词表(9×9的平移与视角旋转速度bin网格),经MLP嵌入后加到扩散噪声水平嵌入上,通过AdaLN-Zero调制主干。两路都先进入视频分支,再靠跨模态注意力传播到音频分支。
难处在于:直接在整个主干上微调未对齐的控制信号,会破坏预训练表征。团队因此分三步解锁——先冻结主干只训控制模块(动作MLP与PRoPE投影),再解冻视频分支,最后解冻全音视频主干做联合flow matching优化,损失为L_FM = L_FM^V + λ_A·L_FM^A。消融显示渐进式优于全量微调:旋转误差从0.1237降到0.1144,平移误差从0.0957降到0.0823。
 先冻结主干只训控制模块,再解冻视频分支,最后联合训练整个音视频主干。
2. 因果初始化与在线轨迹蒸馏
要实时就得因果。团队先把视频latent与同时间步音频token同步进长度为Δt的temporal block:块内注意力保持双向以维持音视频交互,跨块注意力严格因果,靠滑动KV缓存实现。在此基础上适配教师,再把学生的单步预测回归到因果教师的Probability Flow ODE端点上,给少步采样一个稳定起点。
接下来的问题是标准self-forcing的漂移。常规做法用分布匹配(DMD)更新学生,但纯DMD会降低样本多样性、并在长rollout中漂移。HelixWorld在DMD之外加了在线轨迹蒸馏损失:在第k步把冻结教师的PF-ODE积分到σ=0得到端点,直接用隐含的教师流向监督学生速度,梯度只在第k步求、历史KV缓存与rollout步骤全部detach;每次更新按概率p随机二选一走L_traj或L_DMD,避免两个目标梯度冲突。收益可查:30秒rollout中云层结构与场景地标保住了,特征多样性不降反升,DINOv3从0.1089升到0.1326(+21.7%),CLIP从0.0718升到0.0815(+13.5%)。
3. 长程流式微调(Long-horizon Streaming Tuning)
即便有轨迹引导,长序列仍会出现画面退化与声学衰减。团队追加流式长调优:学生按segment逐段展开,滑动KV缓存保留sink frames作为锚点、淘汰过远历史,DMD损失的梯度只在当前活跃segment上计算,把显存占用框住。消融上这项与轨迹蒸馏正交——两项都关时WBench综合77.9,只开轨迹蒸馏78.7,只开长程调优78.4,两项同开79.1。
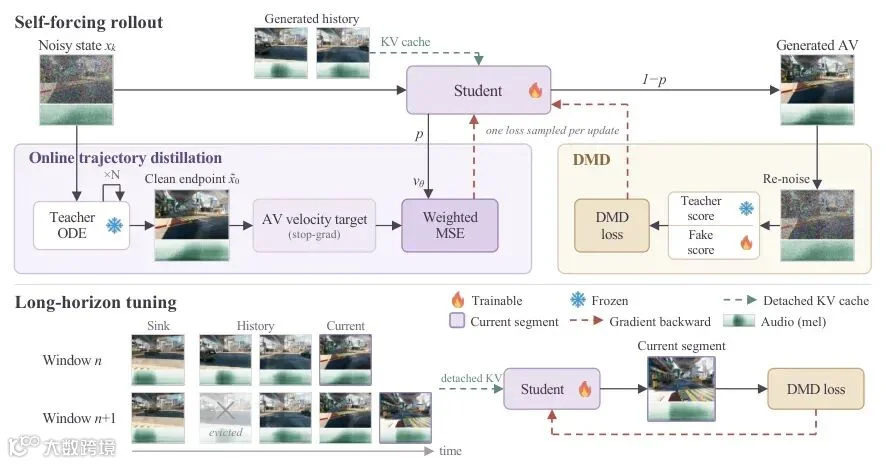 上为自强制训练,在在线轨迹蒸馏与分布匹配之间随机交替;下为长程流式微调,用带初始sink帧的滑动KV缓存逐段扩展rollout。
实验结果
评估分两个基准:视觉质量与动作跟随用公开的WBench导航子集,视听质量用团队自建的HelixBench。
WBench 导航子集
|
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| HelixWorld | 是 | 0.77 | 79.9 | 79.2 |
|
86.4 |
|
|
三点必须写清,不吹:
-
综合79.9只排第4,落后Alaya-EVOKE-Turbo(82.0)、EchoWM(81.0)与Zing-0.5(81.0)。它赢的是"带音频且够快",不是"画质最好"。 -
Physical 70.9落后Alaya的74.0与Zing-0.5的73.8;Setting 76.5明显落后LTX-2.3 base的85.2。 -
快也不是最快:Matrix-Game 3的RTF 0.58、SANA-WM的0.79与它同档甚至更快,但那两个不带音频。真正的技术含量在"0.77的RTF同时带原生音频"——另两个带音频的分别是EchoWM的1.98与LTX-2.3 base的14.61。
HelixBench 视听质量
HelixBench(2026-10-12随代码一起放出)含1,015条人工核验交互片段,覆盖6个场景域与4个子集(Navigation / Perspective / Event / Subject),固定六项指标:KL与FAD量音质,DeSync量时间同步,ImageBind与CLAP量跨模态语义,Spatial量声场是否跟着视角转。
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
|
0.4042 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0.3094 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| HelixWorld(因果学生) | 1.3934 | 2.3872 |
|
0.2987 |
|
41.7583 |
这张表最值得看的是级联配音的三行。团队做了一个很干净的对照:把HelixWorld生成的视频静音,再用三个主流V2A模型重新配音,视觉内容完全固定,只换音频来源。结果AudioX与PrismAudio的空间一致性直接为负(−5.7392、−9.5072),ThinkSound也只有14.8467——V2A模型拿不到相机轨迹,也就无从判断声源相对听者的方位。反过来,联合生成的因果学生拿到41.7583。这正是"原生联合演化"区别于"先出画面再配音"的实锤。
非全胜项同样要写清:DeSync 0.5867落后LTX-2.3 base的0.4042,在纯粹的音画时间同步上双向非实时的LTX-2.3 base更稳;CLAP上它自己的AudioX配音版本(0.3094)也略高于联合生成(0.3016)。
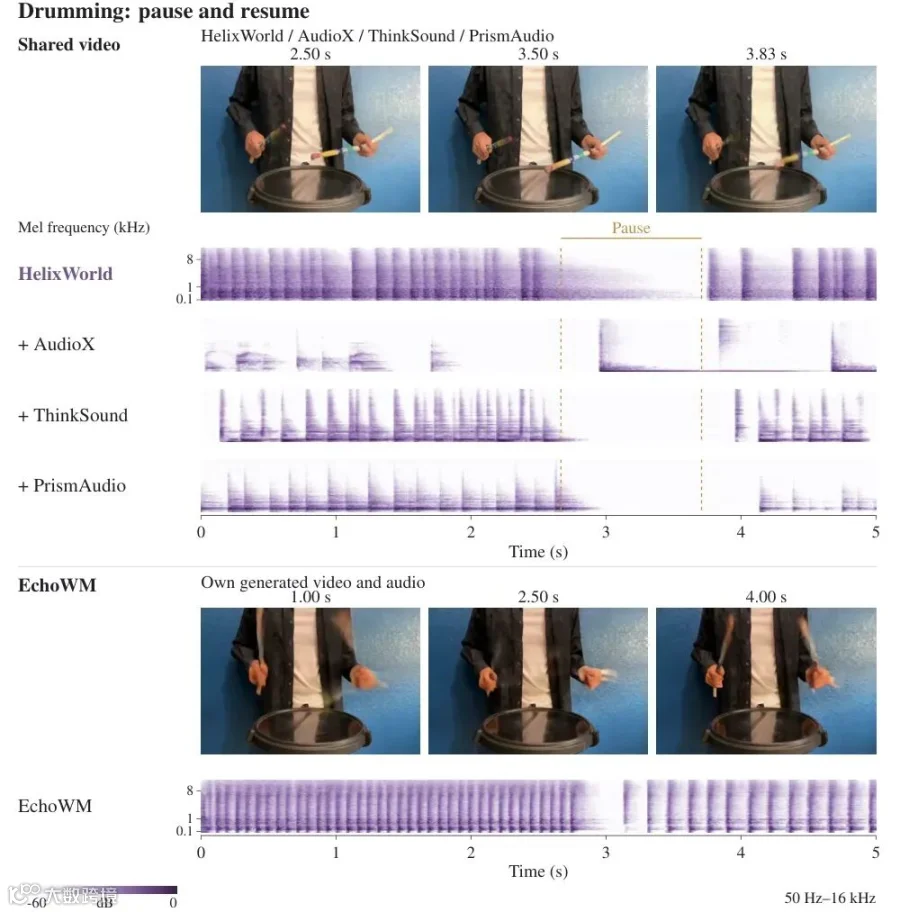 演奏停顿期间,HelixWorld的瞬态随之消退;后期配音基线AudioX反而在停顿处产生瞬态。
消融与用户研究
-
字幕格式:三轨训练配三轨推理的ImageBind相似度0.2462最高,说明把可见声源与声学显式绑定能直接提升跨模态一致性。 -
轨迹蒸馏 + 长程调优:WBench综合77.9 → 79.1。 -
特征多样性:DINOv3 **+21.7%**、CLIP **+13.5%**。 -
盲测用户研究:带音频时HelixWorld在每一组对比中都赢下多数票;去掉音频只看画面动态时,它胜过Alaya、HY-WorldPlay与SANA,与LingBot-World v2持平,仅落后EchoWM。
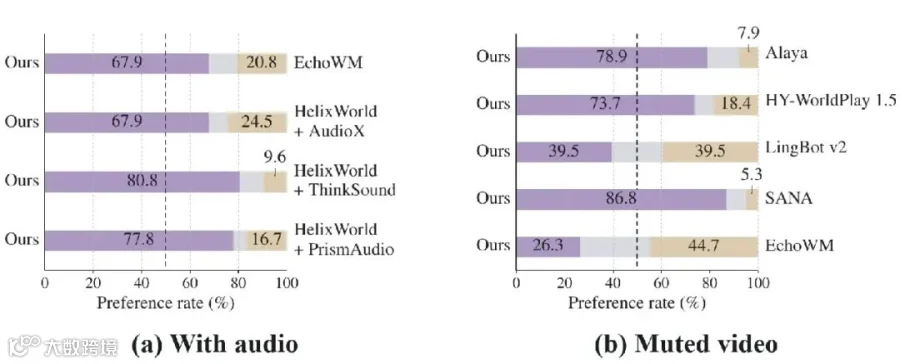 紫色为偏好HelixWorld,灰色为持平,米色为偏好基线;虚线标出50%分界。
局限与未来方向
首先,硬件门槛不低。官方明确推荐80GB显存,BF16单卡实跑约占用70GB,权重文件47.79GB,还需要额外的gemma-3-12b文本编码器——任何"4090可跑"的说法都不成立。
其次,指标口径有局限。HelixBench的六项指标不合成单一总分,官方说法是设计上就不合成,横向比较模型时必须自己定权重;公开版本只放出首帧与AV字幕,GT视频不公开,第三方无法自行复核全部指标。
此外,训练语料内部并不齐整。34.1%来自游戏录屏、相机位姿是引擎真值,真实世界部分靠VGGT-Ω估计位姿并恢复度量尺度,两个来源的标注精度与口径并不一致,会影响动作可控性向真实场景的泛化,论文未给出跨域漂移的定量结论;长程稳定性也主要靠30秒rollout的视觉对比,缺少长时间定量指标。
结论
HelixWorld验证了一条此前没人走通的路径:把视觉与空间声场放进同一个扩散主干做联合生成,再用轨迹蒸馏压成能实时跑的学生——"视听一体"在单张GPU上可以成立,不是只能停在demo。
对于做世界模型与具身仿真的研究者,HelixBench的spatial-acoustic consistency是可直接复用的新评测维度,评测代码、依赖清单与冻结GT特征都放出来了;那组"静音后重新配音"的对照实验本身就是一个很好的论证模板。对于做内容与工具的开发者,浏览器里的交互Demo值得先玩一遍,能直观看到空间声场跟不跟镜头走;但生产部署要按80GB显存规划,现阶段更适合做原型与预研,而不是直接上线。
风险提示:代码与权重是Apache-2.0,可商用;但论文页面标注的许可为CC BY-NC-SA 4.0(非商用),两者口径不一致,商用前建议以代码仓库的LICENSE为准并自行确认。当前放出的权重是Preview v1,官方未承诺后续checkpoint的接口兼容性。
交互式世界模型的第一阶段是"画面能动",下一个阶段大概是"环境可信"——而可信的第一步,是听见声音从哪个方向来。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~
