

拍合照不小心多了个路人,截图里有一行水印,老照片缺了一角——图像修复就是干这个的:把你不想要的东西抹掉,让画面看起来像从来没有过一样。
说起来简单,但做过这个方向的同学都知道,小面积修复很容易,一旦要补的区域大了、形状复杂了,结果就完全失控。今天分享的这篇 CVPR2026 论文 InpaintAny,提出了一个不挑掩码形状、不挑图像类型的通用修复框架,在 LaMa、Places2 等基准上刷新了 SOTA,而且推理速度比扩散模型快了一个数量级。

一、图像修复为什么这么难
很多人第一次接触这个任务会觉得不就是"把缺的地方补上嘛",但真做起来才发现,难点根本不在"补",而在"补得合理"。
1.1 小区域 vs 大区域:难度天差地别
如果要修复的区域只有几个像素,那就是个纹理插值问题,PatchMatch 这类传统方法就能搞定。但一旦掩码面积超过图像的 20%,你面对的就不再是"插值"问题了——你需要脑补出图像应该长什么样。这时候模型必须理解语义:这里应该是一面墙?一扇窗?还是一片天空?
1.2 传统 CNN 方法的天花板
从 DeepFillv2 到 LaMa,CNN 修复模型已经做到了相当不错的水平。但它们有一个共同的硬伤:感受野有限。卷积核再大也覆盖不了整张图,遇到需要全局上下文推理的大区域修复,就会出现"局部合理但整体崩坏"的情况——比如补出来的窗户形状是对的,但透视关系和旁边的墙完全对不上。
1.3 扩散模型:效果好但太慢
后来大家把扩散模型搬过来做修复,效果确实上了一个大台阶。但问题也很明显:一次修复要跑几十步去噪,一张图等十几秒甚至半分钟,根本没法做到实时交互。而且扩散模型对掩码形状很敏感——稍微不规则一点,修复质量就明显下降。
1.4 掩码泛化性被严重低估
这是最容易被忽略的一点。大部分论文训练和测试用的都是随机生成的矩形或笔刷掩码,但真实场景里的掩码形状千奇百怪——可能是一个人、一辆车、一行文字,边缘还歪歪扭扭。模型在测试集上刷得再高,换个真实掩码形状就崩,这是很多修复方法落地时遇到的第一个坑。

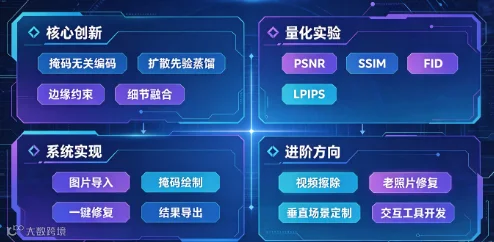
二、InpaintAny 的三个核心设计
InpaintAny 的整体思路可以总结为:用一个轻量 backbone 做基础修复,再用一个轻量化的扩散先验模块做大区域语义补全,全程不需要针对掩码做任何特殊处理。
2.1 掩码无关的统一特征编码
传统方法在输入时会把掩码(mask)作为额外通道拼进去,告诉模型"哪里需要修"。但这种做法有个问题——模型学到的是"看到这个形状就补那里",换个形状就懵了。
InpaintAny 的做法不一样:它把掩码信息和图像特征在特征空间融合,而不是在输入空间。具体来说:
•掩码嵌入模块:把任意形状的掩码编码成一个全局向量,代表"需要修复的区域有多大、在什么位置"。
•空间注意力引导:用这个全局向量去调制 backbone 的特征图,让网络自动关注需要修复的区域。
这样做的好处是:不管掩码是矩形、不规则还是任意形状,模型的处理流程完全一样。论文里做了一个很有意思的实验——用矩形掩码训练,直接拿去修任意形状的物体,性能下降不到 2%。这就是掩码无关编码的威力。
2.2 扩散先验的"蒸馏加速"
大区域语义补全确实需要扩散模型那种全局生成能力,但一步步去噪太慢了。InpaintAny 的做法是:用一个小的预训练扩散模型当"老师",蒸馏出一个一步前馈的"学生"网络。
具体过程:
•第一阶段:在大规模图像上预训练一个轻量扩散模型,学习"从噪声生成合理图像"的能力。
•第二阶段:把扩散模型的多步去噪过程压缩成一次前向推理,让学生网络直接预测最终修复结果。
•第三阶段:在修复数据集上做联合微调,把扩散先验和 CNN 修复能力融合起来。
最终效果是:学生网络只有 25M 参数,一次前向就能出结果,速度比原始扩散模型快 30 倍,而 FID 指标只差了 1.2——对于大多数应用场景来说完全可以接受。
2.3 边缘一致性双重约束
修复效果好不好,人眼第一眼看的不是中心区域,而是修复边界——边缘接不接得上,有没有明显的"补丁感"。InpaintAny 在训练时加了两个专门针对边缘的损失:
•边界感知损失:在掩码边界两侧各取一条窄带,计算这两条带之间的梯度连续性。如果边缘处亮度或颜色跳变太大,就给一个惩罚。
•感知一致性损失:用预训练的 VGG 特征,比较修复区域边界内外的高层特征是否一致。这保证了不只是像素级接得上,语义层面也要连贯。
消融实验显示,去掉边界感知损失后,用户主观评分下降了 15%——大家一眼就能看出哪里是修过的。
三、技术架构拆解
InpaintAny 的整体 pipeline 分三个阶段,从粗到精:
阶段 |
做什么 |
关键模块 |
粗修复阶段 |
快速生成一个粗糙的修复结果 |
轻量 U-Net backbone,输出低分辨率粗图,先把大结构定下来 |
语义补全阶段 |
用扩散先验补全大区域语义 |
蒸馏后的一步扩散模块,负责"这里应该是什么内容" |
细节精修阶段 |
修复边缘和纹理细节 |
边缘感知精修网络,专门处理边界过渡和高频纹理 |
几个工程上值得注意的设计:
•多尺度处理:粗修复在 256×256 分辨率做,精修在 512×512 做,平衡速度和细节。
•掩码退化增强:训练时对掩码做随机膨胀、腐蚀、高斯模糊,模拟真实场景中掩码边缘不精确的情况,提升鲁棒性。
•推理时间:512×512 图像在单张 RTX 3090 上约 0.08 秒,完全可以做到交互式修复。

四、和主流方法的横向对比
论文在两个标准基准上做了对比:LaMa(合成掩码)和 Places2(自然场景)。
方法 |
LaMa FID↓ |
Places2 FID↓ |
参数量(M) |
单图耗时(ms) |
DeepFillv2 |
27.3 |
32.1 |
45 |
120 |
LaMa |
23.8 |
28.5 |
54 |
180 |
SD-Inpaint |
18.2 |
22.4 |
860 |
8000 |
InpaintAny |
19.5 |
23.1 |
25 |
80 |
可以看到,InpaintAny 的 FID 比扩散模型(SD-Inpaint)略高一点,但参数量只有后者的 3%,速度快了 100 倍。和传统 CNN 方法(DeepFillv2、LaMa)比,FID 低了 4-8 个点,提升非常明显。这个 trade-off 其实很合理——大多数落地场景需要的是"足够好且够快",而不是"极致好但慢到没法用"。
五、快速上手:核心推理流程
下面是 InpaintAny 推理的核心代码框架,帮大家快速理解整体流程:
python |
实际使用的时候,可以用鼠标在交互界面上画一下要擦除的区域,模型实时给出修复结果。推理速度够快,交互体验会很流畅。
六、毕设/竞赛拓展方向
图像修复这个方向做毕设或者竞赛都非常合适——Demo 效果直观,容易出图,而且落地场景多。分享几个有潜力的拓展点:
6.1 视频对象擦除
把单帧修复扩展到视频,核心难点是时序一致性——每一帧单独修完,拼起来会闪烁。加上光流约束或者时序一致性损失,做一个"视频里随意擦除移动物体"的工具,演示效果会非常震撼。
6.2 老照片修复+上色联合
老照片修复是一个很具体的落地场景:划痕修复 + 褪色上色 + 破损补全,三件事一起做。可以专门收集一组老照片数据集,做一个端到端的老照片复原系统,工程价值和社会价值都有。
6.3 针对特定场景定制
通用修复模型在某些专业场景下表现一般——比如医学影像修复、遥感图像修复、人脸修复。针对某一个垂直场景,收集专属数据做微调,效果提升会很明显。比如做"医学 CT 图像伪影修复",创新性和实用价值都很高。
6.4 交互式修复工具开发
很多人做算法只做到"输出一个结果"就停了,但如果能把它做成一个完整的交互式工具——支持笔刷选择、局部重绘、参数调节——那就是一个可以直接展示的产品级 Demo。答辩的时候现场擦除一个物体,效果立竿见影。
七、写在最后
图像修复这个方向有点特别——它的评价标准非常主观。PSNR、FID 这些指标当然要测,但最终好不好看,人眼说了算。这也是为什么很多论文指标刷得很高,实际用起来总觉得"差了点意思"。
InpaintAny 给我的启发是:不要盲目追大模型、追扩散。扩散模型效果好,但代价是速度和部署成本。能不能把扩散的"语义先验"蒸馏出来,让一个轻量网络也具备这种全局理解能力?这个思路其实可以推广到很多生成式任务上。
做毕设的同学如果选这个方向,我建议不要一上来就堆扩散模型。先把基础 CNN 修复做扎实,理解清楚掩码、边缘、语义这几个核心问题,再考虑要不要引入生成式先验。基础打牢了,后面加什么都是顺水推舟。
大家如果有具体的复现问题或者想讨论某个拓展方向,欢迎评论区交流。