

哈喽,大家好~
今儿聊聊特征工程,聚合特征,怎样把“流水明细”变成模型看得懂的信号?
如果说,用户每天有很多条交易记录,难道要把每一笔交易都塞进模型吗?
当然不是。
真正处理的时候,我们经常需要把明细数据,按照用户、商品、订单等粒度进行汇总,这个过程就是聚合特征工程。
最后会给大家一个案例,看看如何从交易明细中构造聚合特征,再用模型完成训练,并通过图形分析模型到底学到了什么~
01聚合特征是什么?
假设我们有下面这样的交易明细:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
模型如果直接读取明细,会遇到一个问题:用户 A 有 3 条记录,用户 B 只有 1 条记录,数据粒度并不统一。
所以,我们可以按照 user_id 聚合:
-
交易次数:3 -
总消费金额:480 -
平均消费金额:160 -
最大单笔金额:300 -
活跃天数:3 -
最近一次交易距截止日:70 天
这样,每个用户最终对应一行数据,模型就能正常学习。
也就是,聚合特征就是把一组明细记录压缩成一个更有业务含义的统计特征。
02常见聚合方式与核心原理
设用户 的交易金额为 。
交易总金额可以写成:
它反映用户整体消费规模。
平均金额为:
它更关注用户单次消费水平。
除此之外,还经常使用:
-
count:交易次数、购买商品数量 -
sum:总金额、总折扣 -
mean:平均价格、平均评分 -
max/min:最高或最低消费 -
nunique:购买品类数、活跃天数 -
recency:距离最近一次行为的时间
例如,一个用户总消费很高,但已经 90 天没有购买;另一个用户总消费不高,却在最近 3 天连续购买。只看 sum 很难区分,但加入 recency 后,模型就能识别出不同的行为状态。
这里要特别注意一个问题:聚合时间窗口必须固定,不能把预测之后的数据也统计进去。
否则就会发生数据泄漏。比如我们要预测用户下个月是否流失,就不能把下个月的交易记录聚合进特征。
03完整案例
下面我们构造一份交易数据:
-
每个用户有多条交易记录 -
交易次数、金额与用户活跃程度相关 -
使用过去 90 天的数据构造聚合特征 -
使用逻辑回归预测用户是否流失
逻辑回归输出用户流失概率:
其中, 是聚合后的特征, 是模型学习到的权重, 是偏置项。
概率越高,说明模型认为用户越容易流失。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.model_selection import train_test_split
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_curve, roc_auc_score, precision_recall_curve

rng = np.random.default_rng(42)

# 1. 构造交易明细
n_users = 1200
users = pd.DataFrame({
    "user_id": np.arange(n_users),
    "segment": rng.choice(["普通", "高价值", "价格敏感"],
                          n_users, p=[.55, .25, .20]),
    "age": rng.integers(18,  sixty := 60, n_users)
})

latent = rng.normal(0, 1, n_users)
seg_effect = users["segment"].map({
    "普通": 0.0, "高价值": 0.8, "价格敏感": -0.3
}).to_numpy()

n_tx = np.maximum(
    1, rng.poisson(np.exp(1.1 + .65 * latent + .25 * seg_effect))
)

rows = []
for uid, n in enumerate(n_tx):
    days = rng.integers(0, 90, n)
    amount = rng.lognormal(
        mean=3.2 + .25 * latent[uid] + .18 * seg_effect[uid],
        sigma=.45, size=n
    )
    rows.extend(zip(
        [uid] * n, days, amount,
        rng.choice(["食品", "数码", "服饰", "家居"], n)
    ))

tx = pd.DataFrame(rows, columns=["user_id", "day", "amount", "category"])

# 2. 构造用户标签:1 表示未来流失
p_churn = 1 / (1 + np.exp(1.4 * latent))
users["churn"] = rng.binomial(1, p_churn)

# 3. 聚合特征
agg = tx.groupby("user_id").agg(
    txn_count=("amount", "count"),
    total_amount=("amount", "sum"),
    avg_amount=("amount", "mean"),
    max_amount=("amount", "max"),
    active_days=("day", "nunique"),
    category_count=("category", "nunique"),
    last_day=("day", "max")
).reset_index()

agg["recency"] = 90 - agg["last_day"]
data = users.merge(agg, on="user_id")

features = [
    "segment", "age", "txn_count", "total_amount",
    "avg_amount", "max_amount", "active_days",
    "category_count", "recency"
]

X = data[features]
y = data["churn"]

cat_cols = ["segment"]
num_cols = [c for c in features if c not in cat_cols]

preprocess = ColumnTransformer([
    ("num", StandardScaler(), num_cols),
    ("cat", OneHotEncoder(handle_unknown="ignore"), cat_cols)
])

model = Pipeline([
    ("preprocess", preprocess),
    ("model", LogisticRegression(max_iter=1000))
])

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=.25, random_state=42, stratify=y
)

model.fit(X_train, y_train)
prob = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, prob)

print(f"ROC-AUC: {auc:.3f}")

# 4. 图一:ROC 与 PR 曲线
fpr, tpr, _ = roc_curve(y_test, prob)
precision, recall, _ = precision_recall_curve(y_test, prob)

fig, ax = plt.subplots(1, 2, figsize=(13, 5))

ax[0].plot(fpr, tpr, color="#ff4d6d", lw=3,
           label=f"AUC = {auc:.3f}")
ax[0].plot([0, 1], [0, 1], "--", color="#555555")
ax[0].set_title("ROC Curve")
ax[0].set_xlabel("False Positive Rate")
ax[0].set_ylabel("True Positive Rate")
ax[0].legend()

ax[1].plot(recall, precision, color="#00b4d8", lw=3)
ax[1].set_title("Precision-Recall Curve")
ax[1].set_xlabel("Recall")
ax[1].set_ylabel("Precision")

plt.tight_layout()
plt.show()

# 5. 图二:风险分组校准 + 特征系数
test_result = X_test.copy()
test_result["y"] = y_test.to_numpy()
test_result["prob"] = prob
test_result["decile"] = pd.qcut(
    test_result["prob"], 10, labels=False, duplicates="drop"
)

calib = test_result.groupby("decile").agg(
    predicted=("prob", "mean"),
    actual=("y", "mean")
).reset_index()

feature_names = model.named_steps["preprocess"].get_feature_names_out()
coef = model.named_steps["model"].coef_[0]
coef_df = pd.DataFrame({
    "feature": feature_names,
    "coef": coef
}).sort_values("coef")

fig, ax = plt.subplots(1, 2, figsize=(14, 5))

ax[0].plot(calib["decile"], calib["predicted"],
           marker="o", lw=3, color="#8338ec", label="预测流失率")
ax[0].plot(calib["decile"], calib["actual"],
           marker="s", lw=3, color="#fb8500", label="实际流失率")
ax[0].set_title("Risk Decile Calibration")
ax[0].set_xlabel("用户风险分组(从低到高)")
ax[0].set_ylabel("流失率")
ax[0].legend()

colors = ["#ff006e" if v > 0 else "#06d6a0"
          for v in coef_df["coef"]]
ax[1].barh(coef_df["feature"], coef_df["coef"], color=colors)
ax[1].set_title("Logistic Regression Coefficients")
ax[1].set_xlabel("Coefficient")

plt.tight_layout()
plt.show()
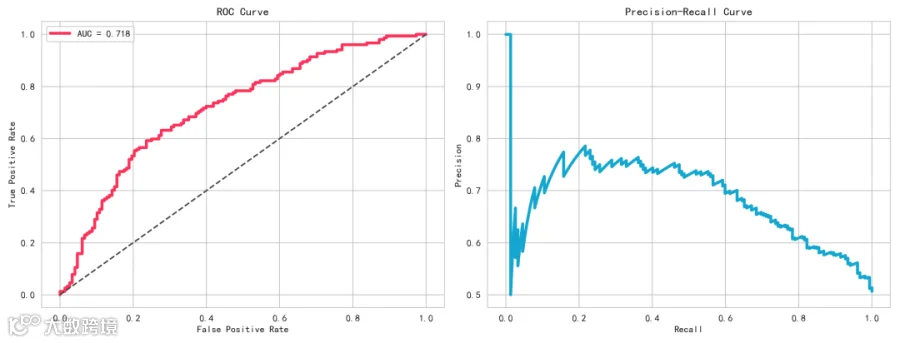
代码中,第一张图的 ROC 曲线用于观察模型整体区分能力,AUC 越接近 1,说明模型越能区分流失用户和非流失用户。
PR 曲线在正样本较少时尤其有用。比如真正流失的用户只占少数,这时只看准确率并不可靠,Precision 和 Recall 更有参考价值。

第二张图左侧把用户按照预测流失概率分成 10 组。
预测曲线和实际曲线越接近,说明模型概率越可信。右侧是逻辑回归系数,红色表示增加流失风险,绿色表示降低流失风险。
例如,recency 系数为正,说明距离最近一次交易越久,流失风险越高。txn_count 系数为负,则说明交易越频繁的用户越不容易流失。
04注意事项
聚合不是“统计得越多越好”,而是要围绕业务问题设计。
比如预测用户流失,可以重点关注:
-
最近一次行为时间 -
近 7 天、30 天、90 天交易次数 -
不同时间窗口的消费金额 -
最近一次金额与历史平均金额的差异 -
用户购买品类是否越来越集中
实际项目中,建议同时构造多个时间窗口,例如:
近7天交易次数
近30天交易次数
近90天总金额
近30天活跃天数
这样模型既能看到短期变化,也能看到长期习惯。
另外,sum 容易受到极端值影响,可以配合 median、max 或截断处理;count 和 nunique 也要结合业务理解,避免把无意义的重复记录当成真实活跃。
总结
聚合特征的核心,就是把不规则的明细数据转换成稳定、可解释的用户级特征。count、sum、mean 和 recency 看起来简单,但组合起来往往能很好地描述用户行为~