

你的模型在训练集上达到了 99% 的准确率。你把它放到测试集上运行,结果只有 70%。
每一位 ML 从业者都见过这种情况。模型没有学会问题,而是记住了答案。
现在设想一下,解决方法是这样的:在每个训练步骤中,随机关闭网络一半的神经元。每次关闭的那一半都不一样。
听起来这应该会让情况变得更糟。但事实恰恰相反,它成为了深度学习中应用最广泛的技术之一。它是帮助 AlexNet 在 2012 年赢得 ImageNet 的关键因素之一,如今仍然内置于现代语言模型背后的 Transformer 架构中。
这项技术就是 dropout,由 Srivastava、Hinton、Krizhevsky、Sutskever 和 Salakhutdinov 在论文 Dropout: A Simple Way to Prevent Neural Networks from Overfitting(2014)中完整提出。
这篇论文的特别之处在于,它不只是说“它有效”,还展示了它_为什么_有效:论文使用了来自进化论的类比,覆盖五个不同领域的实验,以及一些优雅的数学推导,揭示了 dropout 在底层究竟做了什么。读完之后,你将能够自行推导出其中的关键公式。
我们开始吧。
Dropout 为什么会存在?
具有数百万参数的深度神经网络,几乎可以学会训练数据中的所有关系。这其中也包括纯粹的噪声:一些碰巧出现在训练集中的模式,但不会出现在新数据中。
这就是过拟合。模型记住了数据,而不是学会了规律。
作者首先提出了一个有趣的观点。如果你拥有无限的计算能力,那么正则化模型的最佳方式,就是对所有可能的参数设置下的预测结果进行加权平均,权重取决于每种设置对数据的拟合程度。这就是 Bayesian 方法,也是黄金标准。
一种更便宜的替代方案是 ensemble:训练 10 个不同的网络,然后对它们的结果取平均。它的效果很好,但对于大型网络来说,会因为三个原因而难以实施:
每个网络都需要数天时间进行训练。
要让 ensemble 有效,这些网络必须彼此不同,这意味着需要使用不同的架构(每种架构都需要单独调节超参数),或者使用不同的数据(而你可能并没有足够的数据)。
即使你训练好了这些网络,在每次预测时运行 10 个大型网络,对于实际应用来说也太慢了。
因此,这篇论文提出了这样的问题:
我们能否在只训练和运行一个网络的同时,获得组合多个网络的好处?
核心思想
在训练过程中,对于每个样本:
每个神经元以概率
p保留,以概率1 - p丢弃。被丢弃的神经元输出 0。对于当前样本,它会连同所有输入连接和输出连接一起被移除。
处理下一个样本时,重新进行随机决定。
论文中的默认设置:
   Hidden units:  p = 0.5
Input units:   p = 0.8   (closer to 1, you don't want to destroy the input)
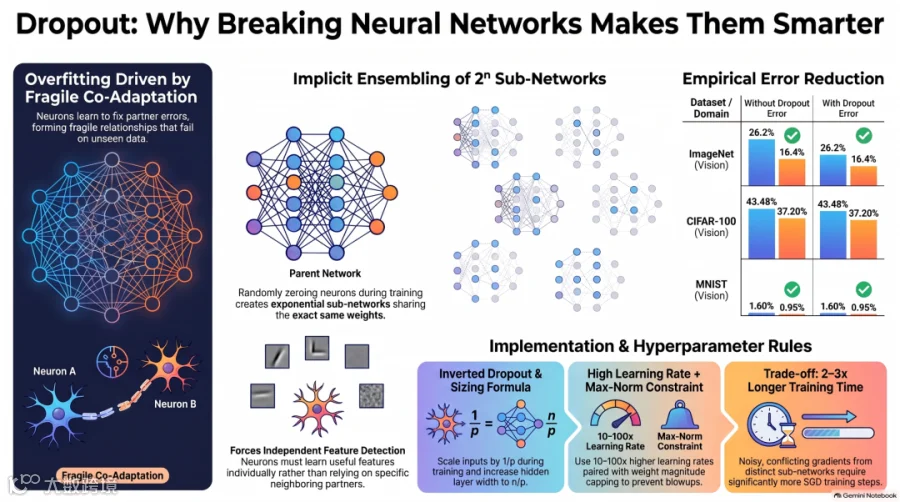
一份模型的代价,得到 2ⁿ 个网络
一个包含 n 个神经元的网络可以产生 2ⁿ 个不同的“变薄”网络,因为每个神经元都可能处于开启或关闭状态。
10 个神经元 → 1,024 个子网络
AlexNet 的两个 4,096 单元层 → 2⁸¹⁹² 个子网络,这是一个大约有 2,466 位数字的数
我尝试想象这个数字,最后放弃了。
关键细节在于:所有这些子网络共享相同的权重。总参数量仍然是 O(n²),与原始网络相同。你并不是在存储 2ⁿ 个模型,而是在存储一个模型,并在每个样本上训练它随机得到的不同切片。
大多数子网络甚至一次都没有被单独训练过。但因为它们共享相同的权重,训练其中任何一个,都会改进其他所有子网络。
等等,为什么破坏你的网络反而会有帮助?
类比 1:基因与进化
大多数高级生物都是通过有性繁殖进化而来的。如果仔细想想,这很奇怪:如果一组基因彼此配合得很好,为什么还要通过混入另一方父母一半的基因来打乱它们?
一种理论认为,进化并不只奖励那些与某一组特定搭档配合良好的基因。它会奖励那些与随机搭档也能良好配合的基因。由于一个基因不能指望每次都有相同的搭档存在,因此它必须能够独立发挥作用,或者与一个小群体共同发挥作用。
Dropout 将这个思想应用到了神经元上。一个神经元不能依赖某个特定的邻居始终存在,因此它必须学会独立完成一些有用的事情。
类比 2:阴谋团体
10 个由 5 人组成的阴谋团体,比 1 个由 50 人组成、且每个人都必须完美完成任务的阴谋团体,更有可能制造混乱。
在条件固定且经过大量排练的情况下,那个庞大的计划也许能够成功。但在不可预测的世界里,每多一个必须准确完成任务的人,就多了一种失败的方式。
没有 Dropout 时,神经元会构建这些庞大而脆弱的“阴谋团体”。论文将其称为 协同适应(co-adaptations):神经元学会以某种方式相互弥补错误,而这种方式只在训练数据上有效。面对新数据时,它们就会崩溃。
说实话,这是我见过对过拟合最清晰的解释,而它来自一篇研究论文。
“为什么不直接创建副本?”
这是我接下来的问题。如果神经元可以随机消失,为什么网络不直接为重要神经元学习备份副本?
作者对此进行了解释:复制是一种糟糕的策略,原因与在噪声线路上传输消息时重复发送多次是一种低效方式相同。它浪费了容量。网络通过学习许多彼此不同、且各自都能独立发挥作用的特征,可以取得更好的效果。
数学部分(别跑!)
第 1 步:普通层
对于一个包含 L 个隐藏层的网络,论文将第 l 层中神经元 i 的标准前向传播写成:
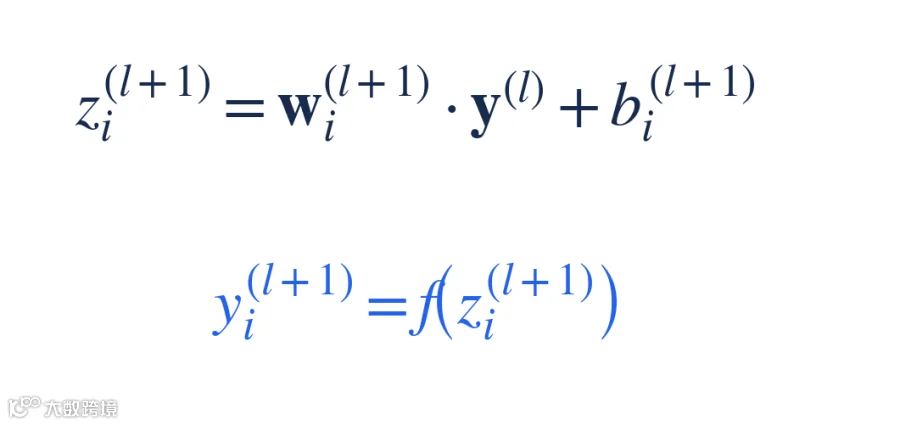
y^(l)= 第 l 层的输出向量(其中y^(0) = x,即输入)w、b= 权重和偏置f= 激活函数(sigmoid、ReLU 等)
第 2 步:加入 dropout 的同一层
Dropout 只增加了两行:
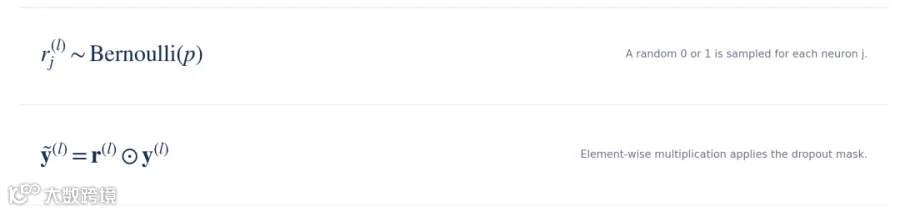

Bernoulli's (p) 表示一次有偏的抛硬币:以概率 p 取 1,否则取 0。每个神经元都会进行自己的随机决定,下一层只能看到幸存下来的神经元,即 ỹ。
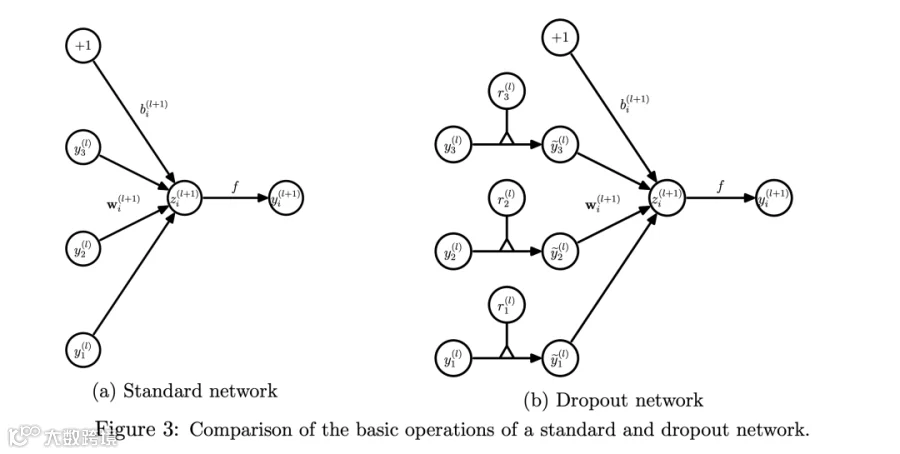
第 3 步:反向传播
训练过程仍然是普通的 SGD,只有一点不同:对于每个样本,前向传播和反向传播都只经过该样本对应的变薄网络。
如果神经元 j 被丢弃(r_j = 0),那么经过它的梯度就会乘以 0。它在该样本中的加权梯度为零。之后,梯度仍然按照通常的方式在 mini-batch 上取平均。
因此,每个权重只会受到那些对应神经元存在的样本的更新。
第 4 步:测试时的问题
在测试时,我们希望得到稳定的预测,因此会使用所有神经元。但下一层在训练期间接收到的活跃输入更少。
让我们计算一下训练期间某个神经元的平均输出。它以概率 p 存在(输出为 y),以概率 1 - p 被丢弃(输出为 0)。

因此,下一层平均接收到的输入是:

这准确地告诉了我们测试时应该做什么:保持所有神经元开启,并将权重乘以 p:
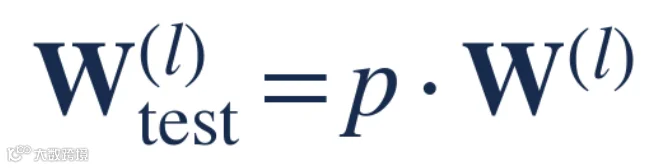
现在,测试时的输出就等于训练时输出的期望值。
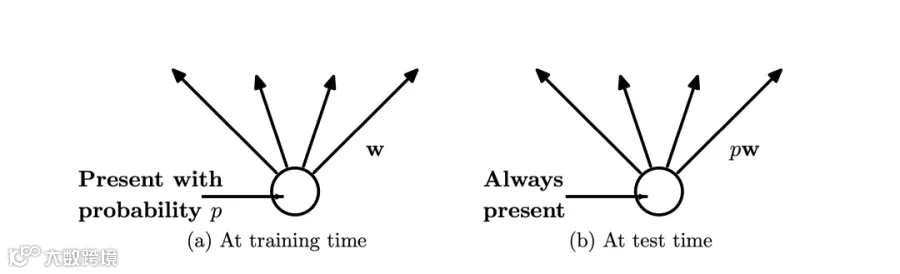
论文将这个缩放后的单一网络描述为对所有 2ⁿ 个变薄网络预测结果取平均的一种近似(具体来说,是等权几何平均)。稍后我们会测试这种近似的效果有多好。
第 5 步:Inverted Dropout(实际使用的版本)
论文还提到了一种等价的替代方案:不在测试时缩小权重,而是在训练期间将幸存神经元的输出乘以 1/p。
现在,每个神经元都会乘以一个随机变量 r_b:它以概率 p 取 1/p,以其他概率取 0。让我们检查它的均值和方差。
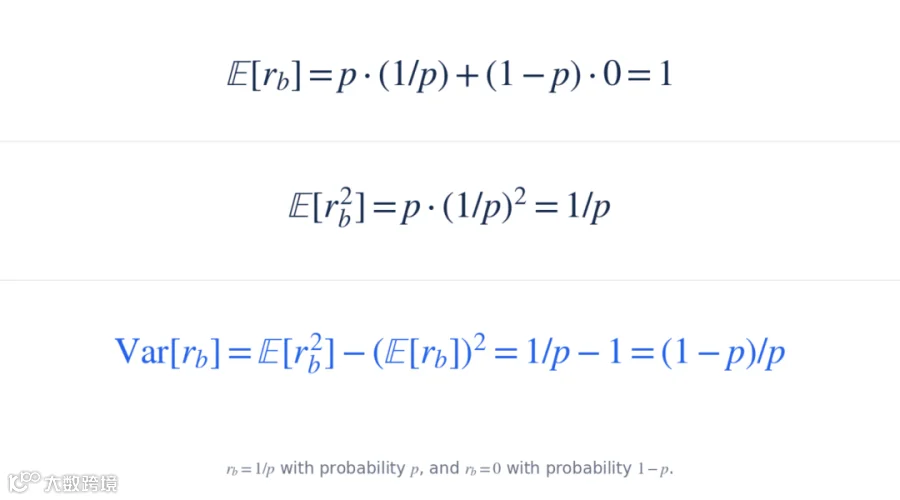
它的均值恰好为 1,因此期望信号保持不变,测试时无需再做任何处理。记住这个 (1 − p)/p 方差;它之后还会出现两次。
隐藏搭档:Max-Norm 正则化
论文发现,dropout 与对每个神经元输入权重施加约束结合使用时效果最好:
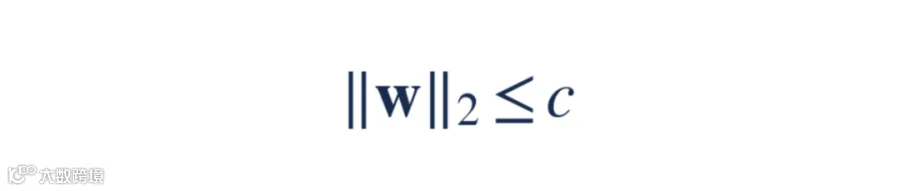
在训练期间,如果某个神经元的权重向量长度超过 c,就将它投影回边界上。

方向保持不变,只有长度受到限制。典型取值为:c = 3 到 4。
为什么要把它与 dropout 配合使用?因为 dropout 会使梯度变得非常嘈杂。每个样本都在训练一个不同的随机网络,因此许多梯度会部分相互抵消。论文采用的解决方案非常激进。
   Learning rate:  10–100× higher than for a standard network
Momentum:       0.95–0.99 (instead of the usual 0.9)
较高的学习率通常会带来权重不断增大的风险。Max-norm 为权重设置了硬上限,因此你可以提高学习率,而不必承担这种风险。
作者的直觉是:dropout 带来的噪声加上较大的学习率,可以让优化器探索原本无法到达的权重空间区域。随着学习率衰减,步长变小,最终会收敛到一个较好的最小值。
将 Dropout 与预训练权重结合使用
如果你从预训练权重开始,论文给出了两点建议:
**将预训练权重乘以 1/p,**这样每个神经元在 dropout 下的期望输出,就能与预训练期间产生的输出相匹配。
使用更小的学习率。如果使用适用于随机初始化的学习率,dropout 带来的噪声会抹去预训练权重已经学到的内容。
好吧,但它真的有效吗?
作者在视觉、语音、文本和遗传学领域测试了 dropout。以下是总结:
   Dataset           Domain     Without dropout   With dropout
──────────────────────────────────────────────────────────────
MNIST             Vision     1.60%             0.95%
SVHN              Vision     3.95%             2.55%
CIFAR-10          Vision     14.98%            12.61%
CIFAR-100         Vision     43.48%            37.20%
ImageNet (top-5)  Vision     26.2%*            16.4%
TIMIT             Speech     23.4%             21.8%
Reuters           Text       31.05%            29.62%
Splicing (↑)      Genetics   440               567

* best non-neural entry in ILSVRC-2012. For splicing, the metric is
  "code quality," where higher is better.
有 4 个结果尤其突出。
1. MNIST:在 60,000 张图像上训练一个拥有 6,500 万参数的网络。
一个每层包含 8,192 个单元的 2 层网络拥有超过 6,500 万个参数,却只在 60,000 张图像上训练。通常来说,这简直是记忆数据的配方。但使用 dropout 和 max-norm 后,它达到了 0.95% 的错误率,甚至不需要 early stopping。
逐步改进的过程也很值得一看:
   Standard net                       1.60%
+ dropout                          1.35%
+ ReLU instead of logistic         1.25%
+ max-norm                         1.06%
+ bigger network (8,192 units)     0.95%
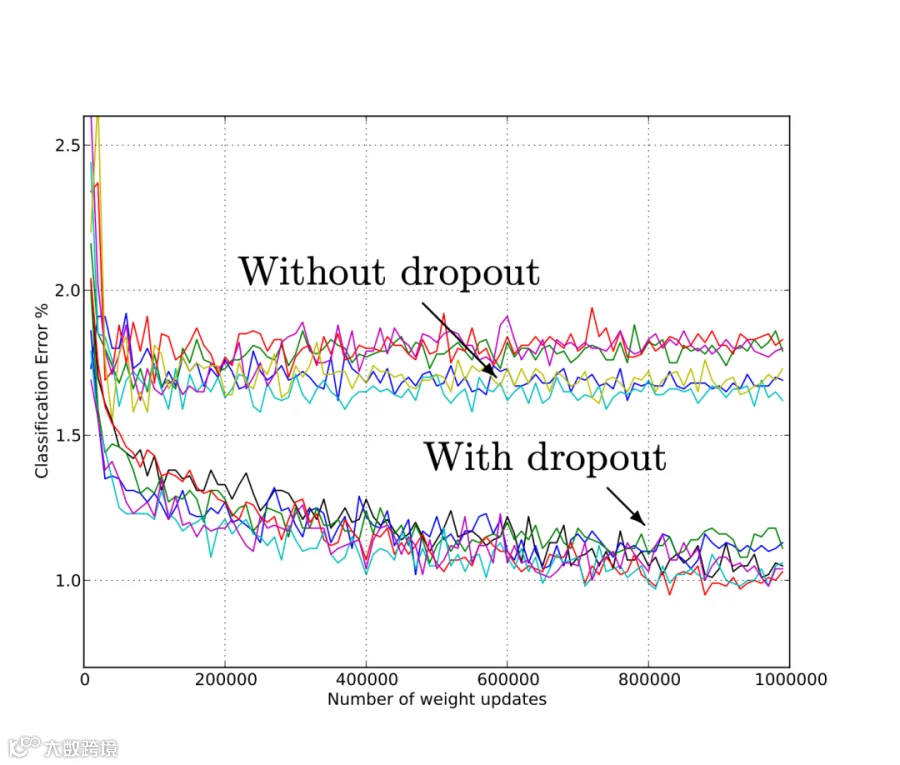
这个图比任何表格都更能说服我。六种不同的架构全部使用相同的超参数进行训练(没有针对每种架构分别调参),最终明显分成两组:底部的全部是使用 dropout 的网络,顶部的全部是不使用 dropout 的网络。
2. SVHN:在卷积层中使用 dropout 同样有帮助。
   Conv net, no dropout                 3.95%
+ dropout in fully connected layers  3.02%
+ dropout in ALL layers              2.55%
Human performance                    2.0%
你可能会认为卷积层不需要 dropout,因为它们的参数很少。作者解释了它为什么仍然有帮助:较低层中的 dropout 会向上方的全连接层发送带噪声的输入,这有助于阻止_那些_层发生过拟合。他们在网络较低层使用了较轻的 dropout:输入层的保留概率为 0.9,卷积层为 0.75,全连接层为 0.5。
3. 文本:提升幅度较小,但原因很有启发性。
Reuters 的错误率只从 31.05% 降到了 29.62%。作者的解释是:由于训练样本超过 200,000 个,过拟合从一开始就不是主要问题。Dropout 解决的是过拟合。如果过拟合不是你的瓶颈,它就不会带来太大帮助。
4. 遗传学:坦诚地展示失败。
在 Splicing 数据集上(训练样本少于 3,000 个),Bayesian neural network 得分为 623,超过了 dropout 的 567。作者公开报告了这一点。但 dropout 击败了其他所有方法,包括 SVM 和需要通过 PCA 缩小输入的回归方法,同时使用了拥有数千个隐藏单元的网络。
Dropout 与其他正则化方法的比较
同一个 MNIST 网络(784–1024–1024–2048–10),使用不同的正则化方法:
   L2                         1.62%
L2 + L1                    1.60%
L2 + KL-sparsity           1.55%
Max-norm                   1.35%
Dropout + L2               1.25%
Dropout + max-norm         1.05%
Max-norm 单独使用时就以较大优势超过了 L2,而将它与 dropout 结合使用则取得了最佳结果。
深入观察:Dropout 改变了什么
1. 神经元学会了真正的特征
作者在 MNIST 上训练了两个完全相同的 autoencoder(包含 256 个 ReLU 单元),其中一个使用 dropout,另一个不使用。两者重建图像的效果大致相同。但看看神经元学到了什么:
**不使用 dropout:**特征看起来像随机噪声。单独看没有意义;它们只有作为一个纠缠在一起的整体时才有效。
使用 dropout(p = 0.5):神经元能够检测出清晰的边缘、笔画和斑点。

这就是 dropout 真正让我理解的时刻。准确率相同,但内部结构完全不同。这就是协同适应,而且可以在图像中直观看到。
2. 激活值自然变得稀疏
   Mean hidden activation without dropout:   ~2.0
Mean hidden activation with dropout:      ~0.7
使用 dropout 后,对于任意给定的输入,大多数神经元都会保持接近零,只有少数神经元会强烈激活。这就是稀疏表示,而 dropout 不需要在损失函数中加入任何稀疏性惩罚,就产生了这种效果。

应该丢弃多少?
实验 1:固定网络规模
在一个 784–2048–2048–2048–10 的网络上:
p 太低(例如 0.1):训练误差也很高,因此网络处于欠拟合状态。能够保留下来的神经元太少,无法学到有效内容。
**0.4 ≤ p ≤ 0.8:**测试误差保持平坦且较低。
**p → 1:**dropout 消失,过拟合重新出现。
实验 2:固定 pn
这是更聪明的实验。如果你丢弃神经元,那么每一层实际上只有 pn 个活跃单元。因此,作者调整网络规模,使 pn 保持不变(前两层为 256,最后一层为 512)。p 越低,网络就越宽。
在 p = 0.1 时,与实验 1 相比,测试误差从 2.7% 降到了 1.7%。最佳 p 大约为 0.6,但 0.5 的效果也很接近。
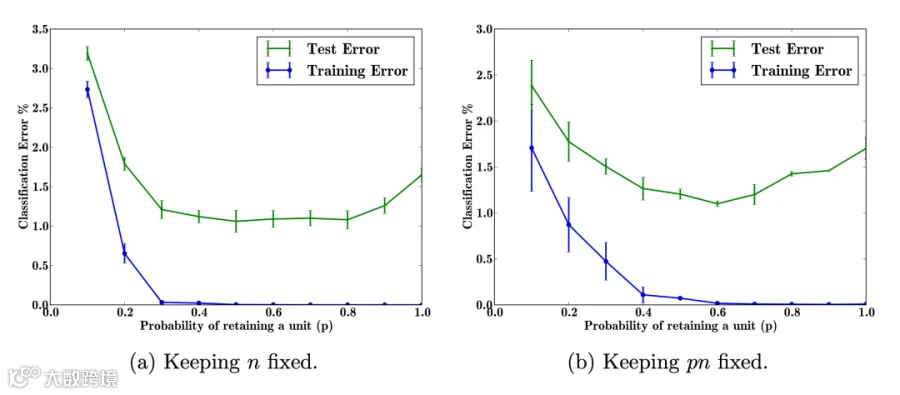
这就得出了论文中的网络规模规则:
   If n units is right without dropout,
use at least n / p units with dropout.
因此,一个不使用 dropout 时包含 512 个单元的网络,在 p = 0.5 时应扩大到大约 1,024 个单元。
实验 3:改变数据集规模
使用同一个网络,分别在 100、500、1K、5K、10K 和 50K 个 MNIST 样本上训练:
**100 和 500 个样本:**没有改善。网络规模太大,能够_穿过_噪声记住数据。
**更大的数据集:**收益先增加,随后又减少。
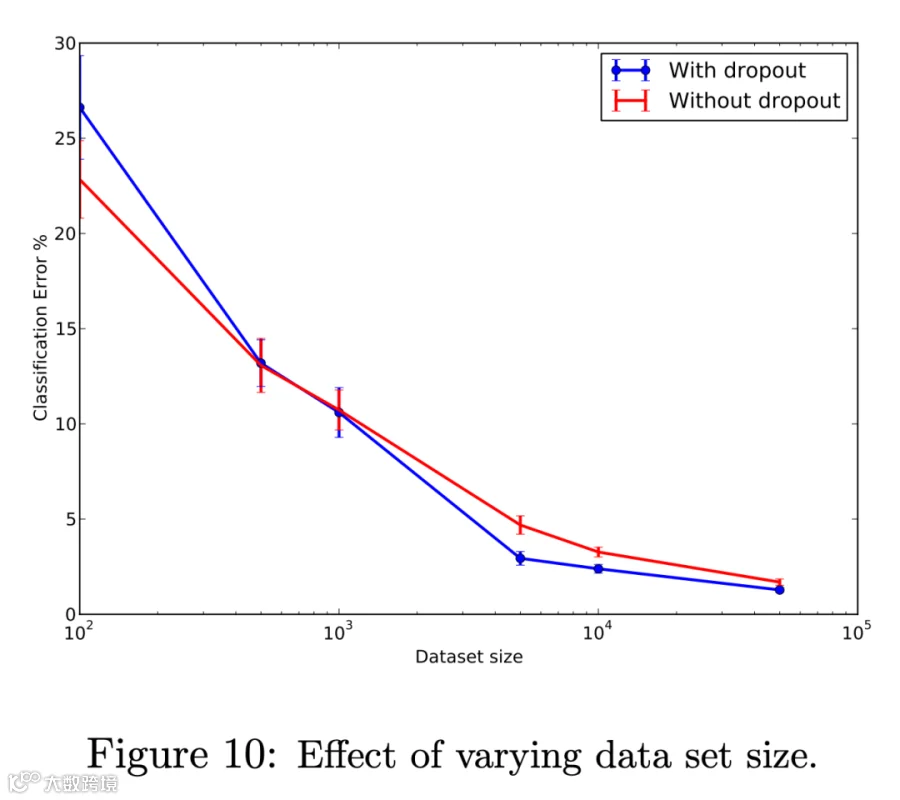
因此存在一个最佳区间:数据量足够大,使网络无法在噪声中记住数据;但又没有大到让过拟合不再成为问题。
权重缩放这个捷径效果好吗?
还记得第 4 步吗?将权重乘以 p,只是对所有 2ⁿ 个子网络取平均的一种_近似_。
更直接的方法是:在测试时采样 k 个随机 dropout 网络,让输入分别经过每个网络,然后对它们的预测结果取平均。这就是 Monte Carlo averaging,当 k → ∞ 时,它会逼近真正的平均值。
那么,需要多少个样本才能达到这个廉价捷径的效果?
**大约 k = 50。**超过这个数量后,Monte Carlo 只会略微变好,且改进幅度在一个标准差以内。

因此,使用缩放后权重进行一次前向传播,效果大致相当于运行 50 个网络。这就是 dropout 提供的方案。
意外转折:Dropout 本质上是 Ridge Regression
这是我最喜欢的部分,也是大多数教程会跳过的内容。让我们推导一下。
普通线性回归最小化:
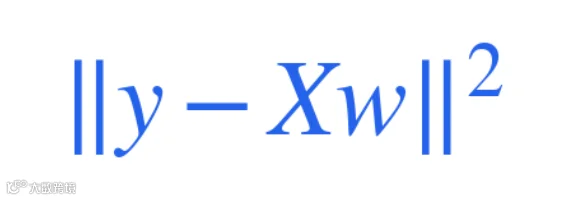
现在对输入应用 dropout。X 中的每个元素都以概率 p 被保留,使用随机掩码 R,其中每个 R_ij ~ Bernoulli(p):

**第 1 步:观察一次预测。**对于数据点 i:
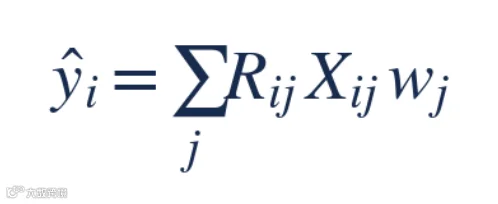
**第 2 步:计算它的均值和方差。**由于每个 R_ij 的均值为 p、方差为 p(1 − p),并且它们彼此独立:

**第 3 步:使用一个标准恒等式。**对于任意随机变量 Z,期望平方误差可以拆分为偏差部分和方差部分:

第 4 步:对所有数据点求和。
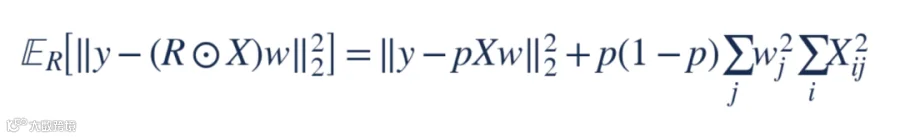
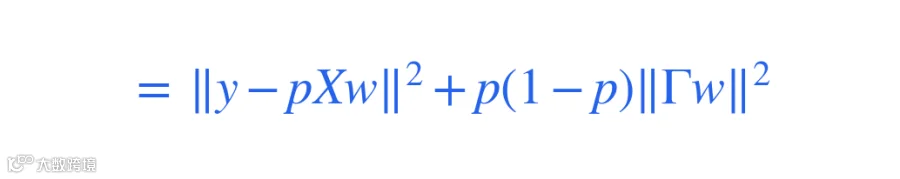
其中,Γ = (diag(XᵀX))^½,它是一个对角矩阵,保存每个特征列的大小。
第二项就是对权重施加的 L2 惩罚。因此,从期望的角度看,在线性回归上使用 dropout 等价于 ridge regression,但有一个变化:每个权重的惩罚强度会根据其特征的大小进行缩放。变化幅度较大的特征,其对应权重会受到更强的压缩。
**第 5 步:将 p 吸收到权重中。**令 w̃ = p · w:

我们的 (1 − p)/p 又出现了,这次它代表的是正则化强度:
   p = 1.0   →  0      (no dropout, no penalty)
p = 0.5   →  1
p = 0.2   →  4
Dropout 越多,正则化越强,这与直觉一致。对于深度网络,没有类似这样的简洁闭式形式,但它说明 dropout 是一种有理论依据的正则化方法,而不只是一个巧妙的技巧。
另一个转折:你甚至不需要真正“丢弃”任何东西
在论文接近结尾的部分,作者尝试用高斯分布替代抛硬币:
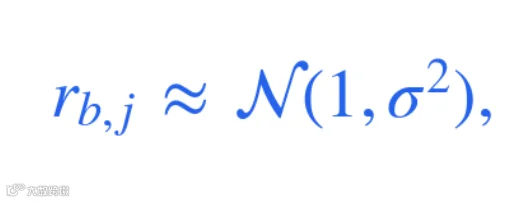
每个激活值都会乘以一个以 1 为中心的随机数。σ 应该如何选择?让它匹配我们在第 5 步推导出的 inverted-dropout 方差:
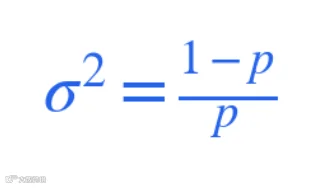
现在两种版本的均值都是 1,方差都是 (1 − p)/p。区别在于分布形状:对于给定的均值和方差,高斯分布具有可能的最大熵(随机性),而 Bernoulli 抛硬币具有最低熵。
在 10 个随机种子上取平均后的结果:
   Bernoulli dropout    Gaussian dropout
MNIST           1.08 ± 0.04%         0.95 ± 0.04%
CIFAR-10        12.6 ± 0.1%          12.5 ± 0.1%
两者都有效,而且 Gaussian 可能略好一些。因此,真正关键的因素并不是关闭神经元,而是具有正确均值和方差的乘性噪声。
另外还有一个小补充:作者还将 dropout 应用于 Restricted Boltzmann Machines,这是一种不同类型的模型,而这些“Dropout RBMs”同样学会了更稀疏的表示。这个思想并不局限于标准的前馈网络。
代价(总会有代价)
Dropout 网络的训练时间通常是相同网络不使用 dropout 时的 2–3 倍。
原因可以从上面的内容中自然推导出来:每个样本都在训练一个不同的随机子网络,因此这些梯度并不是你在测试时实际使用的那个网络的梯度。它们带有噪声,并且会部分相互抵消。
作者将其描述为一种权衡:**用更多训练时间换取更少的过拟合。**有足够的训练时间时,你可以使用更强的 dropout,从而进一步减少过拟合。
Dropout 从何而来,如今又发展到了哪里?
**之前:**Dropout 建立在 denoising autoencoders 的基础上。后者向网络的_输入_加入噪声,并训练网络重建干净版本。Dropout 将这一思想扩展到了隐藏层和 supervised learning,并将噪声重新解释为模型平均。Denoising autoencoders 在大约 5% 的噪声水平下效果最好。得益于权重缩放技巧,dropout 可以处理更多噪声:输入通常使用 20%,隐藏单元使用 50%。
之后:
Dropout 已经成为每个主流框架中的标准层。
原始 Transformer 在 attention 权重和 residual connections 上使用了 dropout(rate 0.1)。
在测试时运行 dropout,并通过测量预测结果的变化来估计模型不确定性,成为一种流行的方法,称为 MC Dropout。
在 CNN 中,Batch Normalization(2015)接替了 dropout 的部分作用,许多后来的视觉模型在卷积层中很少使用 dropout,甚至完全不使用。
在海量数据集上训练的大型模型通常很少使用 dropout。这与论文自身的发现一致:当数据充足时,过拟合并不是瓶颈,dropout 的帮助也会减小。
Dropout 速查表
   Keep probability p:
  Hidden layers          0.5 – 0.8   (0.5 is a strong default)
  Input layer            ~0.8 for real-valued inputs (images, audio)
  Conv layers            lighter dropout, e.g. 0.75–0.9
   Network size:            at least n / p units per layer
Learning rate:           10–100× higher than without dropout
Momentum:                0.95 – 0.99
Max-norm:                ||w||₂ ≤ c, with c = 3–4
Pretrained weights:      scale by 1/p, use a smaller learning rate
Training time:           expect 2–3× longer
Frameworks:              p usually means DROP probability
总结
问题:型网络容易过拟合,而对于大型模型来说,ensemble 的代价太高。
思想:训练期间以概率 p 保留每个神经元。测试时使用所有神经元,并将权重乘以 p(或者使用 inverted dropout,在训练期间将输出乘以 1/p)。
为什么有效:它同时训练 2ⁿ 个共享权重的子网络,并打破神经元之间脆弱的协同适应关系。
数学要点:
E[r·y] = p·y解释了缩放的原因;inverted dropout 的均值为 1,方差为(1 − p)/p;对于线性回归,dropout 等价于正则化强度为(1 − p)/p的 ridge regression。证据:在视觉、语音、文本和遗传学领域都有改进,同时能够得到更清晰的特征和更稀疏的激活。
代价:训练时间增加 2–3 倍。
如果这篇文章终于让你理解了 dropout,请为它鼓掌,并关注我,获取更多简单易懂的 ML 拆解。如果你错过了,我之前关于 AlexNet 的文章展示了 dropout 的第一次重大胜利。
研究论文链接:https://www.cs.toronto.edu/~rsalakhu/papers/srivastava14a.pdf