


QUOTE
一小部分专业人士,正在经历曲线变成垂直的那种眩晕。
—— 安德烈·卡帕西,10 月 11 日 X 帖
10 月 11 日,安德烈·卡帕西(Andrej Karpathy)把自己 4 月的一条帖子翻出来,加了一大段话重新发。他的意思是,大家对 AI 能力的理解差距不但没缩小,还在变大:半年前像是“两拨人各说各话”,现在更像一个越收越尖的漏斗。
这条帖子两天被看了 588 万次,2.9 万人点了收藏,收藏数接近点赞数的七成,看得出不少人是打算回头再看的。
漏斗一共四层,最上面是约 60 亿几乎没碰过大模型的人,最底下只有约 5000 人。他特意说明,这些数字是 napkin math,也就是在餐巾纸上随手算的粗略估算,别当统计数据看。
读完我第一反应是给自己对号入座。中间那两层,大概就是在看这篇文章的你我。
本文看点
01
四层漏斗各是谁
02
漏斗为什么越收越尖
03
往下走一层的五步
01
WHO
为什么他的话值得认真听
卡帕西在中文 AI 圈不算陌生。他在斯坦福读博,导师是李飞飞;读博时参与设计并主讲的 CS231n,是很多人入门深度学习的第一门课。2015 年他是 OpenAI 的创始成员之一,2017 年去特斯拉当 AI 负责人,带 Autopilot 的视觉团队,2022 年离开。2023 年他回过一次 OpenAI,2024 年 2 月又走了,同年创办了做 AI 教育的 Eureka Labs。
他还有个身份,是给普通人讲 AI 的人。YouTube 上那套《Neural Networks: Zero to Hero》,从零手写神经网络,一行行敲给你看;去年 2 月他随手发明的“vibe coding”(氛围编程)一词,后来在整个行业流行开来。他在 X 上有 436 万关注者。
所以他说“差距在变大”,分量不太一样。他一只脚站在最前沿,另一只脚一直在给普通人讲课,两头的人在想什么,他都看得到。
帖子里还有一句挺坦白的话:不到一年前,他还在一个字符一个字符地手敲代码,偶尔按一下 Tab 让编辑器补全一小段。连他都觉得这一切来得太快。
02
FUNNEL
四层漏斗,每层看到的 AI 不一样
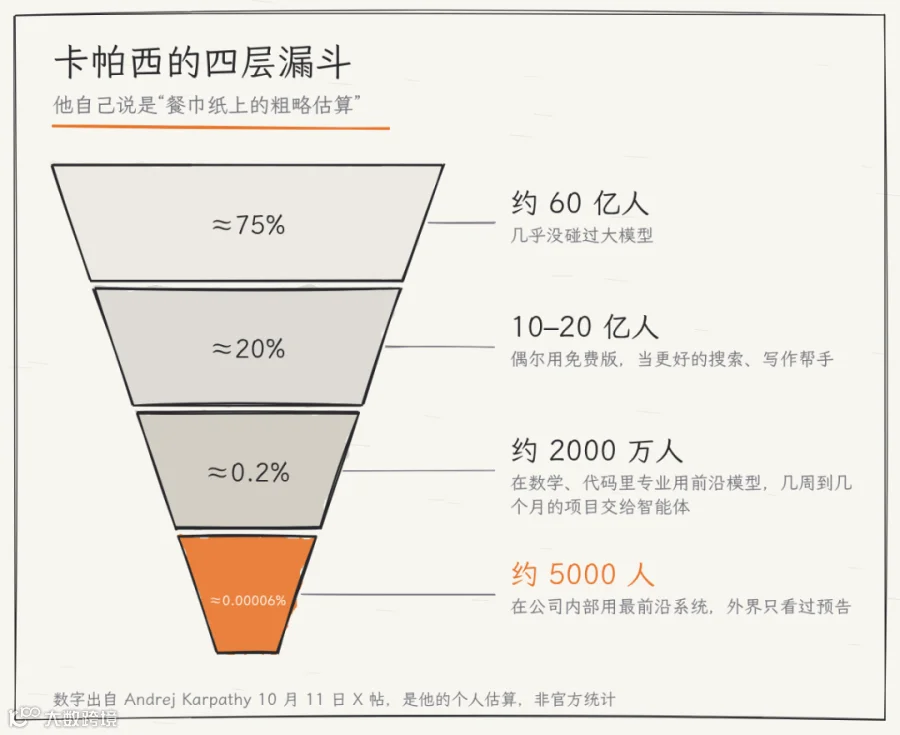
— 数字都是卡帕西自己的粗略估算
第一层,约 60 亿人,占世界人口七成五左右。他们几乎没怎么接触过大模型。AI 圈里吵得热火朝天的事,对这些人来说还不存在。
第二层,10 亿到 20 亿人,约两成。偶尔用用免费版的类 ChatGPT 产品,看到的是一个有点呆的聊天机器人,拿它当更好用的搜索、写作帮手,也许让智能体帮忙订过一张机票。他说自己有不少不搞技术的朋友觉得这东西没多大用,而且他认为这么想挺合理。
让我意外的是,他把很多专业人士也放进了这一层。数学和代码以外的行业,比如高管,大量时间花在跟人打交道上,理智上明白正在发生什么,但感受还是二手的,有点抽象。
第三层,约 2000 万人,0.2%。在数学和代码领域专业地用前沿模型。他们亲眼看到,以前要花几周甚至几个月的大项目,现在一句提示交给智能体就能做完:做应用、仿应用、把应用改写成另一种语言,甚至从二进制文件反编译出应用。
第四层,约 5000 人。能在公司内部用上最前沿系统的人。照他的描述,外界只看到了预告:成千上万个智能体连续几周协作做超大型软件项目,挖出零日漏洞,以机器的速度攻防,做出新的科学发现,推进数学前沿。这些事放在过去,要顶尖专业人士干好几年。
他接着说了一句我觉得最要紧的话:人类的审阅和理解开始跟不上了。他举了两个例子:几个月前的 OpenAI-HF 事件,到现在还有人在做“考古”;722 篇前沿数学稿件,数学家可能要啃上好一阵。这两件事的细节本号没有另外核实,这里只当作他给的例子。
第四层最抓眼球,但我更在意第二层和第三层之间那道缝。10 亿量级和 2000 万量级,差了差不多两个数量级。很多人以为自己“用过 AI 了”,其实只见过漏斗最上面那一截。
和 4 月比,变化挺明显。那时他只分了两拨人:一拨是去年试过免费版 ChatGPT、刷到语音模式被“去洗车该开车还是走路”难住的视频,就下了结论的人;另一拨是付费用 Codex、Claude Code 这类编程智能体、在编程和研究里专业使用的人,他说这拨人最容易“AI 上头”(原话是 AI Psychosis)。那条帖子被看了 704 万次。半年后,两拨人变成了四层,最底下那层是新加的。
03
WHY
漏斗为什么越收越尖

— 问题大小、能力锯齿、访问档位
他给了三个原因。
一是问题有多大。AI 的效果随你的野心、问题规模和时间跨度一起涨。一个一段话就能答完的问题,根本压不出系统的本事。照他的说法,你得手里攒着一池子又大又难、你真心在乎的问题。普通用户和专业用户的差距,主要来自这里。
二是能力是锯齿状的。这个说法他讲过很多次:模型的能力在数字化、能验证、值钱的领域冒尖。原因在训练方式上,大模型的能力来自在可验证奖励上做强化学习,训练环境怎么配,又跟哪里能赚钱有关。4 月那条他解释得更直白:写代码有单元测试,过没过一目了然;一篇文章写得好不好,很难打分。编程在企业里又更值钱,团队的大头都扑在这上面。不同行业之间的差距,主要来自这里。
三是你用的是哪一档。免费版、付费版、公司内部版,看到的根本不是同一个东西。
第二条对很多人算是种安慰。如果你的工作主要是写东西、出主意、跟人沟通,觉得 AI“没那么神”,不一定是你不会用,这些本来就不是模型进步最快的地方。反过来想,你的活里只要有能拆成“对错可以检查”的部分,那一块它很可能已经比你以为的强。
04
HOW
往下走一层,可以从这五步开始

— 前三步对应他的三个原因
漏斗不是按聪明程度分的,是按问题大小、领域和访问档位分的,这几样多少都能自己调。照他的三个原因,可以倒推出五步:前三步对应三个原因,第四步来自他 10 月 2 日的另一条帖子,第五步是本号的建议。
给自己攒一个“大问题”。别只问一段话就能答完的问题。挑一件你真在乎、平时要花几天甚至几周的事,比如把一年的账单整理成能筛选的表格,或者给自己的小生意做一个预约页面,从头到尾交给 AI 做,你只负责提要求和验收。
先在能验证对错的活上用。能用公式算、能跑一下看结果、能和原始数据对得上的活,模型最强,你也最好检查。写文案、出主意这类没有标准答案的,放到后面。
拿最新的模型重测一次旧看法。他 4 月就说过,很多人去年试了一次免费版,就让它决定了自己对 AI 的看法。如果你的印象还停在一年前,找一件当时它没做好的事,用现在能拿到的最好版本再试一次。付不付费按需,不用为了“跟上”硬买。
让它换种方式讲给你听。他说以后我们会花越来越多时间去读懂模型的输出。他的办法是:让模型照 ASD-STE100 来解释,这是一套给航空维修文档定的受控英语规范,句子短、用词严,嫌太死板就说“做到八成”;或者让它画图;再进一步,让它直接输出一个可交互的 HTML 网页。他最看好的是让模型生成定制的讲解视频,不过要配音接口才做得全。
记一本“能力日志”。每次遇到 AI 做不好的事,记一行:哪天、哪个工具、卡在哪。隔一两个月拿出来重测。漏斗的形状一直在变,你得有自己的刻度,别只靠刷到的帖子判断。
第四步可以直接复制的提示词
请用 ASD-STE100 的思路把下面这段内容解释给我,做到八成就行:句子短,一句只说一件事,只用常用词,术语第一次出现时顺带解释。然后画一张结构图,把里面的步骤和因果关系标出来。如果可以,最后输出一个单文件 HTML 页面,让我能点开每一步看细节。
第四步我觉得最被低估。他那条帖子被收藏了 8.1 万次,比 5.5 万的点赞还多。看来不少人卡在同一个地方:AI 干的活越来越多,人越来越看不懂它干了什么。他在帖子末尾的判断是,我们的工作会越来越往上走,变成监督和理解。
∞
THE END
最后说两句
对这个漏斗,我有两点保留。一是数字很粗,他自己也说是随手算的,2000 万、5000 这些量级,别拿去当行业报告引用。二是第四层外人没法核实,他也说外界只看到预告,本号只能把它当成一位业内人士的观察。
形状本身我是认的。同一时间,有人觉得 AI 是个会答错题的玩具,有人觉得它一年干完了以前好几年的活。两边说的可能都是真的,只是站在不同的层。
还有一点容易被忽略:他 4 月就提醒过,第三层的人最容易“上头”。往下走一层是为了看清楚,不是为了焦虑。他说这个时刻的怪异之处,是这一切同时发生。我们能做的,是别让自己对 AI 的判断停在漏斗最上面那一截。
□ 找一件你真在乎、要花几天以上的事,交给 AI 从头做一遍
□ 先挑有标准答案、能自己核对结果的活
□ 把一年前觉得 AI 做不好的事,用最新版本重测一次
□ 看不懂输出时,让它改用短句、画图或做成网页
□ 建一个能力日志:日期、工具、卡点,隔一两个月复测
□ 引用漏斗数字时注明:这是卡帕西的个人估算
你觉得自己在第几层?评论区说说。
往期 · 继续读
皮查伊转发的诊所AI试验
演过蝙蝠侠的阿弗莱克,会写Python,还把AI公司卖给了Netflix
想看更多 AI 落到真实生意里的做法,可以在知识星球搜「AI商业实战」,我们在那儿聊得更细。
出处:Andrej Karpathy 在 X 的公开帖子(4 月“能力认知鸿沟”、10 月 2 日“读懂模型输出”、10 月 11 日“四层漏斗”),浏览、点赞、收藏数为 10 月 13 日读取时的数据;个人履历来自公开资料。
END
我是「AI科技明星」,每天挑一位 AI 圈里值得认识的人,讲讲他做了什么、我们能学到什么。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。