


蛋白质靠不断变化的构象来完成催化、运输和折叠等生命活动。其中一些状态出现得很少,却与功能密切相关,是研究者最想捕捉的。可这些状态之间往往隔着较高的自由能势垒,常规分子动力学模拟要投入大量计算,才能观察到足够多次转变。
为此,上海科学智能研究院(下称上智院)联合复旦大学等单位提出一种新方法:在预训练蛋白质动力学模拟器的生成空间中学习历史依赖的隐式偏置。基础模拟器的参数保持不变,团队另外训练一个历史感知的score(概率密度梯度)估计器,引导采样少走已经访问过的构象;长程生成结束后,再用基础模型对结构做一次精修。
在DynamicPDB-80上,经过结构有效性筛选的多样性指标提升约35%。在12种未参与训练的Fast-Folding蛋白质上,仅加入偏置,达到基线覆盖率的探索效率最高提升约15倍;再结合精修,最高约37倍。

长程生成为何总在原地打转
生成式动力学模型从已有轨迹中学习构象变化的规律,再通过连续外推生成新轨迹。如果训练数据主要集中在少数构象区域,模型也会继承这种分布倾向,生成再久,仍停留在有限的局部区域。
传统增强采样处理过类似的问题。以元动力学为例,它根据访问历史构建偏置,把系统推向尚未充分访问的区域。研究团队把这一思路引入生成模型,在扩散采样过程中调整生成方向。
从访问历史中学习探索偏置
整个框架由两部分组成:一个冻结的动力学模拟器,和一个可训练的历史感知score估计器。前者提供生成蛋白质结构所需的反向扩散score;后者同时接收当前带噪状态、序列特征和历史构象,学习不同历史结构各自对应的去噪方向。
估计器会为历史库中的每个历史状态各估计一个score。将基础模型的score与这些score逐一作差,再加权组合,就得到偏置;权重由预测结构之间的距离决定。偏置最终加到基础模型的反向扩散score上,引导生成过程离开已访问的区域。
新构象不断加入历史库,偏置也随之更新。所以即便当前带噪状态相同,访问历史不同,得到的采样引导也不同。整个过程直接在生成空间中利用结构历史,不必为每种蛋白质预先人工指定集体变量。
探索走得太远,生成分布就可能漂移。为此,训练中还加入了环境支持正则项,约束加偏置后的单步反向转移分布与冻结模型之间的差异,让偏置尽量留在基础模型能够可靠生成结构的区域内。

图1 方法框架。历史感知score估计器在冻结模拟器的反向扩散score上加入偏置,引导生成过程探索更多构象区域。右侧展示了加偏置前后的构象轨迹差异。
用结构精修把漂移的结构拉回来
偏置越强、外推越长,生成帧就越容易偏离训练数据支持的结构区域,出现局部几何异常。
研究团队的办法是在推理阶段加入基于score的精修:先给已生成的结构加少量噪声,再用同一个冻结模拟器做少步去噪,把漂移的结构拉回模型学到的数据流形附近。
精修是对生成帧的后处理,不改变原有的轨迹历史,也不改变已学到的偏置。两者各司其职:偏置负责扩大探索范围,精修负责修正长程生成中累积的结构漂移。这样一来,即使偏置较强,探索结果中仍有较高比例能通过结构有效性筛选。
多样性提升35%并迁移至另一模型骨干
短程评估在DynamicPDB-80上进行。这个测试集包含80种来自独立序列簇的蛋白质,每种生成256帧轨迹。评估时,团队同时考察结构几何、肽键和原子碰撞等有效性指标,以免把结构失真造成的差异误当作有价值的多样性。
在研究使用的冻结模拟器上,加入偏置后,合规构象多样性指标mDiv-mean由0.181升至0.245,增幅约35%。该指标先在多个结构有效性阈值下筛选生成帧,再对多样性结果取平均,也就是说,严格筛选之后,偏置带来的提升依然存在。不过,部分结构有效性指标也有所下降,说明探索范围与结构质量之间存在权衡。
团队还在冻结的ConfRover模型上训练了对应的偏置估计器,mDiv-mean由0.179升至0.212。可见,历史依赖偏置的思路可以迁移到另一种动力学生成模型骨干上。
零样本测试中构象探索最高加速约37倍
长时间的零样本生成测试在12种Fast-Folding蛋白质上进行。仅使用偏置时,按达到相同低能态覆盖率所需的帧数计算,效率最高提升14.8倍。但偏置不能一味加大:继续增强会损害结构质量,更多生成帧无法计入有效覆盖,探索收益随之下降。
有了精修,模型就能用上更强的偏置。偏置强度为0.2时,通过结构有效性门槛的帧比例由28.3%回升至94.8%,达到基线覆盖率的帧数效率是无偏基线的37.5倍,最大低能态覆盖率是无偏基线的3.3倍。
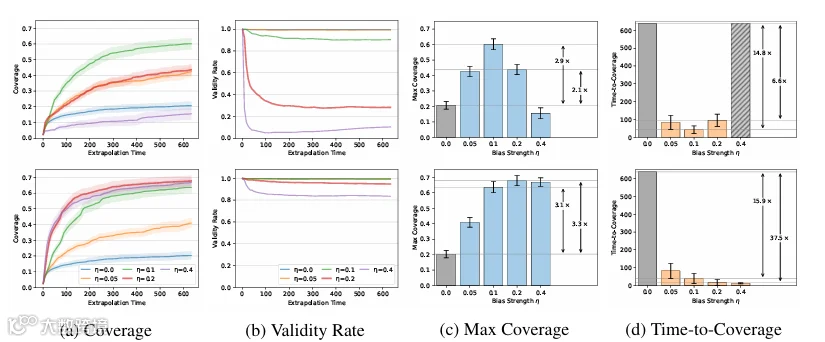
图2 Fast-Folding蛋白质的长时间生成测试。上行为精修前,下行为精修后;从左至右为低能态覆盖率、累计结构有效率、最大覆盖率,以及达到参考覆盖率所需的外推段数(TTC)。斜线柱表示在生成预算内未达到参考覆盖率。结果汇总12种蛋白质,每种使用3个随机种子;误差为标准误。
上述加速倍数按各方法达到相同参考覆盖率所需的帧数计算,没有计入偏置估计和精修带来的额外推理开销。低能态覆盖率则依据参考MD轨迹在二维时间滞后独立成分分析(TICA)空间中的自由能分布定义,只统计通过结构有效性门槛的生成帧。
对照实验还显示,只对无偏轨迹做精修,最大覆盖率并不会提高。这印证了两个模块的分工:额外的探索能力来自历史依赖偏置,精修的作用是让这些探索结果通过结构有效性筛选。
在代表性蛋白质上覆盖更多低能区域
构象空间的可视化更直观。低能态覆盖率在Protein G上由0.29升至0.88,在WW domain上由0.44升至1.00,在α3D上由0.46升至0.73。加偏置后的轨迹进入了无偏基线未能充分访问的亚稳态区域。
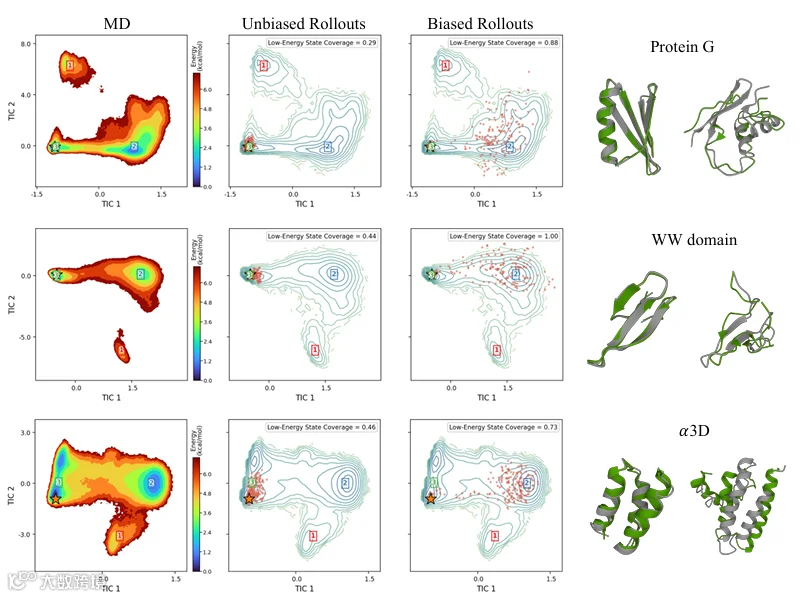
图3 三种代表性蛋白质的构象覆盖。从左至右依次为参考MD自由能面、无偏生成轨迹、加偏置生成轨迹,以及参考结构与代表性生成结构的叠合。红点为生成帧在TICA空间中的投影,黄色星标为输入结构。
应用前景与当前边界
这项工作为已有的蛋白质动力学生成模型提供了一种增强探索能力的办法。无论是学习偏置还是推理,基础模拟器始终保持冻结;额外学习的模块根据访问历史调整采样方向,精修则复用基础模型自身的结构生成能力。
有效构象覆盖扩大后,有望为隐蔽结合口袋识别、变构状态研究等任务提供更多候选结构。不过,目前验证的只是构象探索能力,这些下游应用还有待进一步评估。
方法目前的边界也很清楚。目前该方法还不支持朝指定目标构象做条件化探索;能访问的范围仍受冻结模型训练分布的约束;基础模拟器并不以平衡分布为直接目标,因此偏置轨迹还难以用于严格的自由能估计。
后续工作可以加入目标构象条件,提高采样的可控性;也可以在适当重新训练基础模拟器后,拓展到多链复合物和核酸动力学。如何把探索得到的轨迹与可靠的自由能估计结合起来,是这一框架继续发展的重要方向。