

AI × 蛋白质设计
摘要
针对现有蛋白质设计模型需要为不同性质设置专门输入格式的问题,研究团队提出自然语言条件化的全原子结构生成模型 Prompteina。团队构建了包含约180万条结构条目、5240万条文本描述的配对数据集,通过全局文本条件、逐词交叉注意力及文本—残基对齐训练,使模型能够同时生成蛋白质结构与序列。在18项结构控制任务中,Prompteina有15项表现领先;与语言模型智能体结合后,其结合蛋白设计在多靶点计算评估中取得更高的界面置信度。针对GM2A的实验从89个受测设计中识别出9个结合蛋白,最强者三次重复的总体表观K_D约为107 nM。
论文信息
原文标题:Designing Protein Structures from Natural Language
发布平台:arXiv
预印本发布日期:2026-10-09
第一作者:Joseph Lee(University of Washington)
作者单位
University of Washington(华盛顿大学)
National University of Singapore(新加坡国立大学)
Allen Institute for AI(Ai2)
Howard Hughes Medical Institute
01
把设计要求直接写成自然语言
从头设计蛋白质,通常不仅要得到一个能够折叠的结构,还要指定它的整体形状、折叠类型、局部相互作用以及与靶标接触的方式。现有模型可以控制其中不少性质,但往往需要不同的标签、坐标约束或残基级输入。设计要求越复杂,转换成模型可接受输入的过程也越繁琐。
Prompteina尝试提供统一的自然语言接口:描述可以同时包含“以α螺旋为主”“具有若干二硫键”“采用特定结构域排列”,也可以进一步指定结合界面的残基数量和化学特征。模型直接以文本为条件,联合生成全原子结构与氨基酸序列。
在结合蛋白设计中,输入仍包括靶标结构、蛋白质长度,以及可选的靶标接触残基。自然语言负责承载更丰富的设计要求;语言模型智能体则可以先检索靶标信息,再把研究结果写成模型能够执行的描述。

图 1|Prompteina的整体工作流程。a,自然语言描述整体与残基级性质,模型联合生成结构和序列;b,智能体分析靶标并提出结合蛋白设计,随后开展实验检测,图中68.8 nM为最强设计的一次重复拟合值;c,不同结构预测模型下的界面置信度比较。
02
180万条结构,让文字与残基建立对应
训练数据来自PDB实验结构、AlphaFold数据库预测单体,以及Teddymer合成二聚体。研究者以单条蛋白链作为独立条目,汇总约180万条结构,并从数据库字段、文献和原子坐标中整理结构与功能注释。不同数据源的注释类型不同,PDB条目最多涉及59类性质。
团队使用Qwen3-235B-A22B,将不同注释子集改写为自然语言描述,最终得到5240万条文本,平均每个结构约29条。文本既包含整体折叠、紧凑程度和形状,也包含二硫键、催化位点及蛋白质间接触等信息;其中部分描述明确给出残基位置。
模型在Complexa基础上引入两条文本条件通路:整体文本表征经自适应层归一化传入每个残基;逐词表征通过交叉注意力,使不同残基可以关注与自身有关的文字。对于能够定位的注释,再建立文本片段与残基集合之间的监督对应。
训练先让新增文本模块适配预训练结构模型,再联合持续预训练,最后进行文本—残基对齐微调。推理时不需要保留对齐预测头,冻结的变分自编码器负责把生成的骨架坐标与侧链潜变量解码为全原子结构和序列。
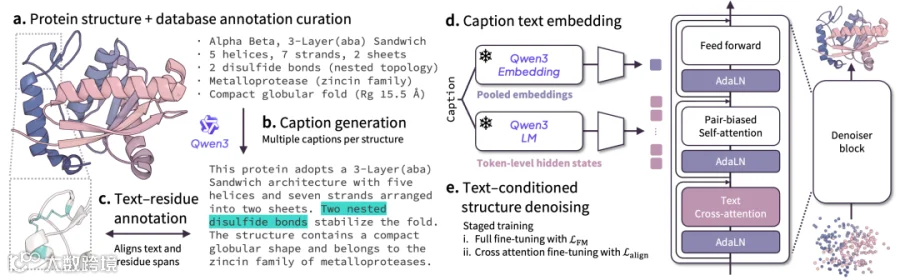
图 2|文本—结构数据及模型训练。a–b,整理结构与功能注释并生成多样化文本;c,建立描述片段与残基的对应;d,整体和逐词文本表征分别进入生成模型;e,流匹配训练之后进行对齐微调。
03
从整体折叠到局部相互作用,能控制到什么程度
研究设置了18项结构控制任务,覆盖折叠与拓扑、二级结构、三级结构、整体形状和表面性质,以及多性质组合。Prompteina在其中15项领先,并能用同一接口处理多结构域组合和“折叠类别+局部数量”这类复合要求。
具体来看,CATH折叠类别准确率为96.0%,结构架构准确率为51.1%;螺旋数量的请求值与生成值之间,Spearman相关系数为0.94。不过,不同性能并不均衡:二硫键数量的相关系数约为0.29;在β链和β片层数量控制上,接受逐残基二级结构输入的RFdiffusion表现更好。

图 3|自然语言控制蛋白质的不同结构性质。示例包括杆状外形、多结构域排列、箱状折叠、七重内部循环对称性,以及折叠类别与二硫键数量的组合。所示结构均满足文中采用的计算可设计性标准。

表 1|结构性质控制的基准比较。a,各类自由文本模型在五组任务上的平均表现;b,与使用专门标签或结构化输入的模型比较。准确率与相关系数是不同指标,不能直接互换;“—”表示该模型输入接口不支持相应任务。
作者还在控制蛋白质长度、改写提示词等设置下检查了结果。例如,对每个请求数量使用同一组长度时,螺旋数量控制的相关系数仍为0.878,而空提示词对照接近零。这支持模型确实利用了文字条件,而不仅仅依靠长度与结构数量之间的关系。
对于功能描述,研究评估了122个蛋白质家族,并采用ProTrek衡量生成序列或结构与文字的相似性。Prompteina的最优提示格式取得最高均值;引入pLDDT加权后,对Pinal的优势在序列相似性上得到统计支持,结构相似性差异仍不确定。这里衡量的是与功能描述的计算一致性,并非逐一验证了催化、荧光等实际功能。

表 2|基于功能描述的生成评估。比较ProTrek序列相似性和结构相似性,并给出pLDDT加权结果。每个模型取四种提示格式中的最高均值,区间来自122个家族的bootstrap分析。
04
让智能体的界面设计要求进入生成过程
结合蛋白设计不仅取决于骨架,还取决于它怎样与靶标接触。研究者首先只改变提示词要求的界面残基数量,在20个靶标上分别请求8—30个界面残基,并固定各靶标的长度分布和结构输入。
请求数量与实际生成数量的均值高度相关,各靶标Spearman相关系数为0.994—1.000。这说明界面规模能够随文字要求稳定变化,但不同靶标的响应斜率不同,高相关不等于每个设计都精确达到指定数量。

图 4|用文字调整结合界面的残基数量。a,20个靶标的请求值与平均生成值,阴影表示跨靶标分布;b–d,TrkA结合蛋白示例,请求8、14和24个界面残基,分别生成8、13和24个。
随后,同一个Claude Opus 4.6智能体为不同设计模型检索靶标资料,并通过各模型支持的接口编写设计要求。每种方法在每个靶标上生成200个候选。研究分别比较原生序列、ProteinMPNN完整重设计,以及固定界面残基的序列重设计。
在原生序列条件下,Prompteina的期望top-k界面置信度ipSAE_min为0.455,最高基线Complexa为0.400,对应约13.8%的相对提升。完整ProteinMPNN重设计后,两者差距及与其他基线的差距缩小;Prompteina仍有最高总体期望top-k得分,但并非在所有候选保留数量下都领先。

表 3|20个靶标的界面置信度与结构多样性。self为模型生成序列,MPNN为完整序列重设计,MPNN-FI为固定界面重设计;Agent表示是否由智能体编写设计要求。ipSAE_min是预测界面置信度,不是实验亲和力。
消融实验进一步显示,允许智能体描述界面性质,比仅描述折叠和形状带来更明显的提升:期望top-k得分从0.364升至0.455。以CD45为例,智能体能提出界面大小、疏水性、氢键与几何形状等要求,Prompteina将这些要求直接作为生成条件。
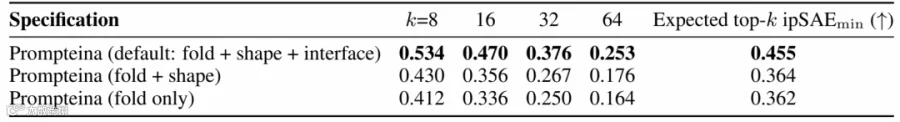
表 4|设计要求的消融比较。三种设置依次允许描述折叠、折叠与形状,以及折叠、形状与界面。结果基于生成序列,体现不同输入范围对完整设计流程的影响。
05
通过计算反馈,逐轮修改设计提示
作者进一步把200个候选的预算拆分为4轮,每轮50个。智能体读取已生成设计的结构评分、序列重设计结果和原始要求,再提出下一轮方案。对照使用相同预算的独立生成,以区分反馈迭代的收益与单纯增加候选数量的收益。
在Claudin-1示例中,智能体先尝试更换拓扑,再调整界面规模,所展示设计的ipSAE_min从0.667提高到0.737,再到0.802。在最难的7个靶标上,Prompteina的top-8平均评分增益为0.105,BoltzGen为0.067,前者的增益约高57%。这指的是相对非迭代生成的计算评分增益,不是实验命中率提高57%。

图 5|Claudin-1上的迭代提示优化。a,相对于相同预算独立生成的累计top-1界面置信度增益;b,智能体的规划片段及选出的结构,展示拓扑和界面参数如何随反馈更新。
06
GM2A实验:89个设计中识别出9个结合蛋白
实验对象是GM2神经节苷脂激活蛋白GM2A。论文指出,该靶标此前尚无已报道的从头设计结合蛋白,在先前一次30个设计的测试中也未获得命中。
本次流程共生成1000个骨架,并为每个骨架构建33个序列版本,包括模型原生序列、ProteinMPNN和SolubleMPNN重设计序列及各自的固定界面版本。经过序列筛选、多个结构预测模型与随机种子的复核,再选出90个不同骨架对应的序列送往实验检测。
最终89个设计进入表面等离子体共振(SPR)检测,其中9个被判定为结合蛋白,8个能够拟合总体表观K_D,6个达到亚微摩尔范围。按89个受测设计计,6个亚微摩尔结合蛋白对应约6.7%的命中率。
最强者的总体表观K_D为107.4 nM,95%置信区间为80.9—142.5 nM;三次重复分别为68.8、129.1和137.6 nM。其最终受测序列经过ProteinMPNN重设计。六个亚微摩尔结合蛋白具有不同的预测架构,但均指向GM2A的W94附近表面;图中的复合物是计算预测结构。

图 6|GM2A结合蛋白的实验验证。a,六个亚微摩尔结合蛋白的预测复合物,按总体表观K_D排列;b,最强设计的智能体推理与提示;c,该设计在五个分析物浓度下的三次SPR重复,标注各次拟合的表观K_D。
07
补充结构与界面证据
附录进一步展示了文本控制的结构范围、各靶标的界面响应,以及智能体为同一靶标提出不同设计的实例。单体的“可设计性”采用ProteinMPNN生成8条序列并经ESMFold回折后的最佳scRMSD评价,阈值为2 Å;它属于计算自洽性检验。
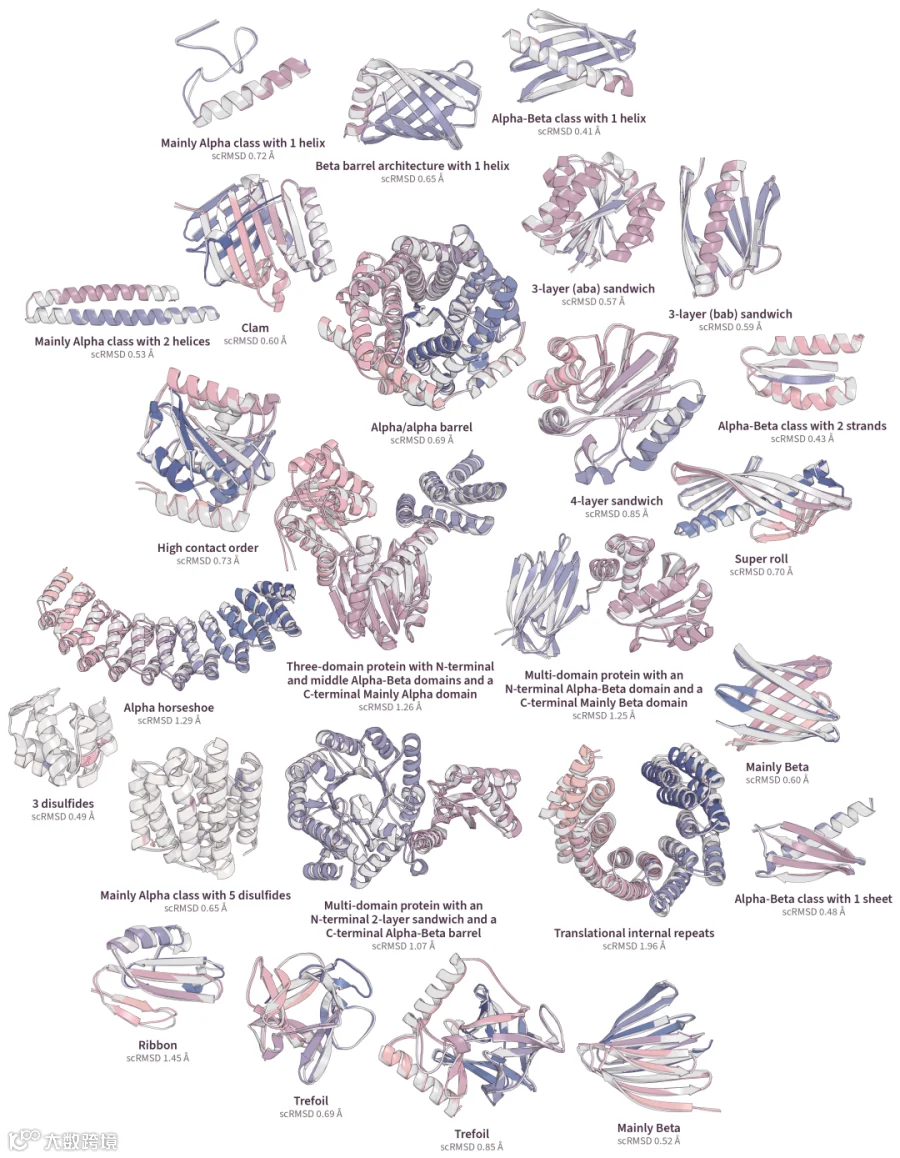
图 7|更多单体设计及回折对照。彩色为生成结构,浅灰为八次ProteinMPNN—ESMFold回折中最匹配的结构;标签给出请求的性质与scRMSD。

图 8|20个靶标的界面残基数量响应。每个请求数量生成50个结合蛋白,色带表示一个标准差;斜虚线为请求值与生成值相等,横向点线为无条件生成的平均值。
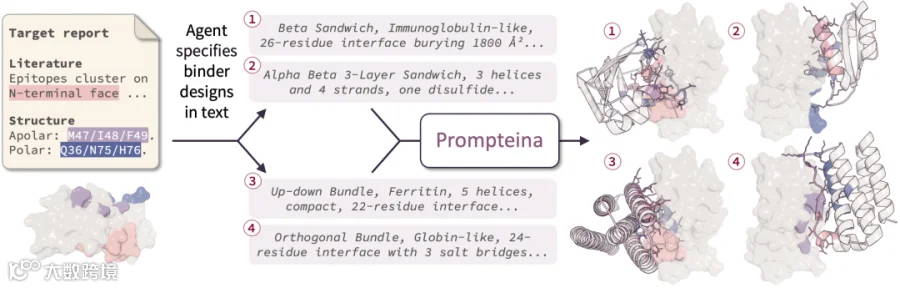
图 9|CD45的不同设计方案。智能体结合文献和结构分析,提出不同折叠、接触位置与界面性质,Prompteina据此生成相应结构。
08
讨论与展望
作者认为,这项工作的核心在于让自然语言成为连接科学知识、设计推理与结构生成的统一接口。随着语言模型智能体能力提升,专业生成模型需要更充分地接收智能体提出的要求,使检索到的靶标信息和迭代反馈能够作用于结构设计。
论文也记录了当前评估的边界:训练文本的抽样检查发现,语言模型有时会把定性注释扩写为没有依据的具体数字;计算评分的校准数据并非完全独立,也不能据此推算新靶标的绝对实验命中率。本研究完成了计算反馈驱动的迭代以及GM2A终点实验验证,将真实实验反馈进一步纳入迭代流程,是作者提出的后续方向。
参考文献
[1] Lee J, Li Y, Qiang B, et al. Designing Protein Structures from Natural Language. arXiv:2610.13917v1. DOI: 10.48550/arXiv.2610.13917.