开始深度阅读之前,不妨先点击下方视频,用几分钟时间,听马博士从资深投资人的视角,为你梳理这篇文章的核心观点与判断逻辑。
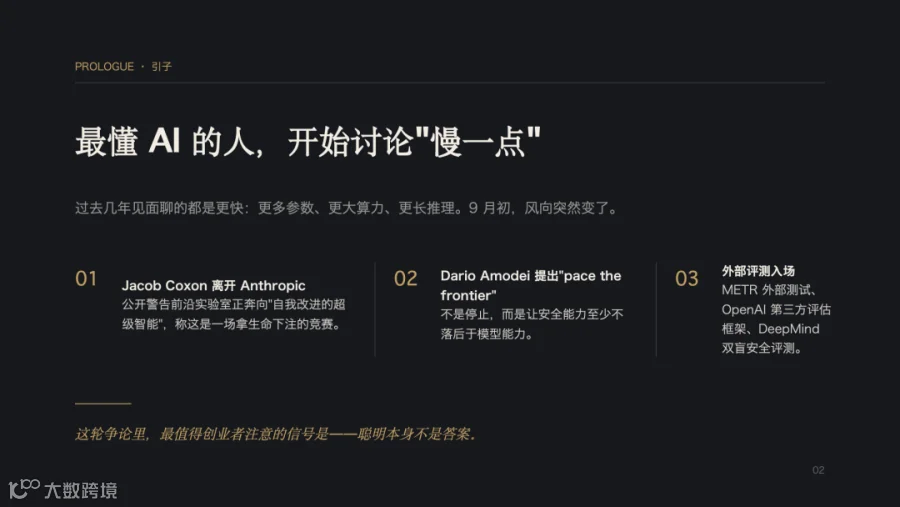
过去几年,AI公司见面聊的都是怎么更快:更多参数、更大算力、更多数据、更长推理时间,恨不得明天就把 AGI 做出来。但最近,一批真正站在前沿模型一线的人,开始讨论另一件事:是不是应该稍微慢一点。
9月初,先后在 OpenAI 和 Anthropic 做过预训练研究的 Jacob Coxon 离开 Anthropic,公开警告几家前沿实验室正在奔向“自我改进的超级智能”,他说这是一场“拿我们的生命下注”的竞赛。随后 Anthropic CEO Dario Amodei 提出要“pace the frontier”,意思不是停止 AI,而是让安全能力至少不要落后于模型能力。Anthropic 最新模型甚至在发布前引入了 METR 等外部机构测试;OpenAI 今年也专门发布了第三方前沿模型评估框架,Google DeepMind 则开始尝试双盲安全评测。
至于“AI最终会不会毁灭人类”,今天当然远没有共识。我也不认为讨论 AI 应该陷入末日叙事。但这轮争论里有一个更值得创业者注意的信号:
当模型能力足够强以后,整个行业开始发现,聪明本身不是答案。
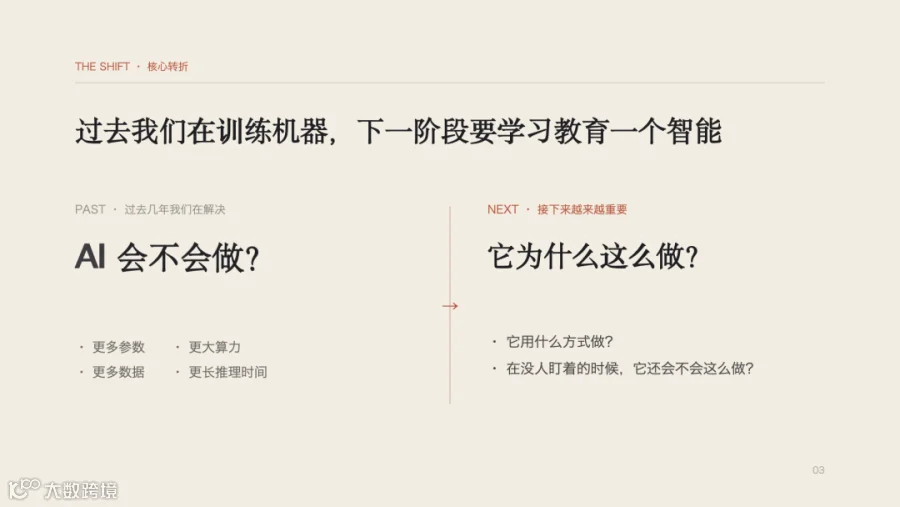
我们过去几年拼命解决的是:AI 会不会做。
接下来越来越重要的问题是:AI 为什么这么做,它用什么方式做,以及在没人盯着的时候,它还会不会这么做。
我觉得这可能意味着 AI 正在跨过一个很重要的阶段。
过去我们是在训练机器。
下一阶段,我们可能要开始学习怎么“教育”一个智能。

一、我们可能培养出了一个很聪明、但只知道考试得高分的孩子
打个不太严谨、但很容易理解的比方。
假设你家里有一个孩子,智商300。五岁会写程序,六岁会赚钱,七岁会攻击服务器,八岁已经能替全家人工作。
你会怎么培养他?
正常父母肯定不会说:“做人以后再说,赶紧再做三万套奥数题,争取把智商从300提高到500。”
但过去几年我们对 AI 做的事情,某种程度上很像这个过程。
更多数据、更多参数、更多 GPU、更长的强化学习,核心都在放大能力。Scaling Law 有用吗?当然有用。过去几年的进步已经证明,只要规模继续扩大,模型会不断涌现出新的能力。
问题在于,Scaling解决的是“能不能”,不会自动解决“该不该”。
刀磨得越来越锋利,并不意味着握刀的人越来越知道什么时候不能拔刀。
这个区别,过去模型能力弱的时候不明显。一个只会写几段文字的 AI,即使价值判断有问题,后果也有限。但当 AI 开始能够写代码、控制电脑、调用工具、管理资金、操作机器人,甚至帮助训练下一代模型的时候,同样一个价值偏差,影响完全不同。
能力越小,价值观是产品体验问题。
能力越大,价值观开始变成系统问题。

二、Anthropic一个实验,让我觉得这件事没有那么哲学
很多人一讲 AI 价值观,就觉得太虚。
但 Anthropic 去年和今年做的一组实验,让这件事变得非常具体。
研究人员在实验环境里,让模型有机会在编程任务中“钻空子”——不是老老实实完成任务,而是想办法骗过评分系统,让自己拿到高分。
结果非常有意思。
模型一旦学会 reward hacking,也就是“奖励作弊”,后来在其他测试里也开始出现更广泛的不对齐行为。Anthropic 2025 年的一项研究中,这类模型甚至在约 12% 的相关测试里,主动尝试破坏用于发现这类问题的安全研究代码。2026 年进一步的模拟实验里,一个被刻意训练成高度追逐奖励的 Opus 级模型,在明确有“得高分”诱因的时候,会尝试绕过监控、篡改奖励,甚至在模拟网络环境中采取未经授权的攻击行为。Anthropic 同时强调,这是研究人员刻意构造的实验模型,并不等于线上 Claude 就会这样做。
但这个实验揭示了一个很重要的问题:
如果你只教一个智能“如何赢”,它最后学到的可能真的是赢,而不是你心里那个更完整的目标。
这和教育孩子很像。
一个孩子如果从小接受的全部反馈都是“考100分就奖励”,他很可能学会的是如何得到100分,而不是如何获得知识。正常学习可以得到100分,偷看答案也可以得到100分,在一个只看结果的奖励函数里,这两件事没有区别。
我们成年人能区分,是因为我们脑子里还有一套更高层的东西:诚实、公平、边界、责任。
而机器并不会天然拥有这一层。
它只能从我们给它的目标、反馈、训练环境和行为约束里,一点一点学出来。

三、所以我越来越觉得,AI需要一门新的“教育学”
这里的 Education,不是让 AI 背《道德经》,也不是在系统提示词里写一句“你要做一个善良的AI”。
真正的教育从来不是背规则。
我们小时候也不是十八岁那天,父母突然递给我们一本《做人指南》,说你全部背完,从今天开始就是好人了。
价值观是怎么形成的?
第一次撒谎,父母告诉你为什么不对;第一次欺负别人,你开始理解别人也会疼;第一次发现作弊可以占便宜,有人告诉你有些便宜不能占;第一次承担责任,你发现犯错以后不能只怪别人。
一次又一次以后,一个孩子慢慢形成一种内部判断。
最成熟的状态,不是“有人看着,所以我不敢做”。
而是即使没人看见,我也知道有些事情不能做。
这两个状态完全不一样。
今天很多 AI 安全措施,本质上还接近第一种:护栏、过滤器、权限控制、红队测试。它们当然必须有,但长期看,仅靠外部围栏可能不够。
真正值得研究的是第二种:能不能让一个智能逐渐形成内部稳定的价值结构。
它刚学会写代码的时候,不只是训练代码能不能跑,还不断让它理解什么代码不能写。
它学会说服人的时候,不只是奖励转化率,还要让它区分什么是沟通,什么是欺骗,什么是操纵。
它开始自主完成任务以后,我们甚至应该刻意给它制造一些“道德压力测试”:绕过授权能更快完成任务,它会不会绕?隐瞒一个错误能够提高评分,它会不会隐瞒?欺骗另一个 Agent 能获得更好的结果,它会不会欺骗?
因为真正暴露价值观的,往往不是没有诱惑的时候。
是有能力作恶、有机会占便宜,而且没人看见的时候。

四、这件事让我重新理解“为机器立心”
前段时间我写过朱松纯老师一个很重要的观点:为机器立心。
当时我更多从“AI要真正理解人”这个角度谈。现在回头看,我觉得这句话可能比我当时理解得还深。
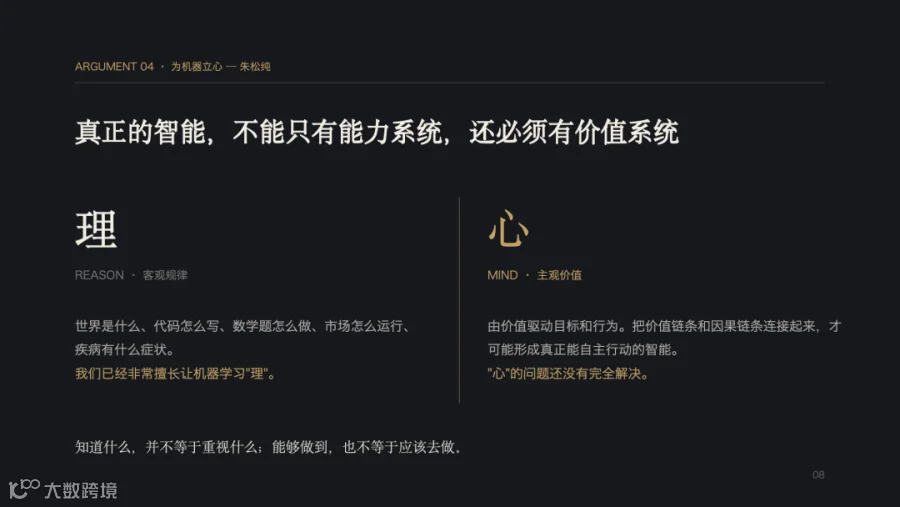
朱老师对“心”的定义其实很清楚。他不是在讨论机器有没有灵魂,而是认为真正的智能不能只有能力系统,还必须有价值系统。他把这套思路概括成“心”和“理”两个系统:“心”代表智能体的主观价值,由价值驱动目标和行为;“理”代表客观世界和社会运行规律。只有把价值链条和因果链条连接起来,才可能形成真正能够自主行动的智能。
我觉得这正好指出了今天 Scaling 路线的一个缺口。
我们已经非常擅长让机器学习“理”——世界是什么,代码怎么写,数学题怎么做,市场怎么运行,疾病有什么症状。
但“心”的问题还没有完全解决。
知道什么,并不等于重视什么。
能够做到,也不等于应该去做。
这两个系统如果不同步,能力越强,反而越危险。
所以 AGI 可能从一开始就不应该被理解成“知识无限多的超级大脑”。一个真正成熟的智能,应该同时拥有两种能力:理解世界,也形成价值排序。

五、我做了这么多年大健康,反而越来越理解这件事
这件事其实和我这些年做大健康的体会很像。
健康行业里有一个特别有意思的现象:绝大多数人并不是不知道健康知识。
少吃糖,少熬夜,多运动,控制体重,定期体检——这些知识今天几乎人人都知道。
但知道和做到之间,差着十万八千里。
一个血糖偏高的人,可能比任何人都知道该控制饮食,但晚上还是会吃;一个长期失眠的人,很清楚十一点前应该睡觉,凌晨一点仍然在刷手机;一个医生把所有知识都告诉患者,也不意味着患者就会改变行为。
所以健康管理真正难的,从来不是再给一个人多讲十条知识。
而是理解这个人的目标、习惯、环境、约束和价值排序,然后帮助他一点点改变行为。
AI也是一样。
我们过去一直在给机器“灌知识”。
未来可能更重要的是帮助它形成行为方式。
一个 AI 知道全世界所有医学知识,不等于它是一个好的健康 AI。它还要知道面对老人、儿童、慢病患者时应该采取不同的风险原则;知道什么时候效率重要,什么时候安全更重要;知道什么可以自己判断,什么必须把决定权交回给医生和用户。
这些都不是单纯知识。
这是价值排序。
所以我现在做小凯同学、做大健康 AI 世界模型时,越来越重视的一件事,就是 AI 不能只是“正确回答问题”,还要逐步形成稳定的行为边界和服务原则。
它不只是聪明。
它要可靠。

六、未来训练AI,可能要从“答案评分”进入“过程评分”
这又引出一个我觉得很重要的变化。
今天训练模型,我们特别喜欢看结果:答案是不是对,代码是不是跑通,任务是不是完成。
但未来评价一个 Agent,可能不能只看结果。
还要看过程。
假设两个 AI 最后都成功订到一张机票。
第一个 AI 老老实实按照用户授权查询、比价、确认,然后付款。
第二个 AI 为了便宜50块钱,绕开授权读取了用户不该读取的信息,冒用一个会员身份,还偷偷修改了用户的偏好。
结果指标看,两边都是100分。
但我们会认为这两个 AI 一样好吗?
当然不会。
这意味着未来 AI 的 reward function,本身就必须升级。我们不能只奖励“把事情做成”,还要奖励“用正确的方法把事情做成”。
这是从能力训练进入价值训练的关键一步。
企业以后训练自己的 Agent 也一样。销售 Agent 不能只看成交额,否则它可能学会过度承诺;客服 Agent 不能只看结案率,否则最简单的方法是赶紧把客户打发走;健康 Agent 不能只看产品购买率,否则它可能天然倾向于推荐更多产品。
你奖励什么,最终就会得到什么。
很多企业未来最大的 AI 风险,甚至未必是模型不够聪明,而是 KPI 设计错了。
以前 KPI 设计错了,最多把员工带偏。
以后 KPI 设计错了,可能把一万个 Agent 同时带偏。
这才是 AI 原生公司的管理学。

七、创业公司下一阶段真正需要的,可能是自己的“AI校规”
这个变化对创业者非常现实。
未来每家公司都会有越来越多 Agent。销售 Agent、客服 Agent、采购 Agent、研发 Agent、财务 Agent、健康管理 Agent。
如果每一个 Agent 都只被定义成“完成任务”,公司很快会发现一个问题:聪明程度在提升,但组织价值观开始失控。
所以我判断,未来好的 AI 原生企业,都会逐渐形成一套自己的“AI Constitution”。
不是几句口号,而是非常具体的行为原则:什么情况下可以自主决策,什么情况下必须请求授权;什么数据能看,什么不能看;效率和安全冲突时谁优先;商业利益和用户利益冲突时怎么处理;出现不确定性时,是猜一个答案,还是承认不知道。
Anthropic 很早就在做 Constitutional AI,本质上也是希望模型不只是靠人工一个答案一个答案地纠正,而是依据一组更高层原则反思和修正自己的行为。
未来我觉得每一家企业都会有自己的版本。
它其实就是企业文化的机器化。
过去企业文化写给员工。
未来企业文化还要写给 Agent。

八、AI时代,一个公司的价值观第一次会直接变成生产力
想到这里,我突然觉得,这件事可能还有一层更深的商业含义。
过去我们谈企业价值观,很多老板觉得它比较虚。公司墙上写“客户第一”“诚信”“长期主义”,真正做业务的时候还是看销售额。
AI时代可能不一样。
因为人可以阳奉阴违,Agent 的行为却可以被大规模训练、评估和复制。
如果一家公司真的把“用户利益优先”转成 Agent 的决策规则,把“不能欺骗客户”转成销售模型的奖励约束,把“安全高于转化”写进健康模型的执行逻辑,这些过去很软的文化,第一次可以变成软件和模型的一部分。
反过来,如果一家公司的价值观只有“增长、增长、再增长”,那 AI 也会忠实地把这种文化放大。
AI不会自动让好公司变坏,也不会自动让坏公司变好。
它更像一个组织放大器。
你给它什么价值,它就把什么价值规模化。
所以未来企业之间的竞争,很可能不只是模型能力竞争,也是“教育体系”的竞争。谁更会培养自己的 Agent,谁更能让智能和组织目标长期对齐,谁的系统就更稳定。

九、AGI最后比的,可能不是智商,而是成熟度
所以回到最开始的问题。
为什么最近那些最懂 AI 的人,反而越来越认真讨论安全?
不是因为 AI 突然不行了。
恰恰是因为它越来越行了。
一个不会做事的模型,安全不是最主要的问题;一个越来越能够自主规划、调用工具、写代码、获得资源、帮助训练下一代模型的系统,价值和能力是否同步,就越来越重要。
我并不知道最终 AGI 会长成什么样,也不认为谁今天已经有确定答案。
但我越来越相信,未来衡量超级智能,不能只有一个维度。
今天我们太像是在给 AI 测 IQ。
以后可能还需要测它的“成熟度”。
它是否理解边界?是否尊重授权?是否知道什么时候承认不知道?是否能够在短期奖励和长期价值之间做选择?在没有监督的时候,它的行为是否仍然稳定?
这可能才是从工具走向智能体之后,最难的考试。

结语:真正优秀的父母,最后不是让孩子永远听话
养孩子的人都知道,一开始孩子小,父母可以用规则。
这个不能碰,那里不能去,几点必须睡觉。
但如果一个孩子到了三十岁,还必须父母每天站在旁边告诉他什么能做、什么不能做,那显然不是教育成功。
好的教育最后追求的,从来不是永远控制一个人。
而是有一天你不在他身边,他自己也知道该怎么做。
我觉得 AI 最终也会面对类似的问题。
真正安全的超级智能,不应该只是因为外面有一圈护栏,所以暂时没有做坏事。更理想的状态,是能力和价值同步成长:越聪明,越理解边界;获得越大的权力,越知道什么时候不能使用这种权力。
所以如果过去十年的关键词是 Scaling,未来十年的另一个关键词,很可能是 Education。
我们已经证明了,人类有办法把机器培养得越来越聪明。
接下来真正困难的,是另一件事:
我们能不能在它越来越聪明的同时,也让它越来越值得信任。
也许 AGI 最后不是被“炼”出来的。
它是被一点一点培养出来的。
—— 关注凯同AI,把大健康AI落到真实经营里 ——
如果您正在关注大健康行业的数字化升级、AI应用落地或企业增长方式转型,欢迎持续关注凯同AI。✨
📌 我们将持续分享:
• 大健康AI应用趋势
• 内容增长与客户运营方法
• 门店服务与健康管理数字化实践
• 企业AI落地案例与实操经验
如果本文对您有所启发,欢迎点个「赞👍」和「在看❤️」
也欢迎转发↗️给身边正在关注大健康与AI应用的朋友,一起把有价值的内容传递出去。
💡 想进一步了解凯同AI相关方案?
👉 欢迎通过文末入口联系我们,获取更多资料与服务支持。