线上接口突然变慢,告警已经响了。
运维人员打开架构图,图上写着:
Nginx → WebLogic → Oracle
可真正开始排查才发现,中间早就新增了API网关,后面还接着两个微服务。
图里没有,日志里分散,最熟悉系统的人又不在。
于是大家只能翻配置、查告警、问同事,一点点把真实链路重新拼起来。修复问题,也许并不难。
难的是先弄清楚:这条请求到底经过了谁?一个服务异常,又会影响谁?
服务扩缩容、数据库迁移、中间件调整、实例替换,每天都可能发生,但传统架构图大多依赖人工维护,系统变了,图没变。
时间一长,新服务没有画进去,旧节点还留在图上,架构图逐渐失去作为排障依据的价值。
监控看到的是指标,日志记录的是事件,CMDB管理的是资产,但业务关系往往分散在不同系统。
发生故障后,运维人员还要自己判断服务之间的依赖关系,才能进一步分析影响范围。
很多业务关系藏在老员工经验、配置文件和历史文档里。
一旦人员变动,新同事很难快速掌握“谁依赖谁、哪里不能动”,排障只能从查资料开始。
真正需要解决的,不是重新画一张架构图,而是让系统能够自己发现业务关系,并随着环境变化持续更新。
1、以业务URL为入口,自动发现业务拓扑
传统方式是:画架构图 → 人工维护 → 系统变化 → 再补图。
北极星以业务URL为入口,结合访问链路、服务调用、配置及运行数据,逐层识别 API 网关、服务、数据库和相关基础设施,自动还原真实业务关系。

2、AI理解业务关系,让拓扑不只是“设备连线”
北极星结合监控、日志、配置、服务调用等多源运维数据,通过 AI 识别和关联业务关系,将服务层、数据层与基础设施层放到统一视图中。
想知道一个服务依赖谁、又被谁依赖,可以直接查看上下游关系。
让分散的数据真正形成一张可理解的业务关系图。

3、自动分析依赖关系与影响范围
当告警发生后,可以从异常节点出发,查看上下游服务、关联资源和相关告警,并进一步分析可能受到影响的业务范围。
故障发生后,不只是回答:
“哪里出了问题?”
还可以进一步回答:
“它影响了谁?”
让排障从“找信息”走向“看关系”。
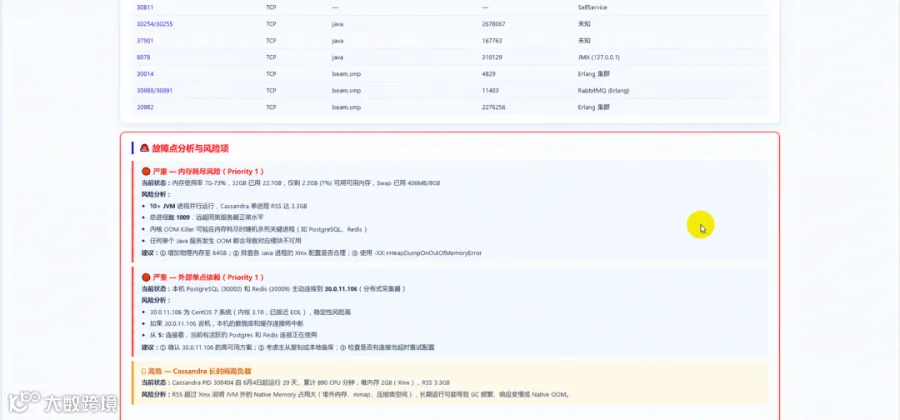
4、环境变化,拓扑也持续更新
新服务上线、实例替换、服务扩缩容、依赖关系调整后,北极星持续发现环境变化并同步更新业务拓扑,同时保留变更记录。
让拓扑不再是一张过期的“历史照片”,而是持续反映真实运行环境的动态视图。
传统架构图解决的是:
“系统大概长什么样?”
动态业务拓扑解决的是:
“现在真实运行的业务,到底是怎么连接的?”
以前排查故障,要翻日志、查配置、问同事,再一点点拼出业务链路。
现在,可以从业务URL或告警节点出发,沿着真实业务关系查看服务、数据和基础设施之间的关联,并进一步判断故障影响范围。

让系统自己发现关系,让拓扑跟着环境变化,让运维真正看清业务。
北极星业务拓扑自动发现,不只是多一张架构图,而是让这张图真正成为故障分析、影响判断和运维决策的依据。
让架构图不再停留在过去,而是始终接近真实运行中的业务