

从一条错误连线
看护理知识图谱怎么建
三元组 · Neo4j · 实体归一化 · 问答上下文
HIV 健康管理项目
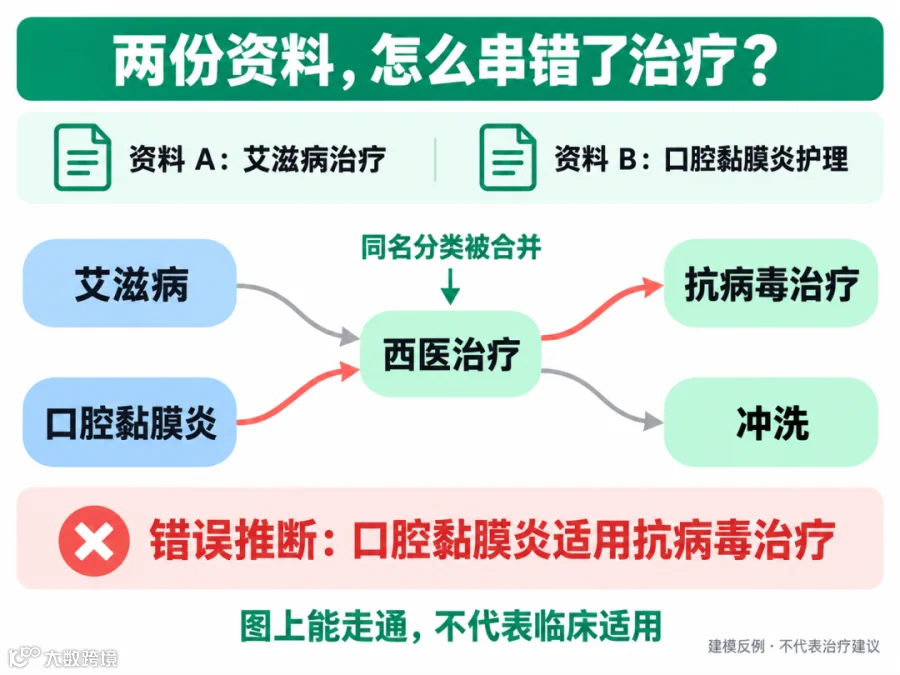
开篇反例:共享分类节点后,错误查询可能串入另一种疾病的治疗方法。
你把两份资料交给 AI:一份讲艾滋病治疗,一份讲口腔黏膜炎护理。抽取三元组、导入数据库,一张知识图谱就建好了。
接着,你查询口腔黏膜炎的干预方法,结果里竟然混进了“抗病毒治疗”。
这是一个建模反例:两份资料都用了“西医治疗”这个分类,程序把它们合成一个节点,又把分类下的方法当成两种疾病都适用的方法。这样的错误,还可能进入护理大模型的回答。
01
PART
知识图谱:把一句话拆成三部分
CONCEPT
知识图谱用实体表示对象,用关系说明联系,再用属性补充条件和来源。最常见的起点是三元组:“头实体、关系、尾实体”。
把实体画成点,把关系画成有方向的箭头,共享实体的三元组就连成一张图。你可以从某个症状出发,查相关护理方法,再查支持这条关系的资料。
上面的例子用于说明数据结构。抽取医学知识时,还要保留适用人群、限定条件和原文来源。原文写“在某种条件下可以考虑”,不能抽成无条件“推荐”。
Neo4j 是存放这张图的数据库
Neo4j 采用属性图模型:节点和关系都能带属性。节点可保存标准名称、别名;关系可保存适用条件、文献版本。查询语言 Cypher 用于表达“从哪个节点出发,沿什么关系找什么”。官方概念说明
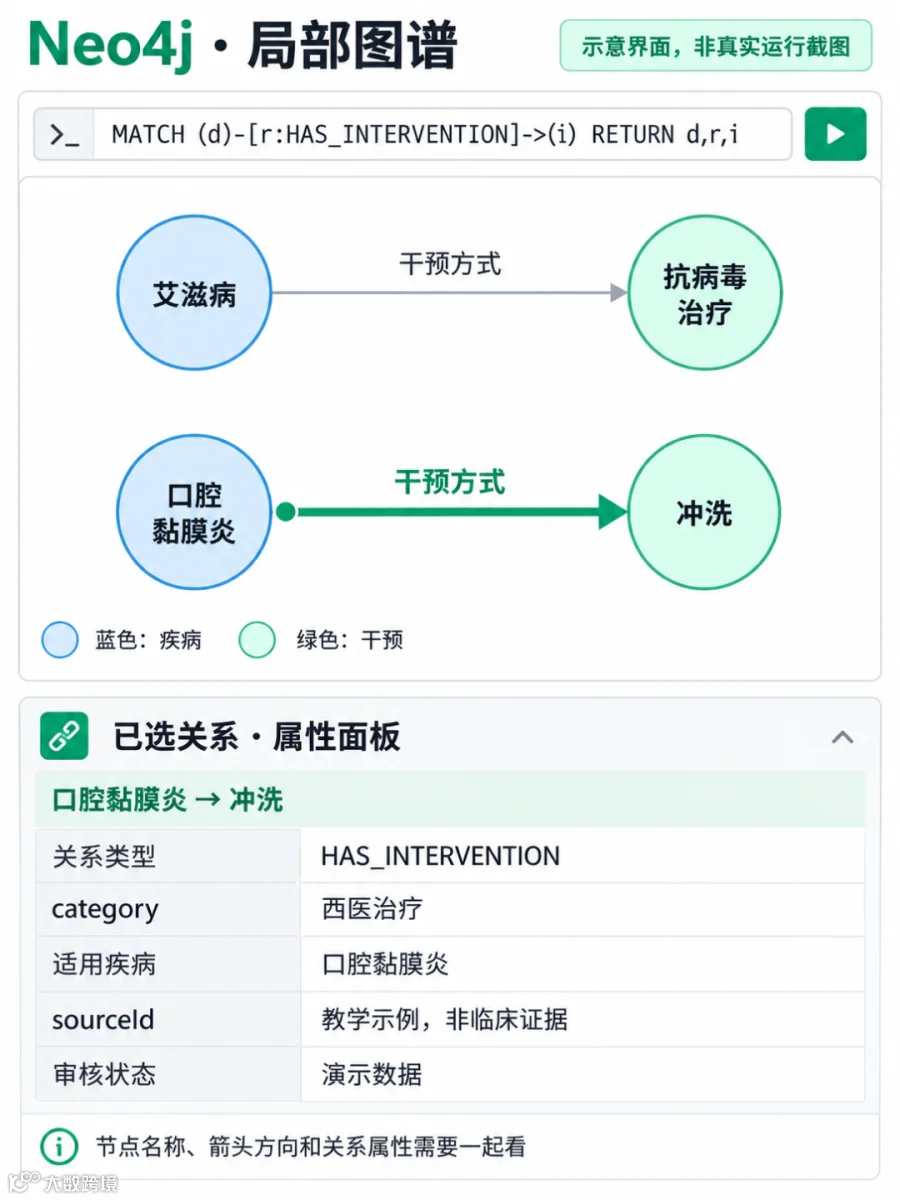
Neo4j 局部图谱示意:选中关系后查看属性。AI 生成,非真实运行截图。
数据库负责存储和查询,医学关系由建图人员审核。小程序主要通过微信云数据库中的节点、边集合提供图谱服务。
02
PART
从资料到入库,按这个顺序做
BUILD
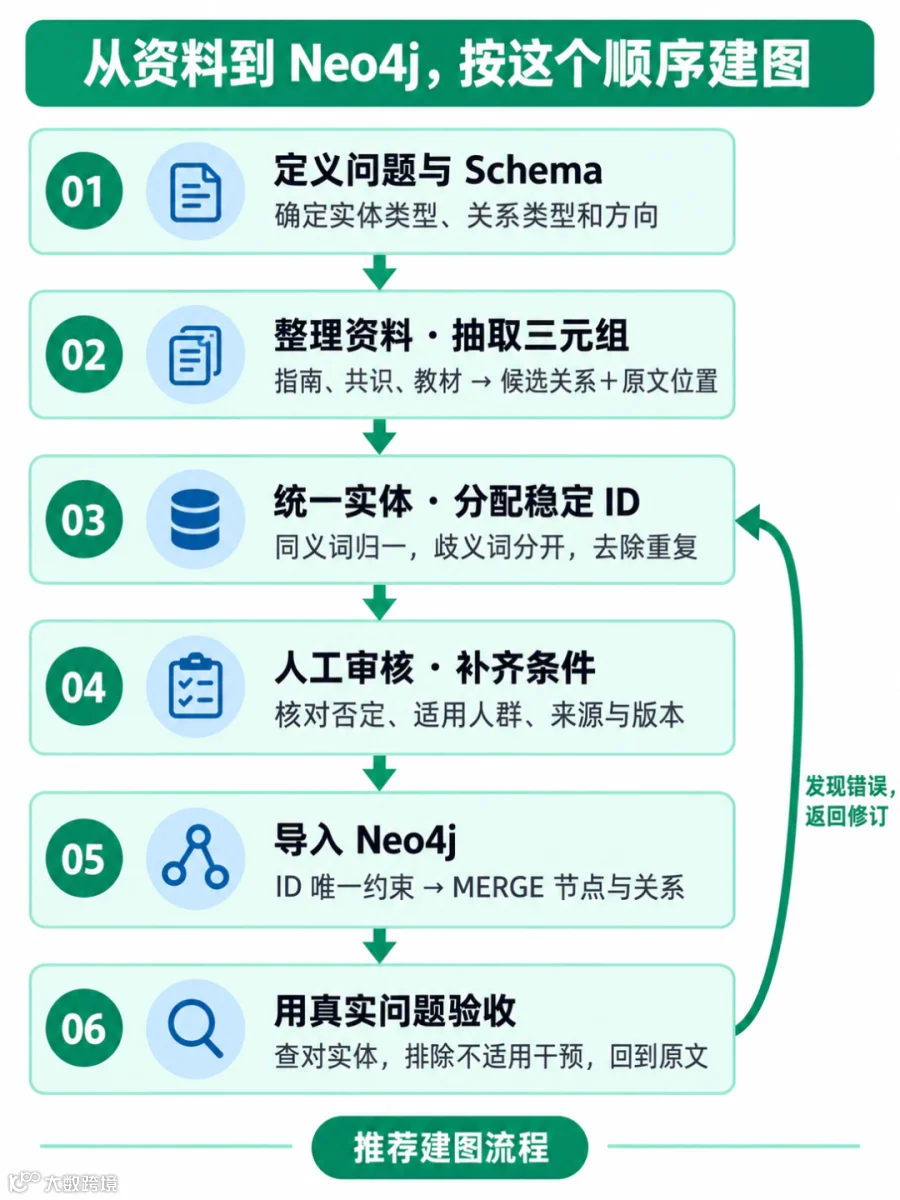
建图流程:定义结构、抽取、归一化、审核、入库,再用真实问题验收。
先定问题,再定结构
先列出希望回答的问题,例如“这个症状有哪些护理干预”“建议适用于谁”。据此定义实体类型和关系类型,形成 Schema,也就是建图规则表。推荐、包含、禁忌要分别表达。
抽取候选关系,保留出处
用规则、实体识别模型或大模型处理指南、共识、教材,输出三元组与对应原文。随后统一同义词、拆分歧义词、去重,由领域人员核对关系方向、否定和适用范围。
建立 ID,再导入数据库
节点名称可能变化,稳定 ID负责标识它是谁。先建立 ID 唯一性约束,再用 MERGE 匹配或创建节点、连接关系。项目脚本已经实现关系过滤、去重和类型整理,医学审核仍需补在流程中。MERGE 文档
入库后,下面的 Cypher 示例可查询一个疾病的干预关系及来源;ID 是教学示例。
验收时,拿一批能查回原文的问题测试:能否找到正确实体、排除不适用干预、给出支持结论的出处。不要只数节点和连线。
03
PART
第一个坑:同一概念,写成了不同名字
ENTITY LINKING
A 文件写“压疮”,B 文件写“褥疮”。按原词建节点,就可能把同一概念拆成两份:风险因素挂在一边,护理措施挂在另一边,查询时漏掉一半。

核对定义与范围后,把同义名称链接到同一个标准实体。
命名实体识别(NER)负责找出文中的实体并分类;实体链接与消歧负责判断它们对应哪个标准概念。识别出来之后,还要完成这一步归一化。
合并前要确认定义与使用范围。“疮褥”可先标为疑似错写,核对确实指“褥疮”再归一化,不能按字面相似度直接合并。
同样,HIV、HIV 感染和艾滋病应区分:前者指病毒,第二个指感染状态,艾滋病是 HIV 感染的晚期阶段。NIH 概念说明
实践中,先用术语表和别名词典匹配,再让模型处理缩写与歧义,拿不准的交给人工复核。
04
PART
第二个坑:“西医治疗”是实体,还是属性
MODELING
回到开头。如果两种疾病共用“西医治疗”节点,就会出现“口腔黏膜炎 → 西医治疗 → 抗病毒治疗”这条路径。
路径可达不能证明治疗适用。错误出在查询或生成阶段:程序把分类关系解释成了临床适用关系。
方法一:把分类写成关系属性
让疾病直接连接具体方法,把“西医治疗”作为这条关系的分类。

方法一:疾病连接具体干预,“西医治疗”保存在关系属性中。
查询、整理结果、交给模型时,都要保留适用疾病约束。属性写进数据库却不参与筛选,仍可能混入不适用的结果。
这里将 CART 规范为 cART,指联合抗逆转录病毒治疗,属于治疗方式,并未指明具体药物组合,因此使用“方案类型”。NIH 术语说明
方法二:保留分类节点,限定疾病范围
需要展示干预层级时,可以创建两个不同的分类节点。
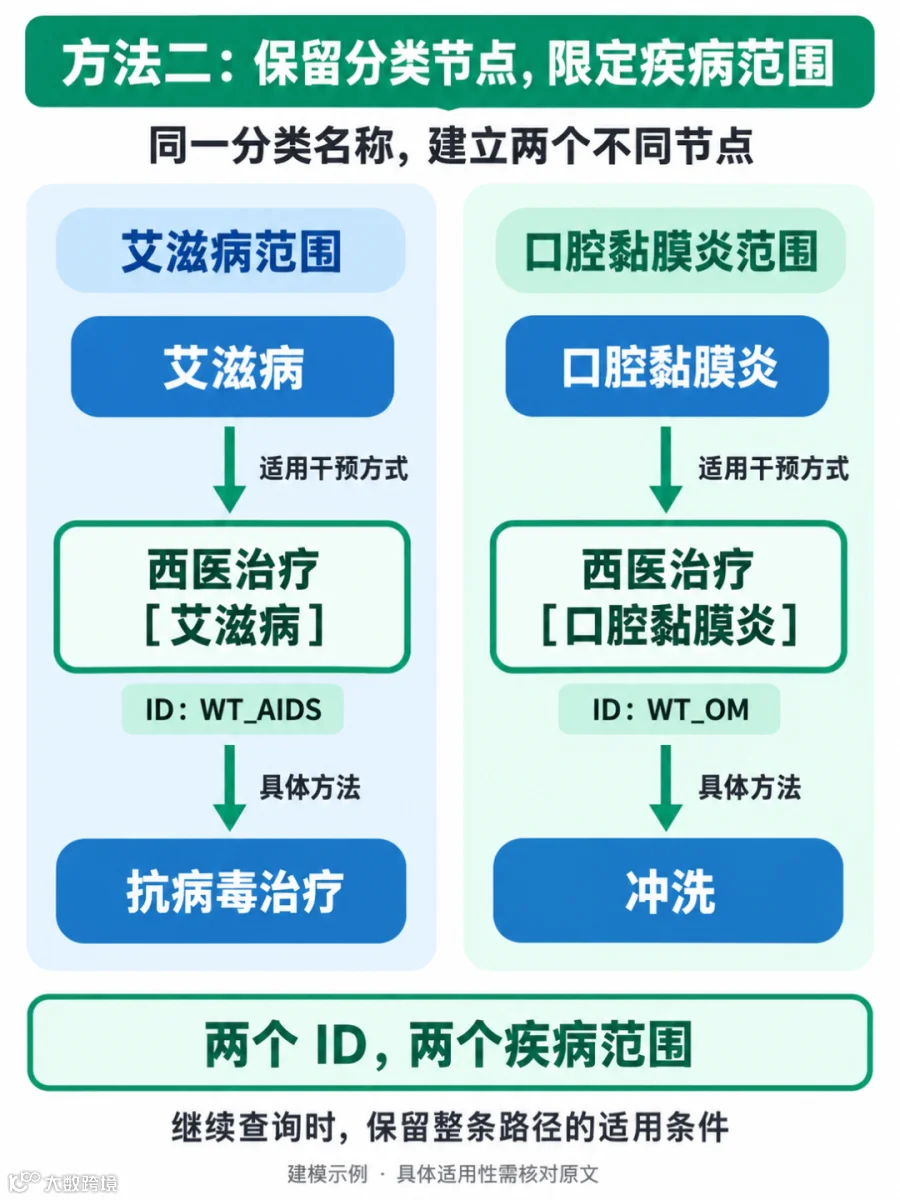
方法二:按疾病拆成两个分类节点,分别使用独立 ID。
两个节点使用不同 ID,保存疾病范围。继续往下查时,也要保留进入这条路径的疾病背景。以上均为建模示例,具体适用性须核对原文。
仅用于分类筛选的标签,通常适合做属性;需要独立检索、挂接资料或展开下级方法的对象,适合做节点。共享分类节点可以存在,但不能把它收录的方法全部当成某种疾病的干预。
05
PART
护理大模型需要怎样的上下文
CONTEXT
用户问“口腔黏膜炎有哪些护理方法”,只给模型几个节点名称还不够。作答前应检索关系、适用条件和原文证据,组成上下文;这一过程不要求重新训练模型。
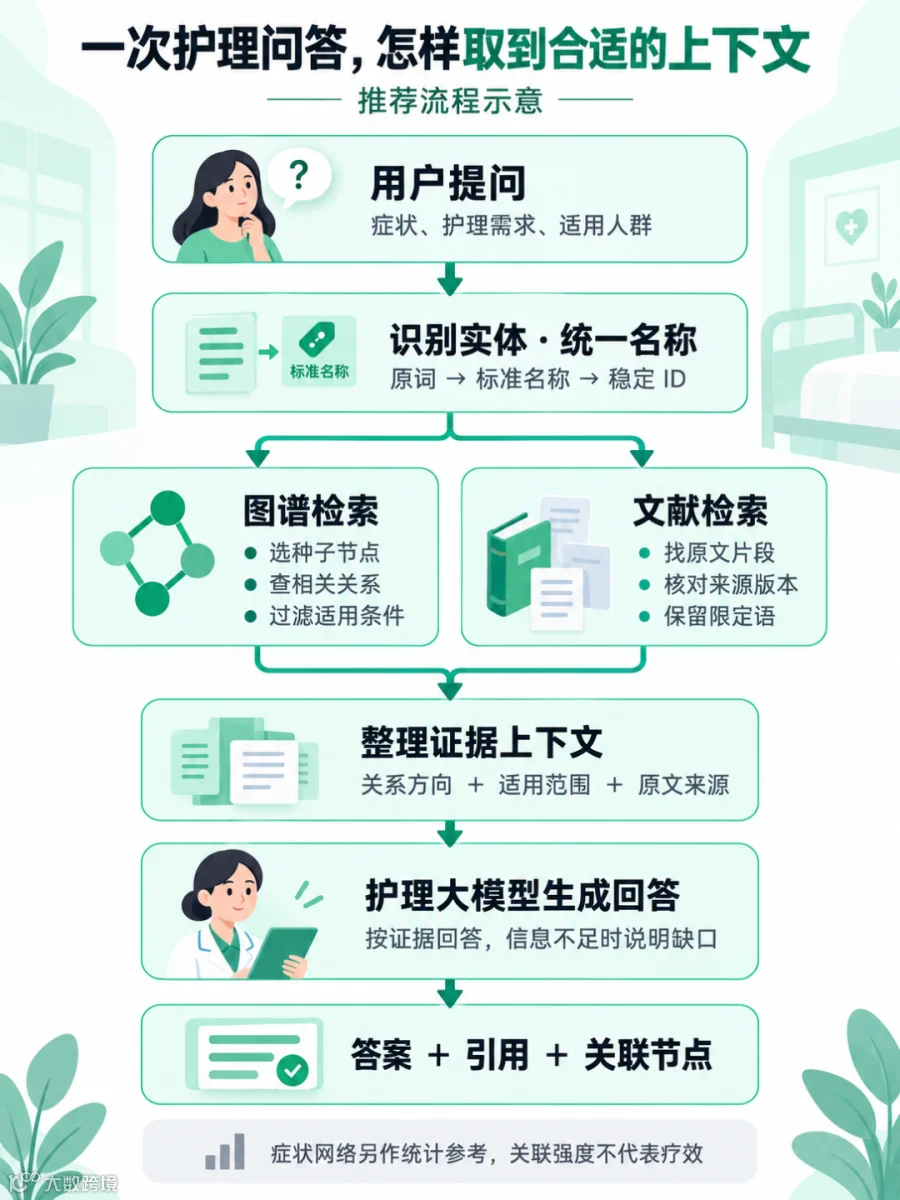
图谱与文献联合检索的推荐流程,包含仍需补齐的审核环节。
先从问题中识别实体、统一名称,找到种子节点。再按问题意图沿相关关系展开一到两跳,也就是走一条或两条边,并限制方向、关系类型和疾病范围。
随后取回对应原文,检查人群、版本与否定条件。交给模型的材料可以整理为:
本项目已接通“匹配节点 → 提取邻接关系 → 通过 GRAPH_CONTEXT 传给 Coze 工作流 → 结合知识库回答”的链路,用户原问题单独传入。
当前主要靠节点名称匹配,实体链接、条件过滤和关系溯源仍需完善。界面还会在回答后补匹配关联节点,因此展示节点未必都参与过生成前检索。默认等级、抽取置信度也不能当成临床证据等级。
06
PART
它和 RAG、症状网络有什么区别
COMPARISON
RAG 是检索增强生成,先找资料,再让模型回答。知识图谱可以提供其中的检索内容,两者能够结合。Neo4j RAG 文档
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
症状网络则从数据估计统计关联,本项目使用 GraphicalLasso 偏相关网络。知识图谱里的边表达“推荐干预”等语义,症状网络里的边表达症状变量之间的关联。
“疲乏”与“失眠”连得紧,不能据此认定前者导致后者,也不能证明先干预疲乏就能改善失眠。症状网络可作单独标记的统计参考,关联强度和中心性不能直接用于治疗排序。
07
PART
放进 HIV 健康管理小程序之后
APPLICATION
我们已将图谱查询、健康问答和日常管理做进HIV 健康管理小程序。用户可以查看返回的参考条目与片段,点击关联节点跳到图谱,继续查看关系。
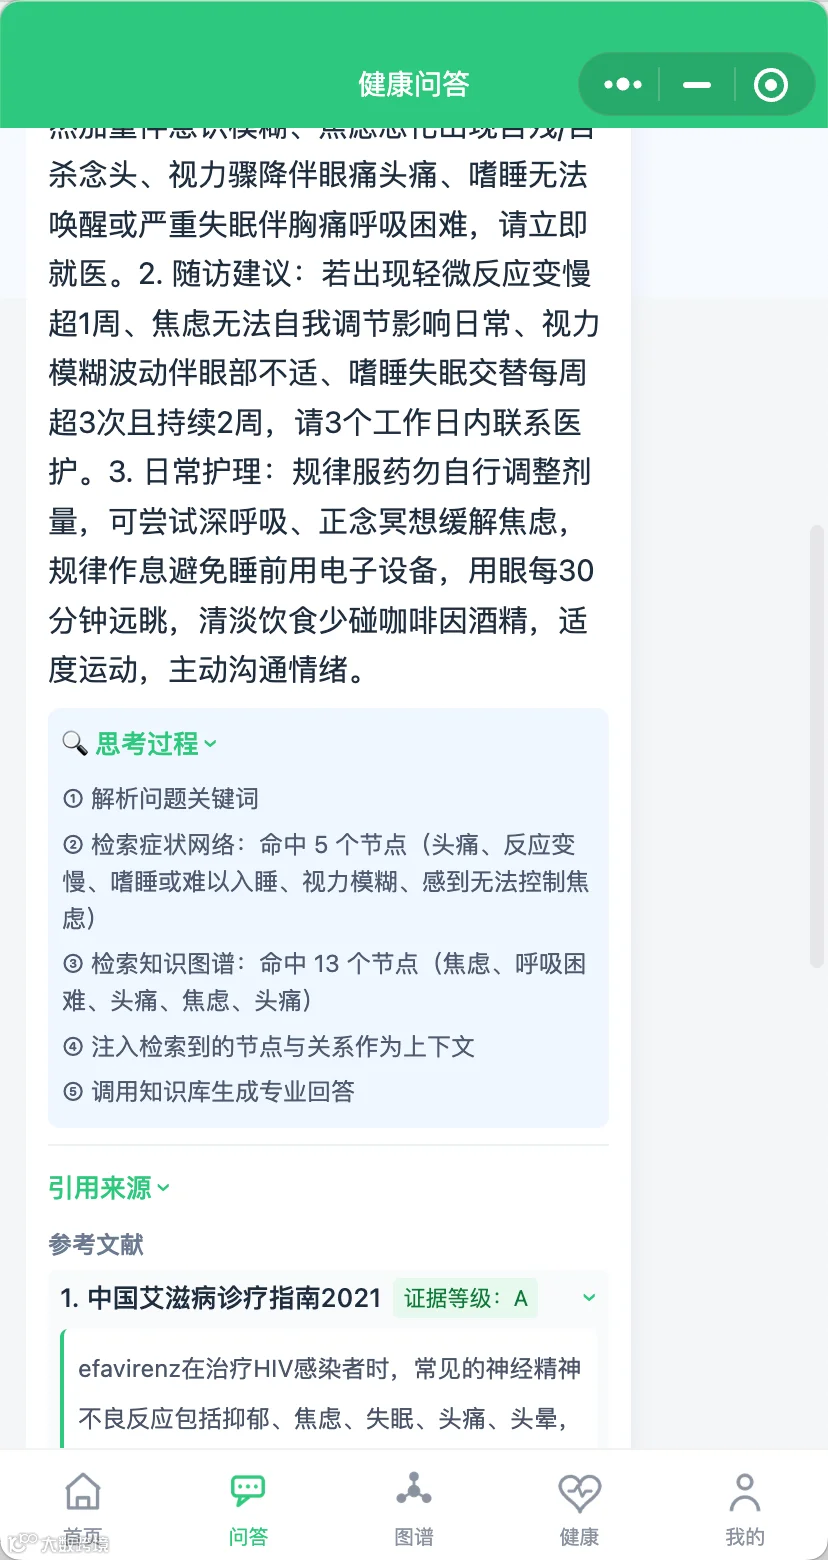
图谱页面提供知识图谱和症状网络入口;健康管理模块包含用药、复诊提醒及运动、饮食记录。问答用于科普与管理辅助,个人诊断、停换药和治疗方案仍需专业人员判断。
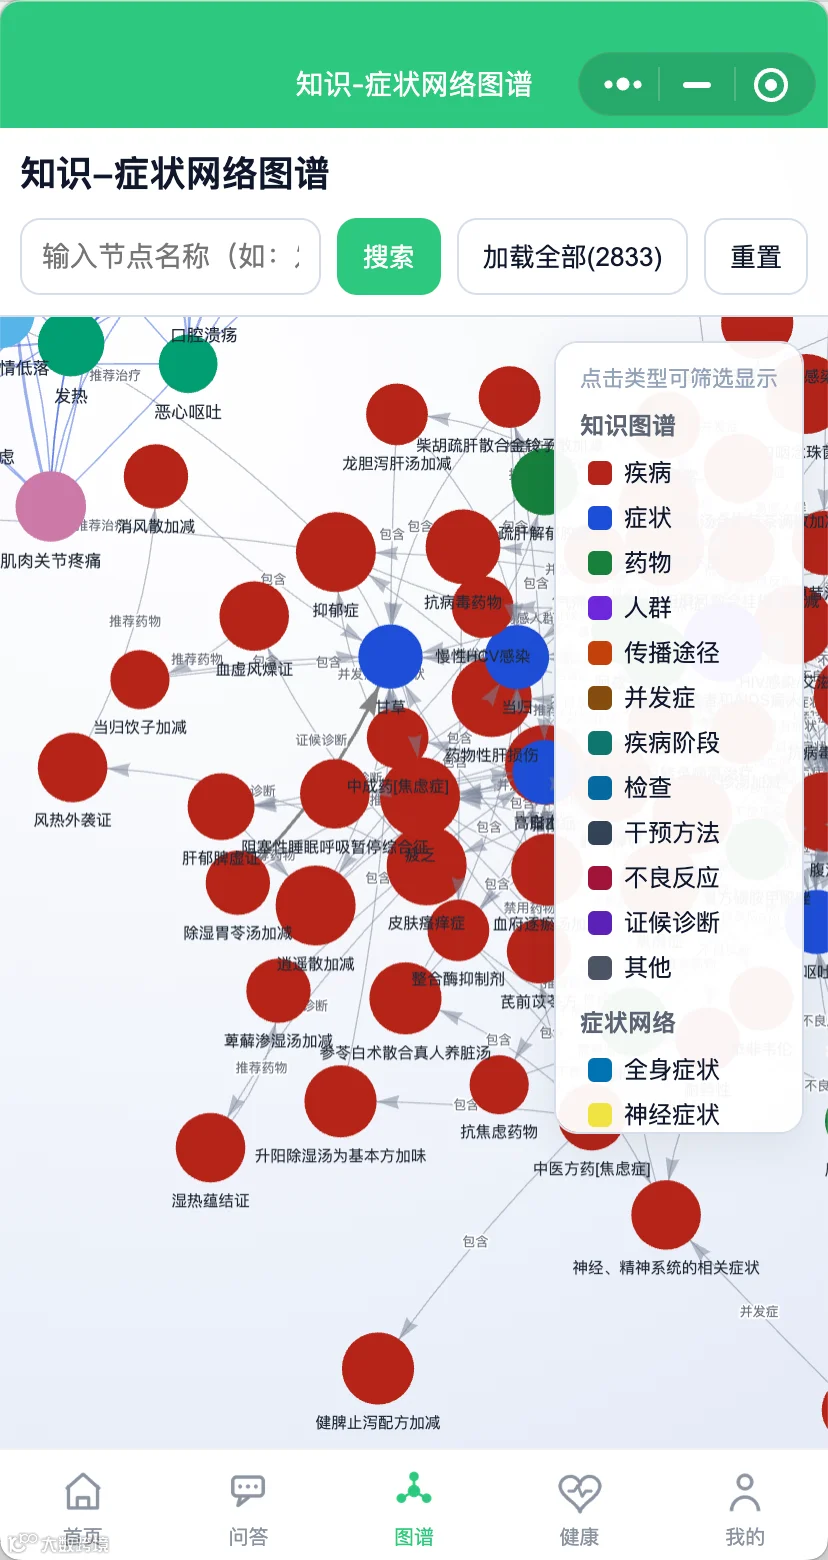
准备建自己的图谱时,先用两份资料试一遍。遇到答错的地方,沿着原文 → 三元组 → 查询结果 → 回答逐段回查,找到出错环节再修改。
关于作者
我是王佳清,聚焦医疗护理大模型应用,开展临床文本处理、知识增强、数据分析与智能决策支持研究;深度参与中国重点研发计划、国家自然科学基金及企业合作项目;联合多家三甲医院开展应用验证与迭代,推动大模型融入临床护理流程,促进智慧医疗与智慧护理成果转化。