

YIXIN·AI·FINTECH
聚焦汽车金融智能化新阶段
2026· 论文解读

导语
大模型答对一道逻辑题,究竟是靠背题库碰运气,还是像人类一样一步步严谨推演?
我们给大模型做了一次“大脑CT”,彻底揭开了大模型逻辑推理的黑盒秘密。
在人工智能(AI)领域,一直存在着一场激烈的争论。
正方认为,AI 已经进化出了真正的推理能力,能够像工程师和数学家一样严谨思考。
反方认为,AI 终究只是“会统计概率的鹦鹉”,它看似聪明的推理,不过是把网上读过的千亿文本按字面规律拼接出来,遇到没见过的规则分分钟露馅。
如果大模型始终是个黑盒,我们就永远无法确信,它在医疗诊断、金融信贷或自动驾驶等关键决策中给出的推理究竟是否靠谱。
为了回答这个根本性问题,北大和易鑫最新的机制可解释性(Mechanistic Interpretability)研究带来了突破性进展。

论文链接:https://arxiv.org/abs/2601.04260
研究人员给大模型做了一次精密的“因果手术”,清晰还原了大模型在解决命题逻辑问题时,内部究竟发生了什么。
最终的结论是:大语言模型的脑海深处内化了一套层级分明、精密运转的“思维流水线”!
怎么证明 AI 没在死记硬背?
一场严谨的“因果手术”
要看清 AI 到底懂不懂逻辑,首先要排除“背题库”的可能。
研究团队设计了一个极其干净的形式逻辑测试基准 PropLogic-MI。它不包含任何生活常识的干扰,全是由纯符号构建的逻辑命题(涵盖布尔代数中的德·摩根定律、分配律、排中律等 11 类核心规则)。
题目示例:
已知:A 为真(True),B 为假(False)
规则:非 (A 或 B) 的结果是什么?
模型回答:(直接输出 True 或 False)

为了避免大模型通过“一问一答的显式思维链(CoT)”偷看答案,研究人员要求模型在读完题目的最后一个 token 后,立刻预测结果。
随后,研究人员使用了类似脑科学的因果探测技术——激活修补(Activation Patching)与均值消融(Mean Ablation):
如果把输入里的“A 是真”悄悄调换成“A 是假”,模型的神经元会发生什么扰动?
如果精准“麻醉”模型的某几层网络或某个特定的神经接头(注意力头),模型的逻辑推理会不会瞬间失灵?
通过对 Qwen3、Llama-3.1、Mistral 等主流开源大模型上万次样本的因果干预,大模型内部的逻辑流水线终于浮出水面。
拆解黑盒:
AI 处理逻辑题的“四重隐形机关”
研究发现,面对复杂的逻辑问题,大模型并非一团乱麻地运算,而是像一家配合默契的工厂,自动启动了四大互锁机制。
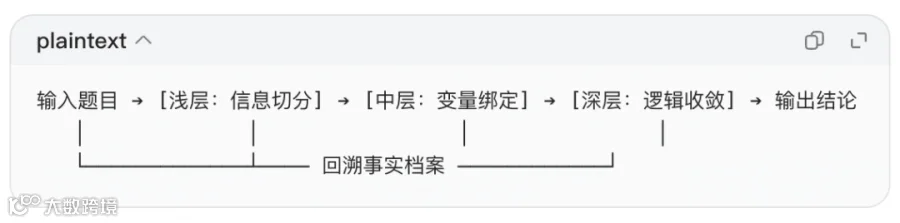
机制1:分阶段计算(Staged Computation)
大模型的层级就像一家公司的组织架构,分工极其明确:
浅层(集中处理事实):只负责抓取和理解已知的前提条件,比如提取 A、B 分别代表什么值。
中层(集中处理逻辑表达式):开始处理复杂的逻辑表达式,将符号代入规则,进行代数运算。
深层(集中处理查询):在接近输出结果的最后几层,全面整合中间推导,直接输出答案。
值得一提的是,这个顺序是模型内部自发形成的。哪怕研究人员故意打乱出题顺序(先写复杂的表达式,最后再告诉你事实前提),模型内部依然维持这套“先事实、再表达式、最后查询”的计算次序。
这说明,这套步骤是大模型内生的算法结构,不是被动顺应文字顺序的本能反应!
机制2:信息汇聚(Information Transmission)
如果句子里有那么多词,AI 会不会信息过载?
实验表明,逻辑信息在模型内部的传递极为高效,具有高度的“空间稀疏性”。
模型内部的大量普通词元(如“and”、“or”或变量字母)并不会一直带着巨大的因果权重跑,而是会在每个逻辑块的边界标记(如子句结尾的逗号、括号、末尾句号)处,像高铁枢纽一样把分散的信息打包打包,一站式传递到下一阶段。
机制3:事实回溯(Fact Retrospection)
当逻辑关系变复杂(例如“双跳推理”:先从 A 推导出中间变量 M,再拿 M 和 G 推导终极结论),AI 会不会把最初的线索给忘了?
研究捕捉到了两个非常生动的现象:
中层对齐:运算到中层时,表达式里的变量会反向跨越空间,去浅层事实库里核对真值,并把“True/False”绑定到这个字母上。
高负载回头看:当推理难度加大、算力接近极限时,模型甚至会在临近输出决策的最后几层,反复开辟注意力通道“回头看”最初的事实条件,防止自己推理错误。
机制4:专用注意力头(Specialized Attention Heads)
上述这套宏观策略,在微观层面由三群各司其职的注意力头完成的:
分割头(Splitting Heads):驻扎在浅层,像标点探测器,负责把整道题切分成“前提”和“表达式”。
传递头(Transmission Heads):驻扎在中层,负责在子句内部聚合信息,定向送到句子结尾的枢纽位置。
事实检索头(Fact-Retrieval Heads):在中深层活跃,像精准的查档员,负责从事实库里提取真值,填回表达式。
实验证明,如果人为消融掉这些“事实检索头”,模型的逻辑推理能力会出现显著下滑,而随机删掉其他头,影响很小。
模型对比:
为什么小模型做逻辑题容易翻车?
这项研究还有一个新发现——模型容量裕度假说(Capacity Headroom Hypothesis)。
研究横向比对了 Qwen3、Llama-3.1 与 Mistral 三大家族:

Qwen3(容量充裕):功能头分工严整清晰,像一家部门边界明确的成熟公司。遇到两步推导也能在前向传播中轻松压缩信息,容错率极高。
Llama 与 Mistral(在此类受控多跳任务上面临容量极限):注意力头的分工明显模糊弥散,不同模块混在一起。到了决策阶段,因为前期没能有效压缩推导信息,不得不反复回溯最初的前提,稍微一点文本扰动,整个逻辑链条就崩盘了。
这生动地解释了为什么参数量不足、或未针对逻辑密集训练的模型,在复杂多步推理时极易产生“逻辑幻觉”——它们本身具备逻辑网络,但当任务复杂度触及承载极限时,内部的信息压缩与路由机制就会发生退化。
这项研究,
对 AI 行业意味着什么?
从“能用”到“可信”,大模型正迎来产业落地最关键的深水区,这篇论文为整个行业指明了方向。
1. 撕掉大模型“不可信黑盒”的标签
过去我们不信任大模型,不敢在严谨行业深度放权。这项研究证明:大模型内部发展出了高度结构化、算法化的逻辑架构。随着机制可解释性工具成熟,我们有望像排查软件 Bug 一样,直接定位模型内部的“逻辑故障点”。
2. 告别暴力堆算力,实现精准剪枝与加速
既然我们已经精准定位了哪些注意力头负责切分、哪些负责提取真值、哪些头对逻辑完全无关,未来在做模型轻量化蒸馏与剪枝时,就能定向剔除无用冗余参数,保留甚至强化核心推理回路,大幅降低端侧模型的推理延迟与硬件成本。
3. 催生真正的神经符号混合系统
纯符号逻辑严谨但缺乏泛化能力,深度神经网络灵动但缺乏逻辑刚性约束。这项研究架起了两者之间的桥梁——当我们摸清了神经网络是如何用连续向量模拟离散布尔代数运算的规则,未来就能设计出具备数学级安全可验证性的全新 AI 架构。
黑盒正在被一点点凿开,一个更透明、更可控、真正具备严谨逻辑思维的 AI 时代,正在加速到来。
END

易鑫AI
视频号丨抖音丨B站
小红书丨知乎丨微博

点赞
收藏
分享