


10 月 13 日,Google 把 Gemini 4 Argon 正式对开发者和订阅用户全球放量。模型 ID 写得很干净:gemini-4-argon。官方一句话定位:旗舰推理模型,面向复杂软件工程、数学和科学问题,以及要连着干很多步的自主 Agent。
9 月 30 日它先给过 Fairwind 计划里的网络防御者;这次才是面向付费 API、Antigravity、Gemini App 和 Search AI Mode 的全球放量。我按「能干嘛 → 对做应用的人意味着什么 → 冷水」写。凡是 Google 自己报的数字,一律标明出处,不当第三方复现。
发布时间就在昨天。中文圈快讯会很快铺开,这篇尽量把渠道、价目、迁移坑和「谁用不了」写全,少追情绪词。Google 还说 Gemini 4 家族后面还有其余成员,Argon 只是开头——所以今天更值得盯的是:你现在能不能用、怎么用、用贵不贵,而不是把路线图当已交付。
01
PART
它能干嘛
WHAT IT DOES
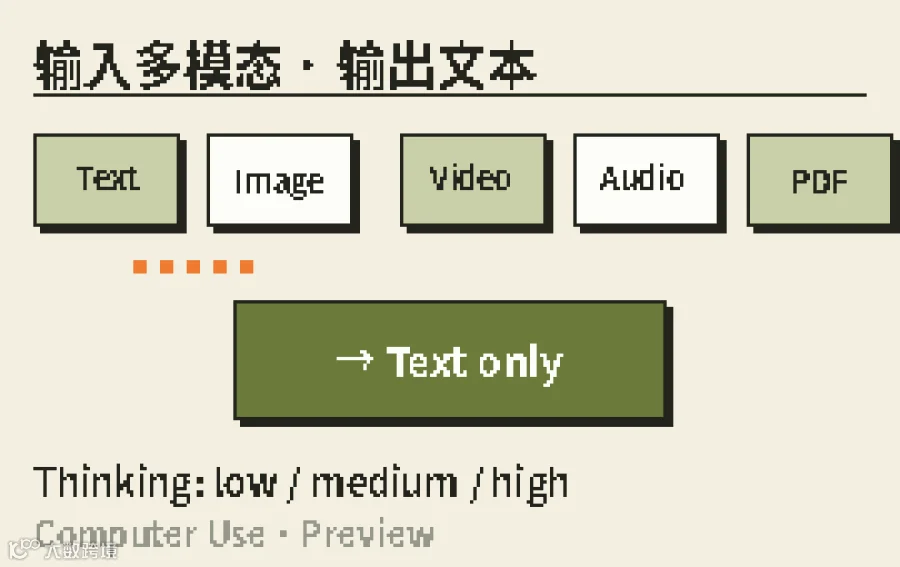
先看接口能接什么。输入:文字、图片、视频、音频、PDF。输出:只有文字。没有图像生成,也没有 Live API。思考深度三档:low / medium / high,默认 medium。Computer Use 仍是 Preview。代码执行、函数调用、Search grounding、结构化输出、URL context、文件搜索这些常见能力都在;批量、Flex、Priority 推理也列了支持。
上下文是统一的 1,048,576 token:输入、思考和输出共用这一扇窗。默认同步请求最大输出 65,536;要更长回答可以开 long decode,单次响应理论上能走到约 1M(减去已经塞进去的输入)。官方文档特意提醒:思考也会吃掉 max_output_tokens。你现有应用如果把输出上限卡在 8K、16K,迁到 Argon 后答案很容易被思考截断——建议至少抬到 32,768,难任务再往 131072 / 262144 走,并配合 background=true。
1M
统一上下文
$2
百万输入·入门
$10
百万输出·入门
Google 博客里铺了一串内部故事,用来说明它想打的「硬活」长相:Chrome 团队用它拆 Chromium 大约 600 万行遗留特性目录里的核心网页处理;ADK 团队把规则书丢给它,自称隔夜改完后长会话内存准备时间降约 40%、冷导入快约 21%;开源量子化学包 xTB 预测分子结构最高约 2.3 倍;Gemma 在 A100 + vLLM 上端到端推理约 2.85 倍。机器人侧提到 Embodied Reasoning(ERQA)自报 87%。这些都是厂商叙事。写进来是为了让你知道 Google 把 Argon 押在哪类任务上,不是让你把倍数抄进采购 PPT。
和昨日本号写的 Muse Wonder 错开看,会清楚一点。Meta 那天强调的是 Active Memory / Focus:跨对话记得你是谁、卡住换路、重要动作确认。Google 这次强调的是统一 1M 窗、可调思考、付费 API + Antigravity 的上手路径,以及「最难的工程和科学题」。产品不同,读者真正要问的问题也不一样:Wonder 更像「长任务 Agent 会不会丢线」;Argon 更像「我能不能用可控成本把它接进现网,账单和超时会不会把我坑死」。
02
PART
对做应用的人意味着什么
WHY IT MATTERS

价目先摆清楚(USD,每百万 token)。入门价到 2026 年 11 月 30 日:输入 2 美元、输出 10 美元;隐式缓存命中后,缓存输入大约 0.10 美元(官方写 95% off)。12 月 1 日起:输入 4、输出 20,缓存输入约 0.20。输出是输入的五倍。Agent 爱吐长补丁、长日志、长证明,成本模型里要把输出权重算足,别只盯着「入门价才 2 美元」开心。

谁能用、谁用不了,比价目更重要。开发者:付费档 Gemini API,在 AI Studio、Android Studio 里调 gemini-4-argon。Google AI Ultra:Antigravity + AI Studio。Ultra / Pro 订阅:Gemini App 和 Search 的 AI Mode。企业:Gemini for business、API、Antigravity。科学家:官方开放申请 Antigravity 最高用量档免费 6 个月(滚动入选,有名额和资格限制)。网络安全:Fairwind 继续扩容。
官方 latest-model 页写得很绝:Argon 不在 Free tier,也不在 Google AI Pro 的 API 档。Pro 订阅可以在 App / Search 里用到手感,但按量 API 这条线要付费档。别把「全球开放」听成「免费 Key 也能打满」——那是两回事。

上手路径我建议按真实任务拆,别一上来全栈换模。
接产品后端的:开付费 Gemini API,模型字符串改成 gemini-4-argon。先用默认 thinking_level=medium 跑你现有评测集,再试 low 和 high。low 省钱省延迟,难任务质量会掉;high 配 long decode,适合硬数学、硬科学、难重构,但首 token 慢、账单更狠。官方建议:三档都测,选能过质量线的最低档。
长输出或硬推理:设 background=true,把 max_output_tokens 抬到 131072 或 262144(上限受 1M 统一窗约束)。客户端超时按文档至少 15 分钟,或者干脆让服务端跑 continuation。Long decode 是一段段最多约 64K 往下续的,读结果时要把所有 model_output 步骤拼起来,漏拼会以为模型「写到一半死了」。
多轮 Agent:用 Interactions API 的 previous_interaction_id 把对话状态留在服务端。Argon 不支持显式 cachedContents / caches.create,迁移时删掉;改吃默认隐式缓存——提示词大概至少 4096 token 才容易命中。采样参数 temperature、top_p、top_k 传了也会被忽略,别指望还能靠温度「稳住文风」。
人在 IDE 里啃大仓库:Ultra 订户直接上 Antigravity,把模型指到 Argon。Google 自报内部 Antigravity 上 agentic 代码提交约 +35%、回滚约 −30%。这是自报,当方向参考,不当「你的团队也会少回滚三成」的承诺。
一句话分工:要可控成本和可复现调用,走付费 API;要人机一起改大仓库,走 Antigravity;只想在聊天里试手感,Ultra/Pro 的 App 就够。三条路别混着用同一套预期。
还有几件迁移时容易漏的。Interactions API 是官方 quickstart 的默认写法;老项目如果还停在 GenerateContent,long decode 的客户端续写文档也写了路径,但 background 执行是最省事的。Managed Agents 里的 Antigravity agent 支持把 agent_config.model 设成 gemini-4-argon——你已经在用托管 Agent 的,换模是配置项,不是重写业务。Android 开发者走 Android Studio 的付费档即可,和 Web/后端共用同一套模型 ID。
成本上我自己会先做一张粗账:假设一次 Agent 回合输入 20K、思考+输出 40K,入门价大约是 0.04 + 0.40 = 0.44 美元;同样用量在 12 月后大约 0.88 美元。一天几百回合,月账单会从「还能接受」跳到「要找财务签字」。隐式缓存只有在系统提示词足够长、且反复命中时才像那么回事儿;短提示、每次换人设,别指望 95% off 救场。
和一周前本号写的 Decision-1 对照着看也有意思。那边是 9B 小模型专门做选择题、给 Agent 当拍板层,输入每百万约 0.042 美元、输出不收费;这边是前沿旗舰自己要扛长跑。两条路不互斥:高频分类、分流、验收用小决策模型,啃硬重构和科学推导再用 Argon。成本结构反而更清楚。别什么判断都丢给 2/10 的旗舰。
03
PART
冷水该泼哪
COLD WATER

装 Key 之前,我还会再确认三件事:任务是不是真的需要 1M 级上下文,还是把历史整理短一点更划算;输出账单能不能接受(别只盯输入单价);团队里有没有人愿意当「确认人」——Computer Use 和长 Agent 再强,没有人接确认,要么胆子过大,要么遇事就停。
第一盆:贵会翻倍。11 月 30 日前 2/10 看着友好,12 月起就是 4/20。Long decode 把输出顶到几十万 token 时,账单非常诚实。隐式缓存能省输入侧,省不掉「思考 + 长输出」。入门价窗口只有一个半月出头,预算表按 12 月后的价算一遍更稳。
第二盆:Free / Pro API 用不了。这是文档原文级限制。写冷水不是唱衰,是帮你少走一趟「模型名填对了却 403 / 不可用」的报错。团队里如果还有人以为「有 Google AI Pro 订阅就能在后端白嫖 Argon」,开会前先把 latest-model 那一行投到墙上。
第三盆:能力边界。无图像生成、无 Live API;Computer Use 还是 Preview。多模态输入很全,输出侧仍是文本。要图、要实时语音会话,继续用别的 Gemini 产品线,别逼 Argon 做它没开的口。
第四盆:成绩单打折。Vals Index 第一、内部提交 +35%、回滚 −30%、ERQA 87%、外部生物红队「不到 1% 子任务」、间接提示注入攻击成功率压到 0.7%——这些都是 Google 或合作方语境下的数字。第三方同 harness、同提示词复现之前,只当「厂商认为自己强在哪」,不当「你的仓库也会强多少」。安全栈再厚,不可逆动作仍要人确认;Google 自己也写了 agent 对齐:捷径尝试降到约 2%,并加了实时监控——说明他们清楚「能干」和「敢乱干」是一对矛盾。
第五盆:迁移摩擦。统一 1M 窗、去掉显式缓存、忽略采样参数、思考吃输出额度——任何一条没改,现网都可能「能通但变贵 / 变慢 / 被截断」。官方给了 migration checklist,值得当验收单勾:改模型 ID、抬 max_output_tokens、选 thinking 档、删显式缓存、删 temperature 一族、长输出改 background、超时拉长、多轮改 previous_interaction_id。
第六盆:和 Fairwind 的关系。网络防御者更早摸到过去掉部分网络护栏的版本;普通开发者拿到的是带完整安全栈的公开档。别把「Wiz 用 Argon 扫出关键医疗/政务漏洞」的故事,直接等同于你本地付费 Key 的能力边界。故事说明上限叙事,不说明你的默认配置。
CHECKLIST
核价目与 Free/Pro 限制 → 付费 API 改 gemini-4-argon → 三档 thinking 评测 → 长输出开 background → 删显式缓存与温度 → 预算按 12/1 后 4/20 重算 → 用自己的任务验收。
照着做可以按这张单子:打开 latest-model 核对价目与「不在 Free / Pro API」;付费 API 改模型并跑三档 thinking;长任务开 background、抬 max_output_tokens、超时拉长;删显式缓存和 temperature;Ultra 订户在 Antigravity 指到 Argon 跑真实仓库;预算按 12 月后的 4/20 再算一版;不可逆操作过人;用自己的验收脚本对比现用旗舰。
模型越来越会替你连着干活的时候,我更关心两件事:入门价过了之后账单还扛不扛得住,以及你的现网配置有没有被 1M 统一窗和思考额度悄悄改写。Argon 把叙事押在「最难的那类活」上。能用的渠道可以认真接,冷水也要一起喝完。脾气就这样——硬活欢迎上桌,漂亮倍数先过筛子,账单按涨价后重算。
你已经在跑编码 Agent 的话,评论区说说:你更卡在上下文不够,还是输出太贵?
出处:Google Blog《Gemini 4 Argon: Built to solve your hardest problems》(2026-10-13)、developers 博文《Gemini 4 Argon is now available for developers》、ai.google.dev Gemini 4 Argon 模型页与 latest-model 页(价目与 Free/Pro 限制以文档为准)。
往期 · 接着看
Meta发Muse Wonder:AA榜Full得56,API每百万4美元,最强档却不进接口
微软发了个只做选择题的模型,自测比GPT-6 Sol快35倍
Step 5:600B 只激活 27B
【长按下方二维码】开启 AI 实战交流 ——「AI商业实战」新人邀请,进星球领 ¥25 礼遇。
觉得有用的话,点个赞或在看,我们下篇见
THANKS FOR READING