

今天凌晨,Meta 推出了新旗舰 Muse Wonder 系列,包含 Wonder 和更强的 Wonder Full。
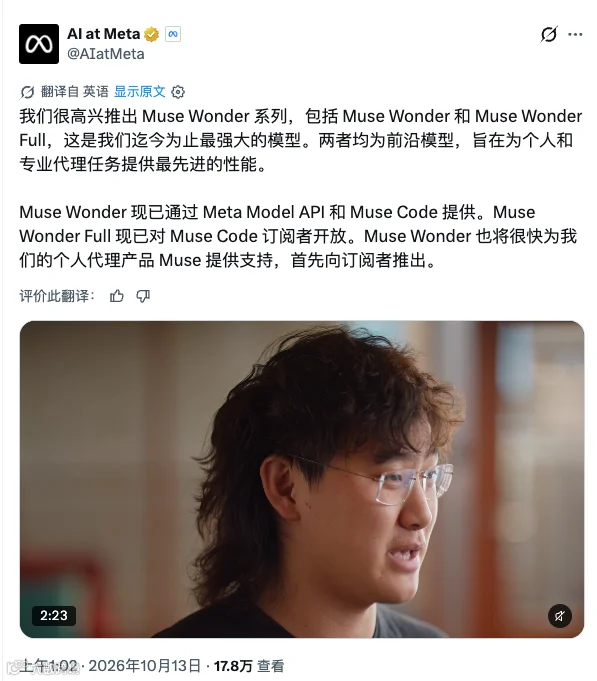
第三方评测机构 Artificial Analysis 给 Wonder Full 打出了 56 分。Claude Opus 5.5 是 58 分,差距缩到了两分;Wonder 则拿到 52 分。这里用的是 AA 智能指数 v4.3,两款新模型均为 max 推理设置。
Meta 的新旗舰,已经挤进了前沿模型的竞争圈。

Meta 发布页汇总的 Artificial Analysis 智能指数
再看自家的上一代:Muse Spark 1.3 在同一份 AA 评测里是 48 分。从 48 到 56,两代发布只隔了约六周。
这一次,Meta 给新模型安排的目标也很明确:个人超级智能。既要能处理专业工作,也要记住用户的需求,把一件事持续做下去。
14 个月,从重建技术栈到追上前沿
Meta 在发布博客里回顾说,14 个月前,团队开始从底层重建 AI 研发体系。基础设施、预训练和强化学习都沿着新的路线推进,Muse Spark 是第一步,Wonder 则用上了规模更大、能力更强的基础模型。
这轮训练在 Meta 的千兆瓦级 Prometheus 数据中心完成。此前关于基础设施的投入,如今有了一份能在第三方榜单上看见的成绩单。
在 Meta 构建的 Personal Superintelligence Index 中,Wonder Full 得到 59.1%,高于同表中的 Opus 5.5(55.2%)和 GPT-6 Astra(54.5%)。这个内部综合指数包含个人任务、专业工作、浏览研究与持续执行等七项评测。
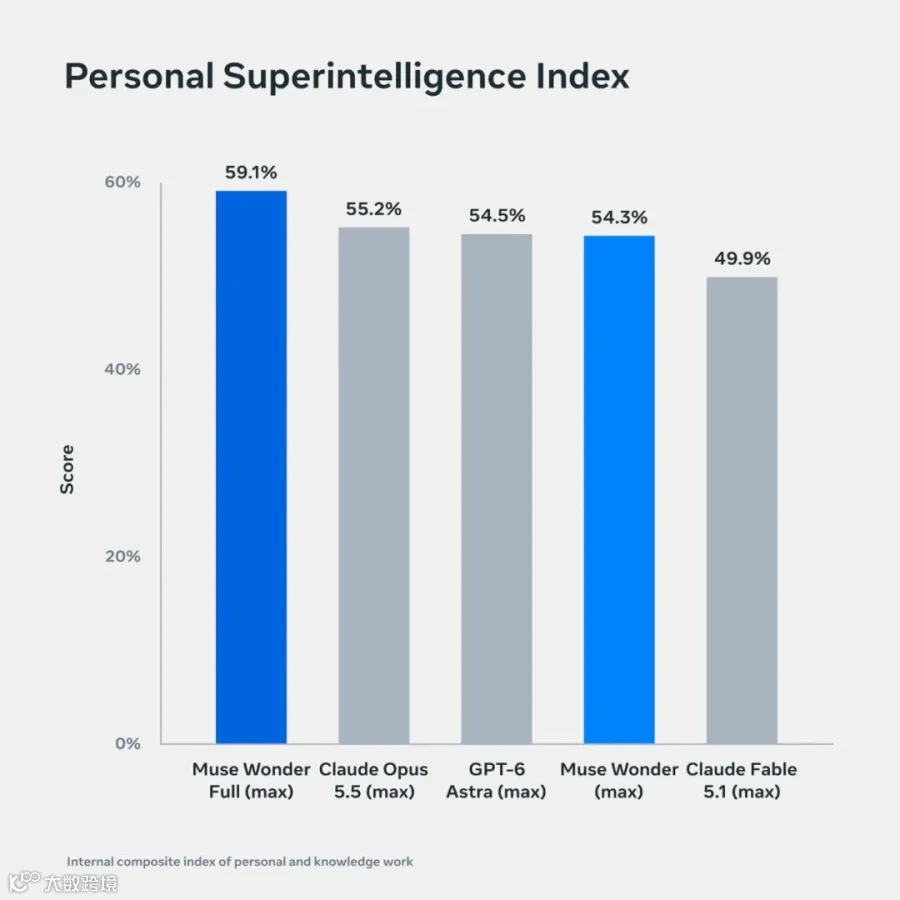
个人与知识工作综合评测
这些任务要求 Agent 交出具体成果:阅读材料、使用工具、完成工作流,把多个步骤接起来。比如法律评测要求从案件文档中制作法律工作成果,企业自动化评测则检查应用最终有没有达到要求的状态。
在 Meta 汇总的 Harvey LAB-AA 结果里,Full 得到 13.1%,Opus 为 4.2%。这项法律任务评测要求交付成果通过全部标准,并通过幻觉检查,过关门槛很高。
SWE-Marathon 让 Agent 完成较大的软件项目,最后运行项目测试验收。Wonder Full 得到 57.5%,Opus 5.5 为 46.3%,GPT-6 Astra 为 42.5%。Full 比 Opus 高了 11.2 个百分点。

SWE-Marathon 长程软件工程结果
这组结果来自 Abundant AI 对不同编程产品的评测,Full 使用 xhigh;它比较的是整套 Agent 在长项目中的交付表现。另一项长程编码评测 DeepSWE 1.1,Full 为 79.0%,同表的 Opus 为 74.2%。
Artificial Analysis 的编程 Agent 指数也给了一个很容易理解的位置:Muse Code 搭配 Wonder Full 得到 68 分,与 Claude Code 搭配 Sonnet 5.5 同分。上一代 Muse Code 搭配 Spark 1.3 是 54 分,均为 max effort。
Meta 在长任务上确实进步了。终端编程和从零重建程序等评测里,Opus 仍有优势;这轮升级的突出之处,是把持续执行和专业工作做得更强。
个人 Agent,要记得住,也要做得下去
Meta 给这两件事起了名字:Active Memory 和 Active Focus。
Active Memory 是主动记忆。用户以前说过的偏好、目标、项目背景,需要在新的对话里接着用;到了相关任务,Agent 再主动找回需要的细节。
它强调的也包括更新。用户中途改了要求,后面的工作应该跟着变化。Meta 的 MemoryBench 把干扰消息、相互冲突的信息和后来的更新混进长对话,检查模型还能不能找对关键内容。Wonder 与 Full 的成绩分别为 85.6、85.5。
Active Focus 则负责把任务继续推进。一次搜索没找到,换一个路径;程序测试失败,读取反馈再修改;途中条件变了,调整后续行动。需要澄清时向用户提问,重要操作前再确认。
Meta 展示的应用很有个人 Agent 的味道:按个人偏好和现实条件制定跑步计划,根据复杂匹配要求安排婚礼座位,还能用照片设计并订购定制商品。这些事情牵涉用户的具体条件,需要在浏览器和多个应用之间行动。
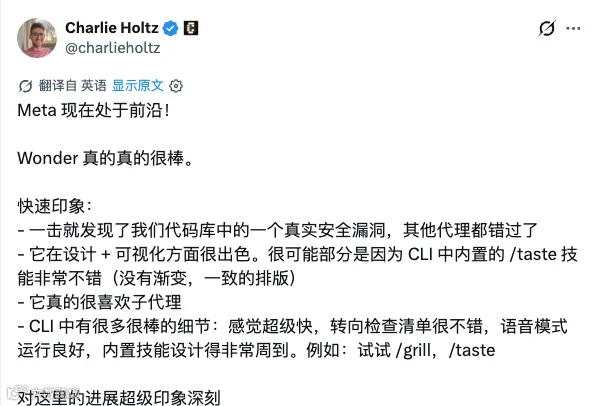
Muse Code 已经有了早期体验。Charlie Holtz 说,Wonder 在他的代码库里一次发现了其他 Agent 漏掉的真实漏洞;他还喜欢 CLI 的内置技能、任务清单和语音模式。
Meta 还想证明它有“大模型味儿”
Meta 在博客里提到了两个颇有意思的说法:benchmaxxing,过度追求跑分;big model smell,大模型味儿。
分数相近的两个模型,到了陌生任务里,表现未必一样。个人 Agent 尤其如此:用户的目标、工具和限制条件组合太多,训练时很难提前照顾到每一种。
于是 Meta 做了一组比较。横轴放模型在后训练重点优化任务上的得分,纵轴放没有被重点优化的任务上的平均表现。每个点对应一种推理设置。

Muse Spark 1.3 与 Wonder Full 的泛化实验
图里的 Wonder Full 趋势线整体更靠上。给定它在熟悉任务上的分数,陌生任务的成绩高于按 Spark 1.3 旧趋势预测的水平。
Meta 的解释是,Wonder 用上了更强的基础模型,让后训练带来的能力提升更容易迁移到其他任务。
已经能用,Full 先进入编程工具
Wonder 现在可以通过 Meta Model API 和 Muse Code 使用,Wonder Full 面向 Muse Code 订阅用户开放。 两款模型支持文本、图片、视频和音频输入,输出文本,上下文窗口为 100 万 token。
更强的能力也带来了更高的价格。Wonder 每百万 token 的输入价为 4 美元,缓存输入 0.20 美元,输出 20 美元。AA 同一套评测中的平均任务成本,从前代的 1.60 美元升到 4.52 美元;Full 目前没有公开的按 token 计价 API 成本。
接下来,Wonder 将进入 Meta 的个人 Agent 产品 Muse,先向订阅用户推送。眼下这轮竞争已经从模型榜单延伸到了实际产品:Muse Code 先用上更强的编程能力,Muse 则准备把记忆和持续执行带到日常任务里。
参考链接
-
Meta 发布介绍:https://research.meta.ai/blog/muse-wonder -
Muse Wonder 模型卡:https://research.meta.ai/static/muse-wonder-model-card -
Artificial Analysis 独立评测:https://artificialanalysis.ai/articles/muse-wonder