


编者摘要:高频垂直窄任务用个人或者企业微调的小模型即可。小模型微调无需大算力与专业团队,仅需200–500条高质量标注样本,微调1.5B级小模型,即可在垂直窄任务上优于通用大模型。微调核心不是提升模型通用智力,而是强化任务一致性、格式结构、领域话术与指令遵循。实时事实、市场数据不适合微调,需依赖RAG检索。正式微调前必须先搭建纯提示词、RAG、微调三套基线对比。优先选用0.5B–3B轻量化基座模型,规避大模型过拟合、高成本问题。数据环节重中之重:公开资源不代表可训练,需完整记录版权元数据,原始数据私有、代码公开。文本仅做降噪清洗,严禁篡改数字。数据集必须按企业/实体切分,禁止按页切分,避免虚高评测。采用QLoRA 4比特微调降低显存压力,严控训练轮数防止过拟合。评测以数字幻觉、无依据论断、输出质量为核心指标,测试集全程隔离。部署分层隔离网关与推理服务,迭代重训必须具备复核样本、失败记录、评测集与回滚方案。

10个关键问题问答
Q1:微调的真正作用是什么?A:不提升模型通用能力,只优化单一窄任务的稳定性、格式、语气、领域词汇、指令遵循。
Q2:什么场景绝对不适合微调?A:需要实时市场数据、竞品信息、动态事实的场景,这类需求只能用RAG检索。
Q3:为什么优先选1.5B小模型而非7B/14B?A:小模型显存成本低、训练快、运维简单,小数据集过拟合风险远低于大模型,够用即可。
Q4:数据最大的坑是什么?A:公开可下载≠可商用训练,必须确权留档;原始数据私有,处理代码与哈希元数据公开。
Q5:文本清洗的唯一原则?A:只去噪声、不修改语义与数字,禁止自动修正数值,避免模型输出错误数据。
Q6:数据集切分最关键规则?A:按公司/实体切分训练/验证/测试集,禁止按页面切分,杜绝假性泛化效果。
Q7:QLoRA微调核心优势?A:4比特量化加载模型,仅训练LoRA适配器,显存占用极低,效果接近全量微调。
Q8:如何判定模型幻觉?A:输出文本中出现原始素材不存在的数字与指标,即为幻觉、无依据论断。
Q9:生产部署的安全架构?A:禁止裸模型公网暴露,采用「鉴权限流网关 + 队列 + GPU推理服务」分层架构。
Q10:模型重训的必要条件?A:足量复核样本、明确失败模式、稳定评测集、版本化数据集、完整回滚方案,缺一不可。

附录 如何用自有数据微调小型大模型(完整指南)
作者:sai rahul1 9 月 18 日
你不需要 70B 大模型。 不需要十万美元算力。 不需要一支机器学习团队。 只用 200–500 条高质量样本微调一个 15 亿参数模型,在你的特定任务上,效果就能超过普通提示词驱动的前沿大模型。
本文是一份完整指南:数据采集、清洗、数据集构建、QLoRA 训练、Google Colab、模型评测、部署。 每一步附带可直接运行的代码。 收藏此文。喂给 AI,用你的数据完成微调。
微调的真实目标
大多数人以为微调是为了让模型变得更聪明。 并不是。 微调的作用,是让模型在某一个窄任务上稳定输出更好的结果。这就是它全部的价值。
本指南全程使用下面这个示例场景: 模型接收一份创业简报,示例输入:
我们帮助独立诊所减少失约,通过自动提醒、排程工作流以及患者随访。目前正在进行种子轮融资,用来扩充产品和销售团队。
输出融资路演文案,示例输出:
独立诊所每周都会因为人工处理预约提醒与改期而损失收入。我们的平台为诊所提供一套一体化工作流,无需增加行政人员,就能降低患者失约。我们从小中型诊所切入,这类机构运营低效带来高昂成本,而现有软件大多零散割裂。
文案干净、有据可依、不编造指标、没有生硬的幻灯片模板结构。 一个能稳定完成这项任务的 15 亿参数小模型,远比一个输出时好时坏的 70B 大模型更有价值。 这就是我们的核心思路。
微调不是你的第一步
在开始任何训练之前,先搭建三条基线: 基线 1:纯强提示词方案 基线 2:提示词 + 检索增强(RAG) 基线 3:微调后的模型
微调能够优化:语气、文本结构、输出一致性、领域词汇、指令遵循能力。 微调无法可靠地让模型掌握最新市场数据、竞品情报、实时事实。 如果模型需要获取当前市场规模或者融资趋势这类信息,请使用检索,而不是训练。
推荐可用架构: 创业简报 → 可选检索(市场数据、佐证材料)→ 微调小模型 → 纯文本输出
只有当纯提示词基线在某个特定问题上持续失效后,才启动微调。
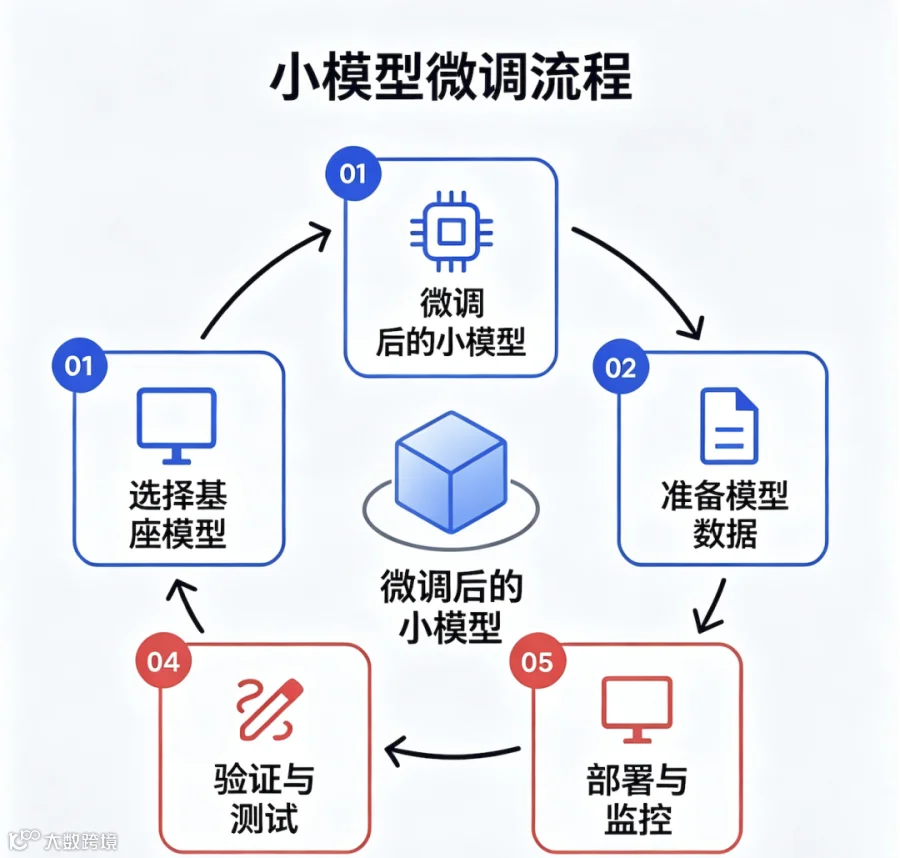
第 1 步 — 选择基座小模型
参数规模从 0.5B ~ 3B 之间开始。 推荐起点: Qwen/Qwen2.5-1.5B-Instruct← 本文首选 Qwen/Qwen3-0.6BHuggingFaceTB/SmolLM2-1.7B-Instruct
本指南选用:Qwen/Qwen2.5-1.5B-Instruct 模型足够小,可以在 T4 显卡上使用 QLoRA 训练;能力又足以完成高质量商业文案写作。
不要直接从 7B 或 14B 模型起步。更大的模型意味着:
-
更高显存需求 -
更长训练时间 -
更高推理服务成本 -
更多运维复杂度 -
小数据集上更高的过拟合风险
优先选用更小模型。只有评测失败时,再升级更大参数模型。
第 2 步 — 爬取任何数据前,先确认数据版权
这是所有人都会跳过的一步,也是风险最高的一步。 公开可访问 ≠ 拥有训练授权。
下载任何文件前,为每一条数据源记录下面信息:
source_record = {
    "source_id": "awesome-pitch-decks",
    "source_url": "https://github.com/...",
    "owner": "...",
    "rights_status": "approved",   # 必须是已核准,不能凭猜测
    "permission_scope": "training",
    "commercial_use_permitted": True,
    "redistribution_permitted": False,
    "rights_reviewed_at": "2026-09-17",
    "private_evidence_ref": "private://permissions/..."
}
✅ 可以放到公开 GitHub 仓库的内容:
-
数据源元信息 -
文件哈希值 -
数据处理代码 -
数据集结构定义 -
评测代码
🔒 必须私有保存,不公开:
-
原始 PDF 文件 -
OCR 识别输出 -
人工标注真值文本 -
许可邮件 -
用户提交的数据
先搞定版权这件事。剩下的都只是工程问题。
第 3 步 — 可复现的数据下载
绝不盲目爬虫。仅使用经过许可的 URL 白名单。 每一份文件都要记录:哈希值、时间戳、清单条目。 依靠文件内容哈希去重,不会静默重复下载。
from pathlib import Path
import hashlib, json, time, requests

APPROVED_URLS = [
    # 仅填写你拥有处理权限的URL
    "https://example.com/approved-pitch-deck.pdf",
]

RAW_DIR = Path("data/raw/approved-source")
RAW_DIR.mkdir(parents=True, exist_ok=True)

def sha256_file(path: Path) -> str:
    digest = hashlib.sha256()
    with path.open("rb") as f:
        for chunk in iter(lambda: f.read(1024 * 1024), b""):
            digest.update(chunk)
    return digest.hexdigest()

manifest = []

for url in APPROVED_URLS:
    filename = url.rstrip("/").split("/")[-1] or "download.pdf"
    destination = RAW_DIR / filename

    response = requests.get(url, timeout=60,
        headers={"User-Agent": "my-project/1.0"})
    response.raise_for_status()

    # 校验文件确实是PDF
    if not response.content.startswith(b"%PDF-"):
        raise ValueError(f"不是PDF文件:{url}")

    destination.write_bytes(response.content)

    manifest.append({
        "url": url,
        "filename": filename,
        "sha256": sha256_file(destination),
        "bytes": destination.stat().st_size,
        "downloaded_at": time.strftime("%Y-%m-%dT%H:%M:%SZ"),
    })

Path("data/raw/download-manifest.json").write_text(
    json.dumps(manifest, indent=2) + "\n", encoding="utf-8"
)
第 4 步 — 从 PDF 和 OCR 提取文本
融资路演 PPT 属于很难处理的文档:大段文字、微小脚注、图表、表格、旋转文字、图片内嵌数字、多栏排版。
采用级联提取策略:
-
优先原生 PDF 文本提取 ↓ 文本量足够 → 直接保留 ↓ 不足 -
版面感知 OCR(Docling、PaddleOCR) ↓ 效果合格 → 保留 ↓ 效果差 -
更换第二个 OCR 引擎,或者人工复核
所有结果都要记录,包括识别失败案例:
page_record = {
    "document_sha256": "...",
    "page_number": 12,
    "native_characters": 0,
    "machine_draft_text": "...",
    "machine_draft_engine": "docling",
    "machine_draft_status": "drafted",
    "machine_draft_latency_ms": 842.4,
    "review_status": "machine_draft_unverified",
    "gold_text": "",   # 人工复核前保持为空
}
关键规则:不要静默丢弃 OCR 识别为空的页面。 空识别结果就是最难处理的样本,它们能暴露流水线哪里出了问题。 机器识别草稿≠真值,千万不要混为一谈。
第 5 步 — 清洗文本,但不要破坏原文
清洗的含义是去除提取噪声,而不是美化文本。 安全清洗操作代码:
import re
import unicodedata

def clean_text(text: str) -> str:
    text = unicodedata.normalize("NFKC", text)
    text = text.replace("\x00", "")           # 删除空字节
    text = text.replace("\u00a0", " ")        # 不间断空格替换普通空格
    text = re.sub(r"[ \t]+", " ", text)       # 压缩连续空格
    text = re.sub(r"\n{3,}", "\n\n", text)    # 压缩过多空行
    return text.strip()
严禁自动修正数字。 如果 OCR 识别出错误内容,例如把$12.5M识别乱码,直接送入人工审核,不要用大模型自行修复。 模型一旦在错误数字上训练,输出文字再流畅,财务数字也会出错。
独立提取所有数字字符串,单独评估:
import re

NUMBER_PATTERN = re.compile(
    r"(?<!\w)(?:[$€£₹]?\s*)?\d[\d,.]*(?:\.\d+)?(?:\s*[%xXMBKmk])?"
)

numbers = NUMBER_PATTERN.findall(text) # ["$12.5M", "80%", "38%", "2024"]
数字要和文本质量分开评估,必须这样做。
第 6 步 — 构建训练数据集
原始 PPT 页面本身并不是训练数据。 一页 PPT 里可能只有标语、图表、免责声明或者 logo 墙。
你的训练任务是:
创业简报 → 融资路演文案
而不是:
PDF 页面 → 提取文本
你必须搭建这个转换桥梁。 每一条训练样本都需要: 输入:创业简报 + 可选上下文 输出:经过审核、有据可依的路演文案
JSONL 样本格式示例:
{
  "messages": [
    {
      "role": "system",
      "content": "撰写真实可信的英文融资路演文案,仅返回纯文本。禁止编造指标、客户、营收、市场规模或业务进展。"
    },
    {
      "role": "user",
      "content": "创业简报:\n我们帮助独立诊所通过自动提醒和患者随访降低失约。\n\n行业:\n医疗健康\n\n阶段:\n种子轮\n\n融资目标:\n扩充产品和销售团队。"
    },
    {
      "role": "assistant",
      "content": "独立诊所人工处理预约提醒与改期会损失收入,占用员工时间。\n\n我们的平台整合这套工作流,帮助诊所优化患者沟通,不增加人力负担。\n\n我们从小中型诊所切入,本次种子轮资金将用于产品迭代,强化渠道拓展。"
    }
  ]
}
输出刻意设计为纯文本。 不强制幻灯片页数,不输出 JSON,不带标题字段,不带列表字段。 上层应用再把纯文本转为所需要的任何格式。
不要随意自动生成训练样本。 安全构建顺序:
-
收集原始佐证材料 -
文本提取 -
撰写精简创业简报 -
起草目标文案 -
将目标文案和原始材料比对核验 -
人工复核目标文案 -
加入数据集
如果原始材料没有佐证某个指标,文案里就不要写这个指标。 仅当原文确实写了 “早期业务增长强劲”,你才可以使用这句话。 否则就写:公司聚焦扩大早期客户覆盖。
第 7 步 — 按公司划分数据集,不要按页面划分
这是一个会让评测彻底失效的数据错误。 如果同一家公司同时出现在训练集和验证集: A 公司 PPT 第 1 页 → 训练集 A 公司 PPT 第 2 页 → 验证集
模型只是记住这家公司特有的话术,看起来泛化能力很好,其实并不是。
✅ 正确做法:按公司划分A 公司 → 训练集 B 公司 → 训练集 C 公司 → 验证集 D 公司 → 测试集
推荐划分比例: 训练集:80% 验证集:10% 测试集:10%
保留划分清单 manifest:
split_manifest = {
    "split_version": "v1",
    "dataset_hash": "...",
    "train_company_ids": ["acme", "betahealth", ...],
    "validation_company_ids": ["cliniq", ...],
    "test_company_ids": ["deltacare", ...],
    "created_at": "2026-09-17T00:00:00Z",
}
一旦你用测试集跑完评测,就不要再修改测试集。 测试集评测之后就被 “消耗” 了;它会变成训练信号,不再是独立可靠的评测基准。
第 8 步 — 环境搭建
git clone https://github.com/yourname/your-project.git
cd your-project

python3 -m venv .venv
source .venv/bin/activate

pip install --upgrade pip
pip install \
  torch \
  transformers \
  datasets \
  accelerate \
  peft \
  trl \
  bitsandbytes \
  sentencepiece \
  safetensors

pip freeze > configs/training-environment.txt
2 核 4G 的 VPS不适合训练。 它适合做这些: ✅ API 网关、鉴权、限流、请求队列、Redis、日志、健康检查、部署控制器
不适合: ❌ 1.5B 模型 QLoRA 训练、GPU 推理、模型线上服务。
各司其职,不同任务匹配不同服务器。
第 9 步 — 使用 QLoRA 训练
QLoRA 以 4bit 精度加载基座模型,只训练一个小适配器。 显存占用远低于全参数微调,效果几乎持平。
# scripts/train_qlora.py
from pathlib import Path
import torch
from datasets import load_dataset
from peft import LoraConfig
from transformers import (
    AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
)
from trl import SFTConfig, SFTTrainer

BASE_MODEL = "Qwen/Qwen2.5-1.5B-Instruct"
DATA_DIR = Path("data/processed")
OUTPUT_DIR = Path("artifacts/adapters/v1")

use_bf16 = torch.cuda.is_available() and torch.cuda.is_bf16_supported()
compute_dtype = torch.bfloat16 if use_bf16 else torch.float16

dataset = load_dataset("json", data_files={
    "train": str(DATA_DIR / "train.jsonl"),
    "validation": str(DATA_DIR / "validation.jsonl"),
})

tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

quantization_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=True,
)

model = AutoModelForCausalLM.from_pretrained(
    BASE_MODEL,
    quantization_config=quantization_config,
    device_map="auto",
    torch_dtype=compute_dtype,
)

lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    target_modules="all-linear",
    task_type="CAUSAL_LM",
)

training_args = SFTConfig(
    output_dir=str(OUTPUT_DIR),
    num_train_epochs=2,
    per_device_train_batch_size=2,
    per_device_eval_batch_size=2,
    gradient_accumulation_steps=8,
    learning_rate=2e-4,
    max_length=2048,
    packing=True,
    gradient_checkpointing=True,
    logging_steps=10,
    eval_strategy="steps",
    eval_steps=50,
    save_strategy="steps",
    save_steps=50,
    save_total_limit=2,
    bf16=use_bf16,
    fp16=not use_bf16,
    report_to="none",
)

trainer = SFTTrainer(
    model=model,
    args=training_args,
    train_dataset=dataset["train"],
    eval_dataset=dataset["validation"],
    processing_class=tokenizer,
    peft_config=lora_config,
)

trainer.train()
trainer.save_model(str(OUTPUT_DIR))
tokenizer.save_pretrained(str(OUTPUT_DIR))
运行命令:
accelerate config
accelerate launch scripts/train_qlora.py
关键超参说明:
-
r=16 → LoRA 适配器秩,推荐起点 -
lora_alpha=32 → 适配器缩放,一般取秩的 2 倍 -
lora_dropout=0.05 → 正则项 -
learning_rate=2e-4 → LoRA 推荐起始学习率 -
num_train_epochs=2 → 轮数从低起步,过拟合风险真实存在 -
gradient_accumulation_steps=8 → 模拟更大批次 -
packing=True → 短样本提升 GPU 利用率
不要仅仅因为训练损失下降,就增加训练轮次。 模型完全可以背诵训练样本,但在从未见过的公司样本上效果变差。 训练损失降低 ≠ 泛化效果变好。
第 10 步 — 在 Google Colab 上训练
Colab 非常适合初步实验,免费 GPU,不用维护服务器。
利弊: ✅ 免费 T4 用于实验;无需基础设施维护;适合 Notebook ✗ 会话随时断开;GPU 资源随时间波动;会话重置存储丢失;不适合生产训练
新建 GPU 笔记本,查看显卡:
!nvidia-smi
挂载云盘保存检查点:
from google.colab import drive
drive.mount("/content/drive")
安装依赖:
%pip install -U torch transformers datasets accelerate \
peft trl bitsandbytes sentencepiece safetensors
路径指向谷歌云盘:
from pathlib import Path

DATA_DIR = Path("/content/drive/MyDrive/my-project/processed")
OUTPUT_DIR = Path("/content/drive/MyDrive/my-project/adapters/v1")
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
每 50 步保存一次,而不是等到训练结束。 如果训练到 95% 会话断开,你可以从检查点恢复,而不是从头跑。
# 如果会话中断,从检查点恢复训练
trainer.train(resume_from_checkpoint=True)
每次运行都记录环境,保证可复现:
import torch, transformers, trl, peft, platform

print("Python:", platform.python_version())
print("Torch:", torch.__version__)
print("Transformers:", transformers.__version__)
print("TRL:", trl.__version__)
print("PEFT:", peft.__version__)
print("GPU:", torch.cuda.get_device_name(0)
      if torch.cuda.is_available() else "none")
第 11 步 — GPU 服务商选型策略
不同阶段选用不同基础设施。
-
Google Colab:适合初步实验、调试、小规模 QLoRA 任务;不适合生产、长时间稳定任务 -
竞价 GPU 服务商(RunPod、vast.ai、Modal、Lambda、Paperspace):适合长时间训练、按秒计费、可复现 Docker 环境;不适合线上服务、低延迟稳定业务 -
专属 GPU 托管:适合对外服务、稳定推理延迟、生产部署;不适合实验(闲置也要计费)
每次跑之前核对实时价格,GPU 价格波动频繁。
训练成本估算: GPU 单价:0.4 美元 / 小时 有效训练时长:3 小时 重试开销:1 小时 存储:0.1 美元 合计:(0.4 × 4)+0.1 = 1.7 美元
最贵的往往不是第一次训练。 反复实验才烧钱:修改提示词、修复数据集 bug、测试不同 r 值(8/16/32)、尝试不同基座模型、多次评测、持续跑推理测试。 预算预估,要按初次估算的 5–10 倍预留。
第 12 步 — 和纯提示词基线做对比评测
不要只用训练损失评估模型。 拿它和你之前在用的方案对比。
固定评测指标:
-
纯文本合规性(禁止 JSON、固定幻灯片模板) -
输出有用度(人工打分 1–10 分) -
无依据论断率 -
数字保留准确率 -
重复率 -
可读性 -
推理延迟 -
Token 用量 & 单请求成本
数字一致性校验代码:
import re

NUMBER_PATTERN = re.compile(
    r"(?<!\w)(?:[$€£₹]?\s*)?\d[\d,.]*(?:\.\d+)?(?:\s*[%xXMBKmk])?"
)

def numeric_strings(text: str) -> set[str]:
    return {n.replace(" ", "") for n in NUMBER_PATTERN.findall(text)}

def unsupported_numbers(source: str, generated: str) -> set[str]:
    """输出文本中,原始材料不存在的数字集合"""
    return numeric_strings(generated) - numeric_strings(source)
生成文本中出现原始证据里不存在的数字,就是幻觉。 在交付用户之前就把这类问题抓出来。
示例评分卡:
纯提示词基线: 文案有用度:7.1/10 无依据论断占比:8% 数字错误率:3% 平均延迟:2.4 秒
微调模型: 文案有用度:8.0/10 无依据论断占比:2% 数字错误率:1% 平均延迟:1.5 秒
只有在评测前测试集就完全隔离的前提下,才能宣称效果提升。如果你提前看过测试集,这些结果毫无意义。
第 13 步 — 部署适配器
两种方案,按流量选择:
方案 A:vLLM(高吞吐场景)
vllm serve Qwen/Qwen2.5-1.5B-Instruct \
  --enable-lora \
  --lora-modules mymodel=./artifacts/adapters/v1 \
  --max-model-len 2048
部署前查阅当前版本 vLLM LoRA 文档,不同版本参数会变动。
方案 B:FastAPI + Transformers(低流量场景)
from fastapi import FastAPI
from fastapi.responses import PlainTextResponse
from pydantic import BaseModel

app = FastAPI()

class StartupBrief(BaseModel):
    brief: str
    industry: str | None = None
    stage: str | None = None
    traction: str | None = None
    fundraising_goal: str | None = None

def render_prompt(request: StartupBrief) -> str:
    optional = []
    for label, value in [
        ("Industry", request.industry),
        ("Stage", request.stage),
        ("Traction", request.traction),
        ("Fundraising goal", request.fundraising_goal),
    ]:
        if value:
            optional.append(f"{label}:\n{value}")

    context = "\n\n".join(optional)

    return f"""Write grounded English funding-pitch copy. Return plain text only. Do not return JSON. Do not invent statistics, customers, revenue, or market size.

Startup brief: {request.brief}

{context}""".strip()

@app.post("/generate", response_class=PlainTextResponse)
def generate(request: StartupBrief) -> str:
    prompt = render_prompt(request)
    # 在此加载模型并调用推理
    return "生成的路演文案放在这里。"
永远不要把裸模型服务直接暴露在公网。生产架构: 客户端 → HTTPS 鉴权 → VPS 限流 → 请求队列 → GPU 模型服务 → 返回纯文本
VPS 负责:TLS 加密、身份鉴权、限流、排队。 GPU 只负责推理。
第 14 步 — 部署后质量监控,以及何时重训
上线第一天就要跟踪这些指标: 请求延迟、排队时长、GPU 显存利用率、错误率、空输出、单请求 token 数量、用户重试率、无依据内容上报、模型版本与适配器版本。
不要自动采集用户数据用于重训练。必须显式获取用户授权勾选:
本次请求内容可用于优化模型。□是,我同意 □否
就算用户同意,入库前也要剥离敏感信息: 手机号、邮箱、客户名称、私有营收数据、保密融资条款、投资人联系方式。
生产训练数据集,永远和评测数据集隔离。
什么时候重训? 不是每一条用户提交数据都触发重训。满足下面全部条件才启动: ✅ 足量经过复核的样本(不是原始用户提交记录) ✅ 清晰并文档化的失败模式 ✅ 稳定独立的评测集 ✅ 带版本记录的数据集 ✅ 回滚方案
推荐迭代节奏: v0:纯提示词基线 v1:200 条复核样本 v2:1000 条复核样本 v3:更大数据集 + 检索增强
每个版本都记录:
version_record = {
    "version": "v2",
    "base_model": "Qwen/Qwen2.5-1.5B-Instruct",
    "base_model_revision": "...",
    "dataset_hash": "...",
    "num_train_examples": 1000,
    "gpu_type": "A10G",
    "total_gpu_hours": 4.2,
    "eval_useful_copy": 8.3,
    "eval_unsupported_claims": 0.018,
    "eval_numeric_errors": 0.009,
    "deployment_date": "2026-09-20",
    "rollback_artifact": "artifacts/adapters/v1",
    "known_failure_modes": ["简报超过500token时效果变差"],
}
没有文档化的回滚方案,就不要部署。
一套真正可行的完整流程
如果我亲自做这个项目,会按下面顺序执行:
-
原始 PDF、OCR 草稿私有保存 -
完成 50 页人工复核样本(原生数字文档、扫描件、图表密集、表格、带数字页面、无文字空白页) -
构建 200–500 条「简报→文案」人工核验样本 -
搭建纯提示词基线(训练前就完成评测) - 按公司划分数据集,而不是页面
-
在 Colab T4 或者低价临时 GPU 跑 QLoRA 实验 -
每 50 步保存检查点到云盘 -
使用未见过的公司样本做评测 -
对比三组方案:纯提示词 / 检索增强 / 微调模型 -
只在模型出错的场景补充更多样本 -
在 GPU 推理服务后部署 LoRA 适配器 -
VPS 作为安全网关 -
压力测试,确认可承载并发请求 -
监控事实性、虚假论断 -
只使用经过审核、拥有授权、用户主动同意的数据重训
提升效果最大的杠杆,往往不是调学习率。 而是样本质量。
清晰创业简报 + 可核验原始证据 + 人工审核目标文案 + 企业级数据集划分 = 可靠的专业小模型
这就是把 15 亿参数模型变成真正可用工具的秘诀。
项目目录结构
your-project/
├── data/
│   ├── raw/           # 私有,git忽略不上传
│   ├── processed/     # 私有或git忽略
│   └── splits/        # 仅存放划分清单,可以提交到代码仓库
├── scripts/
│   ├── download_sources.py
│   ├── clean_ocr.py
│   ├── build_examples.py
│   ├── train_qlora.py
│   └── evaluate.py
├── configs/
│   ├── data.toml
│   └── training.toml
├── notebooks/
│   └── train_colab.ipynb
├── artifacts/
│   └── adapters/      # 私有模型输出文件
├── tests/
└── docs/
原始数据私有;处理代码公开;评测代码公开。 即使原始数据不公开,你的训练流水线仍然具备可复现性。
参考文档
Hugging Face TRL SFTTrainer → https://huggingface.co/docs/trl/en/sft_trainer PEFT
量化指南 → https://huggingface.co/docs/peft/en/developer_guides/quantization bitsandbytes
集成文档 → https://huggingface.co/docs/bitsandbytes Google Colab 常见问题 → https://research.google.com/colaboratory/faq.htmlQwen2.5-1.5B-Instruct
模型卡 → https://huggingface.co/Qwen/Qwen2.5-1.5B-Instruct vLLM LoRA
部署文档 → https://docs.vllm.ai/en/latest/features/lora.html RunPod 定价 → https://runpod.io/pricing Modal 定价 → https://modal.com/pricing