

智猩猩AI整理
编辑:林夕
DeepSeek有时会突然答错,问题可能出在一个意想不到的地方:
你只是给代码加了一段注释,它却可能连答案都变了。
在一项最新研究中,研究者不断改变代码前面一段无关注释的长度,DeepSeek-V4-Flash-Base对同一处代码的预测竟然出现周期性变化:
正确答案是8,模型有时却会转而预测32。
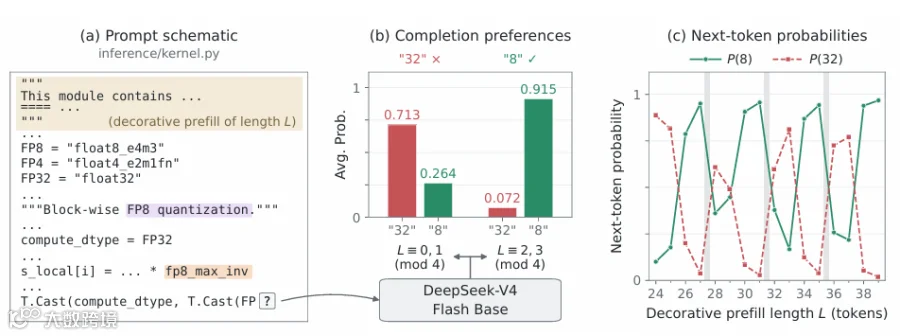
代码没变,任务没变,仅仅调整了前面文本的长度,模型的预测就可能发生变化。
这并非孤立的代码补全案例。
近日,字节跳动Seed联合普林斯顿大学、斯坦福大学和加州大学伯克利分校的研究者发现,DeepSeek-V4系列模型在长上下文检索中也可能存在周期性弱点。
在128K上下文的特定检索实验中,DeepSeek-V4-Flash-Base不同位置组之间的准确率最高相差40.2个百分点。
即使经过后训练,部分模型仍然存在明显的位置差异。
研究者将这一现象称为“相位敏感性”(Phase Sensitivity),并发现它与分块KV Cache压缩机制密切相关。
相关论文《Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression》已于9月28日提交。
在长上下文推理中,KV Cache用于保存模型处理过的历史信息。
分块压缩会将一段连续Token的信息压缩成更少的缓存条目,从而降低内存占用和推理成本。
但研究者发现,压缩还引入了一个容易被忽视的位置因素:目标信息在压缩窗口中的相对位置。
当同一条信息落在不同位置时,模型能够检索到它的概率可能明显不同。
01
只改注释长度,
DeepSeek的答案就变了
研究团队首先从DeepSeek-V4的代码补全表现入手。
在一个FP8量化函数中,模型需要在类型转换表达式的FP后补全字符,正确答案是8。
如果补成32,就会重复外层代码已经执行过的类型转换,导致代码行为偏离预期。
研究者在代码前添加一段无关的文档注释,并通过改变注释中等号的数量来调整长度,随后观察模型的预测变化。
结果显示,随着前置文本长度变化,模型会在正确答案8和错误答案32之间周期性切换。
与此同时,研究团队还测试了24至39个Token的16种填充长度。
其中,8种情况下模型更偏好8,另外8种情况下则更偏好32。
这种变化以4个Token为周期重复,恰好对应DeepSeek-V4的KV Cache压缩步长。
前置注释虽然不影响代码逻辑,却改变了模型对补全结果的偏好。
代码补全任务由此提供了一个直观线索:模型的预测可能受到信息相对于压缩窗口的位置影响。
研究者还测试了其他填充方式,以及DeepSeek-V4-Flash-0731、DeepSeek-V4.1-Flash等模型,均观察到与压缩步长对应的周期性变化。
作为对照,不采用同类分块KV Cache压缩机制的DeepSeek-V3.1-Base,则没有出现明显的周期规律。
这种现象是否也会影响长上下文检索?
研究团队将测试扩展到128K Token的上下文,设置约16,000组键值对,让模型根据给定的键找回对应的值。
结果显示,DeepSeek-V4-Flash-Base不同位置组的检索准确率最高相差40.2个百分点,DeepSeek-V4-Pro-Base也相差34.8个百分点。
经过后训练后,位置差距有所缩小,但依然存在:
DeepSeek-V4-Flash为19.1个百分点,DeepSeek-V4-Pro为14.8个百分点,DeepSeek-V4.1-Flash则为6.1个百分点。

02
不只是DeepSeek:
受控实验指向KV Cache压缩
仅凭DeepSeek系列模型的实验,还无法完全排除其他架构因素的影响。
为了进一步判断周期性弱点是否与分块KV Cache压缩有关,研究团队从头预训练了一系列受控模型。
研究者使用Qwen3-0.6B作为基础架构,训练不同配置的模型,并设置不采用分块压缩的全注意力模型作为对照。
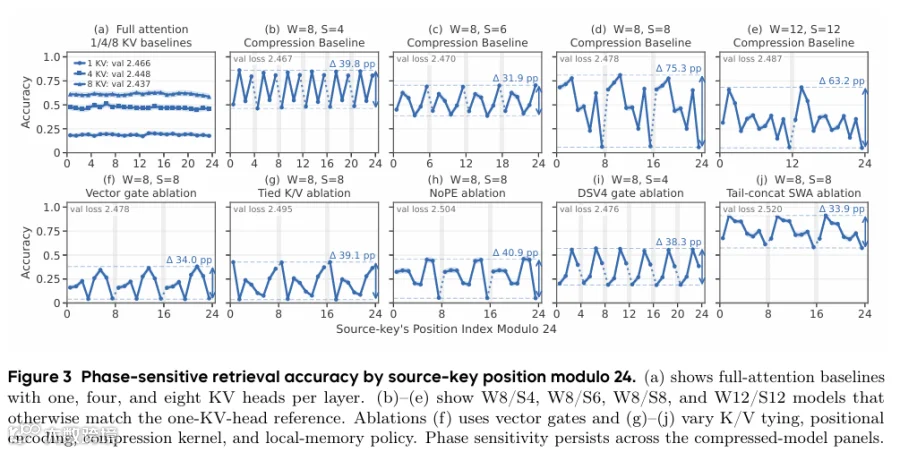
结果显示,在研究团队测试的配置中,采用分块压缩的模型出现了周期性的检索差异,而全注意力基线的准确率曲线相对平坦。
研究者还改变了压缩窗口大小、压缩步长和压缩方式。
实验显示,检索表现的周期主要随压缩步长变化:不同步长对应不同的周期长度。
即使移除旋转位置编码(RoPE),或者用均匀平均替代学习得到的压缩权重,周期性现象依然存在。
这些受控实验进一步支持了论文的核心判断:
周期性弱点与分块KV Cache压缩结构密切相关,不能简单归因于某一种位置编码方式,也不完全取决于压缩门控如何分配权重。
03
注意力组件逐渐形成位置偏好,
可能是重要线索
为了分析周期性弱点如何形成,研究团队进一步对模型内部的注意力组件进行干预。
研究者逐一削弱相关组件携带的当前样本信息,再观察模型在不同位置组上的检索准确率变化。
如果干预某个组件后,特定位置的准确率明显下降,就说明该组件对这一位置的信息检索具有重要作用。
实验发现,采用分块压缩的模型中,不同注意力组件对不同位置的信息检索贡献并不相同,部分组件的影响还会随压缩步长呈现周期性变化。
研究团队将这种现象称为相位专门化(Phase Specialization)。

模型内部的不同注意力组件可能逐渐形成位置分工:
一些组件对特定位置的信息更重要。
当目标信息落在它们不擅长的位置时,模型的检索表现就可能变差。
研究团队还分析了压缩门控在训练过程中的变化。门控决定压缩窗口内不同Token对缓存条目的贡献程度。
实验表明,一些注意力头会逐渐对压缩窗口中的特定位置形成稳定偏好。
这些偏好与相应组件在不同位置上的检索贡献存在关联。
例如,在研究团队的一个受控模型中,第14层、第10层和第9层的部分门控分别偏向压缩窗口中较早、中间和较晚的位置。
对应的注意力组件在相关位置上也表现出更明显的检索贡献。

研究者据此提出,门控形成的位置偏好,可能参与了相位专门化的形成过程。
不过,这部分机制解释仍有边界。
研究团队的部分干预实验是在整层注意力输出上进行的,并非对所有实际模型中的单个KV头逐一完成因果验证。
理论分析也依赖特定假设,不能直接推广为所有大模型的普遍规律。
这项研究对长上下文模型评测提出了一个值得关注的问题:
模型能处理多少Token、整体检索准确率有多高,并不足以完整反映它在不同位置上的表现。
对于代码助手,可以在保持代码逻辑不变的情况下改变前置注释长度,观察模型能否稳定给出正确补全。
对于长文档问答,则可以移动目标信息的位置,比较不同压缩相位下的检索表现。
研究团队建议,对采用分块KV Cache压缩的模型进行评测时,应系统测试目标信息处于不同相位时的表现,而不只是报告平均准确率。
KV Cache压缩能够降低长上下文推理成本,但如何在提高效率的同时,确保不同位置的信息都能被可靠检索,仍是模型架构与推理系统需要继续解决的问题。
END
关注+星标,获取AI前沿进展与开源一线动态