

在 AI Engineer World's Fair 上,Diogo Almeida 分享了《What's next after RLHF?》主题演讲(录像视频后更名为《Jev CEO: I made ChatGPT, now I'm building what's next》)。
Diogo 是 TypeSafe AI 的联合创始人兼 CEO,也是 Jev 的创造者。他曾参与 GPT-4 和 ChatGPT 的开发,并共同撰写了 InstructGPT/RLHF 论文;"后训练"这个概念正是由他的团队开创的。而这场演讲,他要拆的恰恰是自己参与缔造的范式。
Diogo 的开场就带着一种自我拆台的意味。今天的 AI 一切都继承自 RLHF——在"人在回路"上表现惊人,但不擅长自动化。这是他给出的第一个结论。
在他看来,AI"好得离谱"与"差得离谱"的撕裂本身就是一种误诊。真正的分水岭不在于能力高低,而在辅助与自动化:一类任务生来要取悦回路里的那个人,另一类的目标则是把人彻底移出去。
而 RLHF 在训练时,字面意义上就是把人硬塞进了那个回路里。它的原理总结起来只有两句话:收集人类偏好,针对人类偏好做优化。
于是所有人都被困在同一个错位里:大家拼命想做自动化,手里拿的却是一套只会自信迎合的架构。
这引出了 Diogo 的第二个结论:今天的 AI 是通过"针对人类偏好做优化"来设计的,其目标就是辅助。 也正因如此,下一个时代不是 Claude Code 时代——它仍然属于辅助时代,内核仍然是 RLHF。
他用软件举例:我们只是把"写软件"自动化了,软件本身的表达力却原地踏步。 自动化的本质从来不是把一个人的工作整体打包交给 AI,而是锁定那些机械、重复、规则清晰的事务,交给计算机近乎零成本地反复执行。但这件事,并没有在软件身上发生。
所以第三条路是必需的:RLHF 优化人类偏好,RLVR 优化纯粹正确性的对数错误率,而 TypeSafe 做第三种——为经过校准的决策而优化,把预训练的智能直接接进去,让它对软件真正有用。
在 Diogo 看来,明天的 AI 属于自动化,我们会迎来更聪明的软件,真实工作开始被实质自动化。这是本场演讲的第三个结论,也是它的落点:辅助之后,是真正的自动化。
当时仍处在半隐身状态的 TypeSafe 赌的就是这件事;一个半月后,Jev 发布。
以下是演讲回顾:
Diogo Almeida:今天讲"RLHF 之后是什么"。更准确地说,应该叫"我们所处的 ChatGPT 时代之后是什么"。先给个提示:下一个时代不是 Claude Code 时代,我认为它和 ChatGPT 属于同一个时代。
我是 OpenAI 内部少数真正会"黑"ChatGPT 的人。 我讨厌的不是这个产品,它能改变世界并且一直陪伴我们。但我承认它的局限:今天这个领域的很多现状,都能追溯到我们设计 ChatGPT 背后算法时所做的一些很小的决定。
01
两种极端并存
中间地带完全缺失
当下每个 AI 从业者都该问的是:到底发生了什么?
一端认为 AI 不只是好,而是好得离谱:几乎每个基准都被超越人类水平且还在加速,NLP 基准被成片碾压,据称大模型能自主运行的时长呈指数增长。
另一端认为 AI 不只是差,而是差得离谱:这是泡沫,没有真实价值,只有循环融资。如果 AI 真那么厉害,为什么落地形态还只是一个聊天框、或一个 Claude Code?"变革性 AI 革命"已经没人提了,而是改口说它会像 B2B SaaS 一样"非常有价值"。
所以唯一的共识是:两种极端并存,中间地带完全缺失。 每个人都觉得对方疯了,只是理由相反。
02
"辅助"与"自动化"的分水岭
把两边的证据摊开,最简单的解释是什么?

左边的任务不只是"恰好有人在回路中"——它们的目标本身就是取悦回路里的那个人。比如Claude Code 的使命不只是让代码跑通;如果只求跑通,它的交互方式会完全不同。
右边那些更基础的任务,目标恰恰是把人从回路里移除:理想情况下它应该在无需查看的后台服务器上运行,最终沉淀成你不必再操心的存量软件(legacy software)。
这就是"辅助"与"自动化"的分水岭。
我这场演讲的第一个结论:今天的 AI 一切都继承自 RLHF——在"人在回路"上表现惊人,但不擅长自动化。
几乎每个企业都学到了这个教训:不要用 AI 做重大决策。通行做法是让成本由用户而非企业承担,丢文档给用户没问题,让 AI 决定一笔昂贵的退款绝对不行。
03
收集人类偏好
针对人类偏好做优化
RLHF 不只是 ChatGPT 背后的算法,也是今天每一个大模型背后的算法:按使用量算,约 100% 的调用都跑在 RLHF 训练过的模型上。
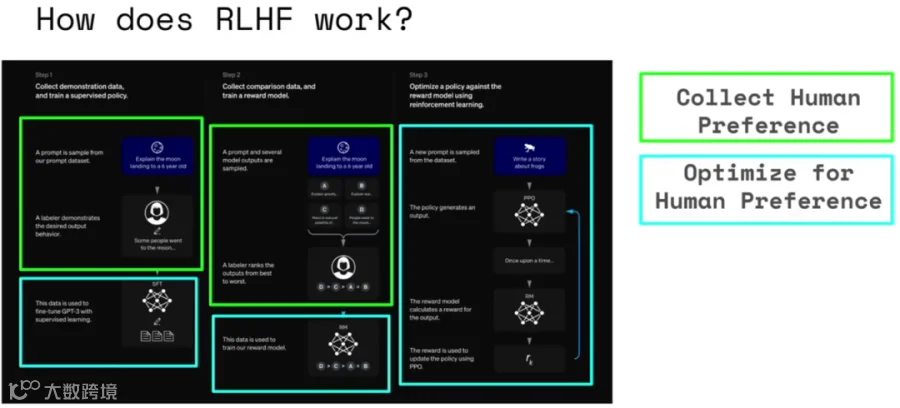
OpenAI 团队曾写过一篇博客文章解释它的原理,总结一下就是两句话:收集人类偏好,针对人类偏好做优化。
这也就回答了"为什么所有大模型都需要人在回路"——答案简单到可笑:我们训练它时,字面意义上就是把人硬塞进了那个回路里。 这个回路的目标就是针对人类偏好做优化,而不是让软件自主运行。
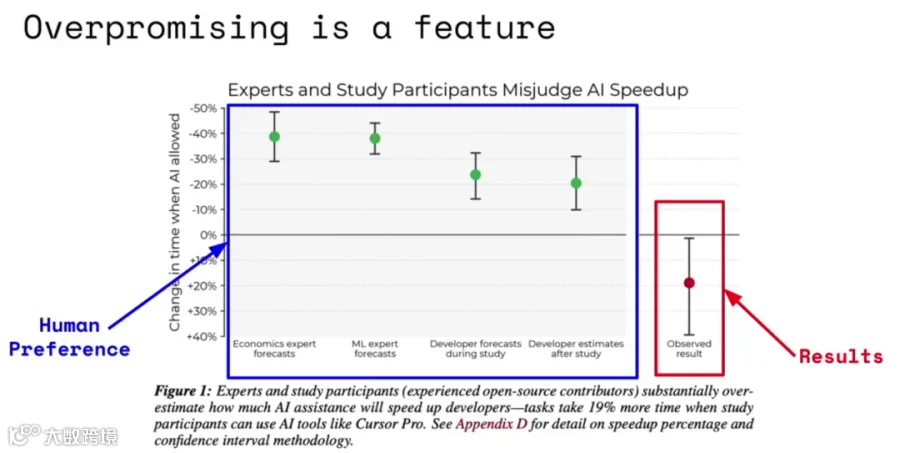
所以"过度承诺"不是 bug,是被设计出来的特性。一项较早的元分析显示(数字可能已变):由于首要目标是人类主观满意度,任何 RLHF 模型在"人类偏好分"与"客观结果"之间永远存在落差——即使结果是好的。
推特上有个例子:有人给 ChatGPT 发一段放屁音效,问"我做的这首曲子怎么样"。它一本正经地回答:这是一首氛围感十足、颇为阴森的作品。
这就是 RLHF 的工作方式:当它不确定时,它会倾向于最符合人类偏好的那个答案。 对聊天框里的用户这完全合理——所有 RLHF 模型的终局目标是优化参与度。但自动化要的恰恰相反:它不该在乎人的脸色,只以高度校准的方式把事做对。
第二个结论:今天的 AI 是通过"针对人类偏好做优化"来设计的,其目标就是辅助。奖励模型的不对称性,使得无论模型错得多离谱,它看起来永远合理、永远自信。 这是行业两难的死结——大家拼命想做自动化,手里拿的却是一套只会自信迎合的架构。
04
辅助之后,是真正的自动化
我认为真正的问题是:AI 的辅助时代之后是什么? 而我们非常确定地正处在那个时代里。
回到最开始的提示:为什么说下一个时代不是 Claude Code 时代?因为它仍属于辅助时代,内核仍是 RLHF。如果它纯粹是 RLVR 驱动的,形态和界面会非常不同。
很多 Agent 团队都陷在同一个死循环:模型有时自主性很强,一调就又不听指令;两种目标来回拉扯,却都没给"自动化"增加任何东西。
逻辑终局只有一个:辅助之后,是真正的自动化。
05
只是把"写软件"自动化了
软件本身的表达力原地踏步
软件极其有价值,看看满世界的 SaaS 就知道了。而最疯狂的是:基本上所有 SaaS 自 2019 年以来就没变过。 大模型时代它唯一的变化,是侧边栏挂了一个聊天框。

想想 AI 的进步,这很荒谬;但承认 AI 天生是"辅助原生"的就顺理成章:工具只是个助手,除了在旁边放个对话框,还能干什么?
这并不是早期先驱设想的未来。翻翻 OpenAI 最早的章程(charter),讲的是承担海量繁重的工作,不是盈利、也不是对话框。我们曾以为软件本身会变聪明,而不只是写代码变便宜。
Garry Tan 赞美说我们正进入"即时软件"的黄金时代。我认为这是把双刃剑——我也用 Claude Code 和 ChatGPT,但我要的是更聪明的软件本体。为什么软件的“积木”到今天还是老样子?
自动化的本质不是把一个人的工作整体打包给 AI,而是锁定那些机械、重复、规则清晰的事务,交给计算机近乎零成本地反复执行。
但这根本没发生。我们只是把"写软件"自动化了,软件本身的表达力原地踏步。
06
TypeSafe为可靠性重做技术栈
我相信行业终将认为 RLHF 是一段奇怪的弯路——我不想说它错,但它出乎我们意料。
第三个结论:明天的 AI 属于自动化,我们会迎来更聪明的软件,真实工作开始被实质自动化——尽管今天的模型已这么聪明,真正被自动化的比例仍只是一个舍入误差(rounding error,即可忽略不计)。
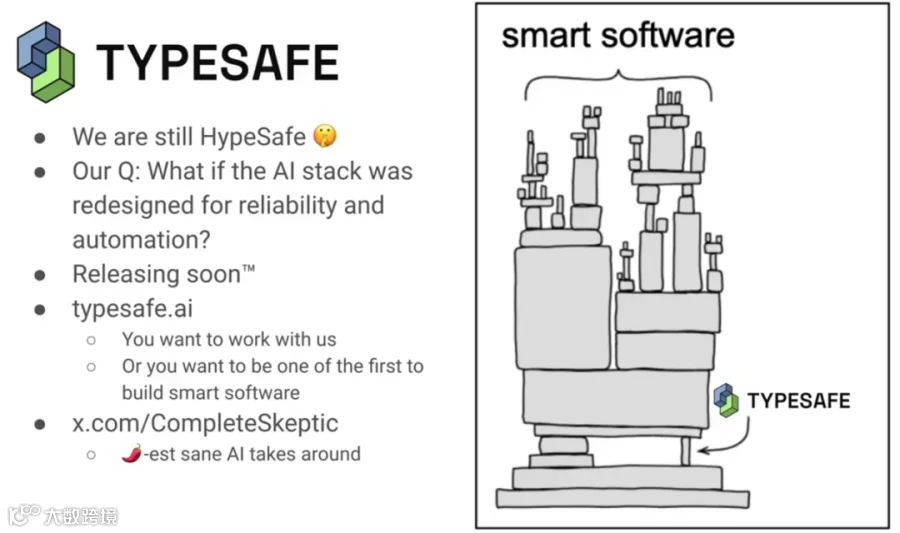
这正是我们在 TypeSafe 做的事。我们的核心问题是:如果整个 AI 技术栈从头围绕可靠性与自动化重新设计,架构会怎么变? 这是与今天几乎所有大模型分道扬镳的岔路口。我们很快会发布。
07
问答环节
问:像 Bengio 建议的那样,预训练时同时训一个分类器头,会怎样?
答:问题不在预训练。把整个互联网压缩进一个可调用的智能内核,本身就是不可思议的成就;问题在于后训练如何把这份智能"挖"出来。
幻觉是"针对人类偏好做优化"的内生产物。奖励模型的不对称性类似 GAN 的 mode dropping:它促使模型丢掉某些模式并保持自信。因为"我不确定"极易被奖励模型识别和惩罚,而用自信权威的口吻编造反而能拿高分。
问:你们做的是 RLVR 吗?
答:绝对不是,是一个新东西。 Sutton 的《苦涩的教训》讲的是可扩展的通用方法加算力最终胜过人类先验,即算力比算法更重要——这在游戏里成立,在现实中不成立。完整的排序是:数据比算力重要,而做对的"任务"又远比数据重要。
后训练的每个分支都有自己的“北极星指标”:RLHF 优化人类偏好;RLVR 优化纯粹正确性的对数错误率;我们做第三种——为经过校准的决策而优化,把预训练的智能直接接进去,让它对软件真正有用。
问:奖励是贯穿整个过程注入的吗?
答:连 API 的形态都不一样。 RLHF、RLVR 和我们这套,三者的对外接口根本不同。我们是一切从零重新思考的——就像 InstructGPT 之前没人想过"指令遵循"这回事。后训练每次出现真正的重大分叉,新东西在诞生时都被视为异类,事后回想却又理所当然。
END
关注+星标,获取AI前沿进展与开源一线动态