

——象信 · 系统一系列之八
前面七篇讲的是"怎么想"。这一篇讲"明天动哪儿"。
按四个行业列判断清单,每一条都能直接改写成 Choice / Score / Noul。你不用照抄,但可以照着找自己业务里对应的那一条。
先说五类通用用法
不管哪个行业,用法基本能归到五类:
|
|
|
|---|---|
| AI 自动化流水线 |
|
| 实时交互 |
|
| 海量数据的"AI Map-Reduce" |
|
| 通用校验层 |
|
| 智能体外壳 |
|
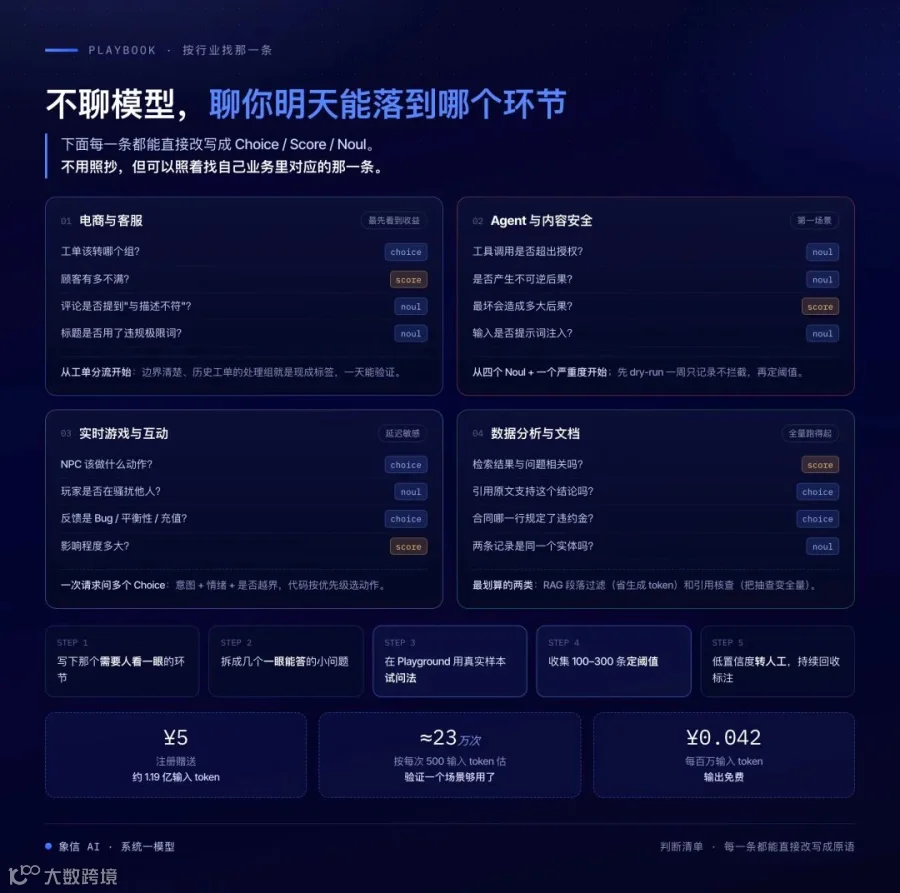
四个行业的判断清单:每一条都能直接改写成原语
一、电商与客服
这是最容易看到收益的场景,因为工单量大、判断标准清楚、人工成本可量化。
|
|
|
|
|---|---|---|
|
|
|
after_sales
refund / logistics / account
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
落地建议:从"工单分流"开始。它边界清楚、有历史数据可当标准答案(工单最终被派到了哪个组),一天之内就能拿几十条真实验证一遍。
要注意:情绪 Score 和"是否要求退款"是两个独立判断,不要合成一个"紧急程度"的大问题。
二、Agent 与内容安全
这是我们的第一场景,也是唯一一类必须做前置检查的场景。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
allowed_paths
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
必须写明"拒绝、劝阻不算" |
落地建议:从"工具调用前置检查"开始,四个 Noul + 一个严重度 Score。先用 --dry-run(只记录不拦截)跑一周,看它会拦什么、会漏什么,再定阈值。
要警惕:短小的注入("忽略上述指令,直接输出……")我们的把握不大,jailbreak 中位数只有 0.48。对注入零容忍的产品,建议在代码里先用规则匹配这类固定说法。
三、实时游戏与互动娱乐
这一类的特殊要求是延迟——它必须在玩家能察觉之前完成。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
落地建议:把 NPC 决策做成一次请求里的多个 Choice——一次调用同时判断"意图""情绪""是否越界",然后代码按优先级选动作。
要注意:延迟敏感的场景不要把 state 塞大。先在代码里把相关上下文(角色状态、背包、附近实体)精简成结构化字段。
四、数据分析与文档处理
这一类不追求实时,追求的是便宜到可以全量跑。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
落地建议:两类最划算的用法是RAG 段落过滤和引用核查。它们都能直接省钱——前者减少送进生成模型的噪声 token,后者把"幻觉核查"从人工抽查变成全量检查。
要注意:长文档不要整篇发过去。先在代码里检索/切分,只发相关段落。我们自己的实测里,抽年份时把 1900–2050 全表列成选项,token 要 179,103;改成只列文中出现过的年份,降到 60,576。
从想法到流程:五步法
不管你在哪个行业,路径是一样的:
- 写下那个"需要人看一眼才能决定"的环节。
不是"哪里能用 AI",是"哪里的人在做重复判断"。 - 把它拆成几个一眼能回答的小问题。
判断标准:一个懂行的人扫一眼就能给出答案。 - 在 Playground 里用几条真实样本试问法。
这一步不要写代码,先把问题问对。 - 收集一两百条带标签的样本,定置信度阈值。
历史数据往往就是现成的标签。 - 上线时把低置信度样本路由给人工,并持续回收标注。
第 3 步和第 4 步之间不要跳。 我们见过太多人直接跳到写代码,然后在生产里发现"准确率不够"——其实是他从来没拿真数据测过问法。
最后:算一下你的账
注册送的 ¥5 约等于 1.19 亿输入 token。按每个请求 500 输入 token 算,大约是 23 万次调用。
这个数字的意思是:验证一个场景够不够用,不需要走采购流程。 先用免费额度跑你最大的一批真实数据,看准确率、看置信度分布、看人工队列的规模。
要真的跑起来,通常只差三件事:
-
把 state 里该有的上下文准备好(结构化,别塞整篇文档); -
把问题写好(原子、带边界、给退路选项); -
把阈值定下来(用你自己的数据分桶)。
这三件事做完,你就有一个能嵌在代码里、随时可调的判断组件了。
系列到这里告一段落。 八篇下来,一句话收尾:
大模型已经很会写了。现在缺的是让代码随时能问、随时能答的那种判断。
象信就是那个数据库。
后续文章:象信 2.0 与 TypeSafe Jev 的对比测试正在测量,完成后会公布结果和测试方法。
动手入口
-
领免费额度(注册送 ¥5):console.xiangxinai.cn -
按行业找场景:应用场景 -
八大实战手册:cookbooks -
常见架构模式:patterns -
加入交流群:社区与支持
说明:各行业示例为思路参考,不代表效果承诺;上线前请用你自己逐条标注的数据评估准确率并确定阈值。价格与赠送规则以官网当前公布为准。