


手机、PC、工业设备都在运行 AI,但同一个模型部署到不同硬件上,开发者仍然要反复处理驱动、图形接口、算子兼容与内存开销。端侧 AI 的真正难题,正在从“有没有算力”,转向“能不能高效、稳定地用好不同设备上的算力”。
2026 年 10 月 8 日,Google AI Edge 团队正式开源 ML Drift。这是一套面向端侧 AI/机器学习推理的 GPU 计算引擎,采用 Apache 2.0 许可证;它既是 LiteRT 新一代 GPU 加速能力的重要组成部分,也可以通过独立 C++ 库集成到其他推理系统中。
值得关注的不是 Google 又发布了一个推理框架,而是它试图把分散在多种 GPU API 下的推理能力,收敛为更统一的工程基础。
一、为什么端侧 AI 需要 ML Drift?
过去的 TensorFlow Lite GPU Delegate 主要面对移动端的图像分类、目标检测等模型。而今天,端侧负载已经扩展到实时视频特效、深度估计、图像处理、多模态理解与生成式 AI。模型更复杂,内存压力更大,端侧设备的 GPU 类型却仍然高度分散。
Android、iOS、浏览器及桌面系统分别使用 OpenCL、OpenGL ES、Metal、WebGPU 等计算接口。一个模型能在某台设备上跑起来,并不代表它能在另一类 GPU 上获得同等速度。软件团队不仅要维护模型,还要维护不同后端的计算实现。
ML Drift 针对的是这层基础设施问题:将计算图、算子和内存管理尽可能抽象为统一的表示,再由具体 GPU 后端处理设备差异。它支持 OpenCL、OpenGL ES 3.1+、Metal 和 WebGPU(包括通过 Dawn 在桌面系统上运行)。

图1|ML Drift 的核心定位:统一 GPU 推理软件层,而不是直接管理所有 CPU、NPU 与 GPU 的“万能调度器”。
二、它在技术架构上做了哪些改变?
1. 张量虚拟化:把“模型中的数据”与“显存如何存储”分离
传统 GPU 推理实现,经常要为不同 API 分别维护数据布局和 Shader。ML Drift 引入 Tensor Virtualization(张量虚拟化),将逻辑张量与底层纹理、缓冲区等物理存储解耦,利用动态生成的计算内核完成地址与坐标映射。
这项改变看似偏底层,却直接影响后续的移植成本:新模型的算子不必从头为每种 GPU 接口重复实现。与此同时,统一表示并不意味着硬件差异消失,性能仍取决于具体驱动、算子实现和设备特性。
2. 统一计算语言:让 GPU 算子更容易跨平台
开源仓库中,GpuModel 是不依赖具体后端的计算图表示;GpuOperation 则表达单个计算步骤。配套的 UCL(Unified Compute Language,统一计算语言)为编写计算内核提供跨 API 抽象,再针对 OpenCL、Metal、WebGPU 等后端生成适配代码。
Google 还提供可扩展的自定义算子接口,甚至在仓库中加入面向编程智能体的 SKILL.md 指南,用来辅助开发者编写、注册和验证自定义 Shader。这不仅面向既有算子,也为新模型结构提供了扩展空间。
3. 五维张量:为时空与空间模型补齐基础能力
旧版 TFLite GPU Delegate 在张量维度方面存在结构性限制。ML Drift 将五维张量纳入框架能力,使部分三维卷积、体数据与时空相关模型不必依赖额外的数据布局变通。
这对视频理解、空间视觉与具身智能研究具有潜在价值,但也要避免过度解读:五维张量支持是一项推理基础能力,并不等于“已完整支持世界模型”,更不能直接推导为复杂 VLA 模型都可以无缝部署。
4. 面向大语言模型:不再用同一套方式处理所有推理阶段
自回归大模型的 Prefill(提示词预填充)与 Decode(逐词生成)具有不同的计算特征。前者通常更偏并行计算,后者常受到内存带宽、权重访问及 KV Cache 读写的限制。
ML Drift 会根据阶段切换计算内核与数据布局,并优化 KV Cache 布局、量化及不必要的内存往返。这代表 GPU 推理引擎正在从“逐算子加速”,走向对模型执行过程的整体优化。
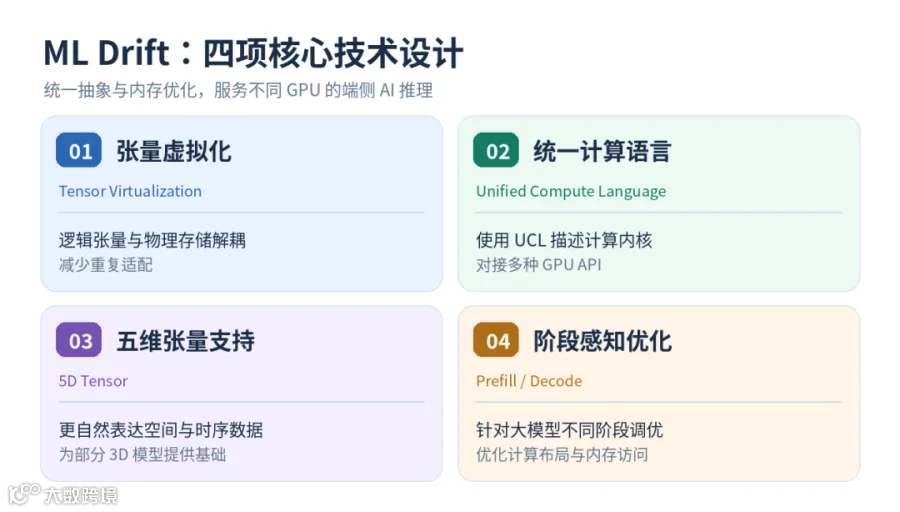
图2|ML Drift 的四项核心技术:统一抽象、跨平台计算、时空数据和大模型阶段感知优化。
三、实际效果如何?Google 已经给出了产品级案例
这次开源不是从零开始的实验项目。Google 在公告中表示,ML Drift 已用于 Chrome、YouTube Shorts、Google Photos、Google Meet 等产品及 Google AI Edge 的应用。
例如,YouTube Shorts 在部分分割特效中,迁移后平均帧延迟最高降低 40%;Google Photos 的部分计算摄影流程,相比旧 GPU Delegate 最多缩短约 2 秒;Adobe Lightroom、Photoshop 的部分移动端 AI 功能提速最高 30%,Snap 在相关特效模型上报告约 30% 的模型延迟改善。
这些数字都来自不同产品、设备与任务,不能简单相加,也不能理解为“所有模型统一快 30%~40%”。真正值得注意的是:统一的底层引擎已经能够服务真实的大规模端侧应用。
四、大模型测试:数据亮眼,也应该看清比较条件
Google 同时公布了桌面端初步基准。在 Windows、Intel Core Ultra 358H(Panther Lake)平台上,针对 4-bit Gemma 4 12B 模型,ML Drift(OpenCL)的 Prefill 吞吐为 491 tok/s,Decode 为 12.2 tok/s;对照的 llama.cpp(Vulkan)分别为 280 tok/s 与 9.73 tok/s。
同一测试中,ML Drift 的内存占用为 7.89 GB,llama.cpp 为 8.50 GB。Google 还披露,在部分 Gemma 基准中,其内存开销最高可降低约 12%。不过,并非所有模型、所有平台的结果都呈现同一方向的优势。
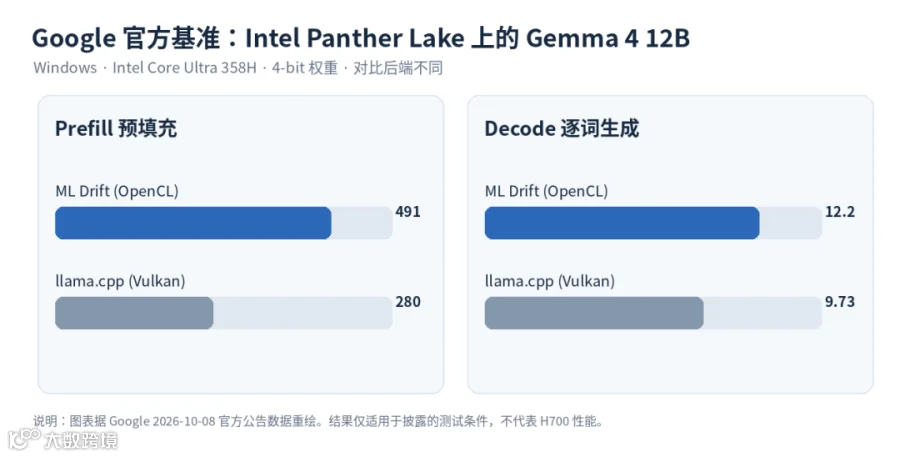
图3|根据 Google 官方数据重绘:Intel Panther Lake 358H 上的 Gemma 4 12B 测试
这里至少需要保留三个前提:一是不同推理框架使用的 GPU API 并不相同,结果不能完全归因于 ML Drift 的架构本身;二是测试涉及模型版本、量化方式、上下文长度与执行参数;三是 Google 将桌面场景描述为早期展示,其首要工程方向仍然是移动和端侧设备。
换句话说,ML Drift 很值得跟踪,但不宜据此宣布它在所有设备上都取代了现有的 CUDA、TensorRT、llama.cpp 或 MLX 方案。
五、为什么这次开源对整个端侧 AI 生态重要?
第一个变化,是模型开发与部署之间的距离有望缩短。底层 GPU 差异由框架尽量吸收后,应用开发者可以把更多精力放在模型和产品本身;GPU 与系统工程师仍可通过自定义算子深入优化。
第二个变化,是手机、浏览器与桌面端的推理路径正在靠近。ML Drift 利用 Dawn 将 WebGPU 实现延伸到 Windows、Linux 等原生环境,让同一套计算代码有机会服务更广泛的设备。
第三个变化,是端侧大模型正在形成自己的推理技术路线。与数据中心追求大规模并发和集群吞吐不同,端侧更关心内存占用、交互延迟、能耗、隐私保护以及离线可用性。Google 现在正把这些要求纳入 GPU 推理引擎的基础设计。
Google 同时宣布,旧版 TFLite GPU Delegate 将不再获得新的功能更新,并建议开发者迁移到 LiteRT ML Drift GPU 加速方案。对依赖 TensorFlow Lite 的开发团队而言,这也是一项明确的生态信号。
六、顺带看 H700:混合推理平台如何借鉴 ML Drift?
对于工业端侧 AI 设备,ML Drift 的启发并不是“一套框架接管所有芯片”,而是让不同计算资源承担更合适的任务。以搭载 Intel Core Ultra 7 255H 和 NVIDIA RTX 4090 Laptop 16GB 的 H700 配置为例,系统同时具有 CPU、Intel Arc 140T 核显、Intel AI Boost NPU 与 NVIDIA 独显。
基于 Google LiteRT 与 ML Drift 的跨平台推理能力,H700 有机会通过更加统一的软件栈,利用 Intel 核显、NPU 和 NVIDIA 独显,实现端侧 AI 的混合计算与按需加速,降低工业 AI 应用的模型部署和硬件适配复杂度。

下一步,我们将会先在 H700 的 Intel Arc 140T 上完成 ML Drift 可用性与性能验证,再和 OpenVINO GPU 路径比较延迟、吞吐、内存占用与功耗。Google 在 Panther Lake 上公布的数字,并不能直接套用到 H700 的 Arrow Lake-H 平台。
结语:下一轮竞争,可能不仅是芯片性能之争
当端侧设备开始同时运行视觉、语音、生成式模型与智能体,单独比较一块 GPU 的理论算力,已经不足以回答应用能否稳定、高效落地。软件栈是否跨平台、是否容易扩展、能否降低内存开销、能否和其他计算单元协同,都会越来越重要。
ML Drift 的真正意义,是把端侧 GPU 推理从繁琐的后端适配,进一步推向可复用、可优化的统一基础设施。
它尚未解决端侧 AI 的所有问题,但这次开源清晰地展示了 Google 对下一代端侧推理软件栈的判断。对于工业 AI 与端侧物理 AI 平台,同样值得认真研究。
参考资料
-
Google Developers Blog(2026-10-08):ML Drift: Next-Gen GPU AI/ML Inference at the Edge
https://developers.googleblog.com/ml-drift-next-gen-gpu-aiml-inference-at-the-edge/ -
Google AI Edge GitHub:ML Drift(Apache 2.0)
https://github.com/google-ai-edge/ml-drift -
Google AI Edge:LiteRT GPU Acceleration
https://developers.google.com/edge/litert/next/gpu -
Intel:Core Ultra 7 255H 产品规格
https://www.intel.com/content/www/us/en/products/sku/241751/intel-core-ultra-7-processor-255h-24m-cache-up-to-5-10-ghz/specifications.html -
Google AI Edge:Intel NPU (OpenVINO) with LiteRT
https://developers.google.com/edge/litert/next/intel