德国,下午两点十四分。
一节直播课刚开场几分钟,一个叫「明夏」的学员抛出了问题。他在国内一家快消企业做需求预测,人在德国,负责巧克力和饼干品类的供应链。
问题很长,也很硬:怎么从历史销售里,把「促销带来的增量」和「自然该卖的基线」干净地剥开?每次促销的折扣、陈列位置、时长都不一样,能不能做「弹性建模」?还有,怎么量化一次促销对别的产品造成的蚕食?
BI佐罗听完后,停了一下。
「你问的这个问题,非常之专业。」
就这一停,课上的气氛变了。这不是客套。在快消行业,需求预测的基线拆解(Base-Promo Decomposition)和促销蚕食效应的量化,是数据分析里最硬的几块骨头之一。能一口气道出这些问题,说明提问的人真在一线扛事。

为什么难?快消的节奏快、SKU 多、周转猛。明夏手里的数据量级是:日级、SKU 级,几百个 SKU、上万家门店、五年历史——百亿级别。
更难的是,这个问题藏在利润表的背面。
明夏自己算过一笔账:需求预测准确率每提升 1%,对企业意味着上千万到上亿的降本或增收。而他问的这套方法如果能跑通、推到全公司,他说「上亿是绝对的」。
一开口就是上亿的问题。这恰恰是 CFO 和实控人该盯的那种问题——它不直接写在报表上,但每错一次,真金白银就漏一次。
你以为促销带来了增长,其实只是把自家产品的销量从左口袋挪到右口袋。
那 BI佐罗 怎么拆?
先立一个最朴素的公式:
总销售 = 基线销量 + 促销增量 + 噪声
基线,是不做任何促销时,产品「自然该卖的量」,受品牌力、产品趋势、季节性驱动。促销增量,是为了做促销而多卖的那部分。
痛点就在中间:两者混在一起,分不开。你分不清一场促销到底带来多少真实增量,自然也就算不清促销活动的真实 ROI。
方法上,行业里已经走了三代:
第一代 | 经典统计分解比如 STL,把时间序列拆成趋势、季节、残差,再手动把促销期剥离出去。
第二代 | 回归建模现在的主流。把促销特征当自变量,用多元线性回归、混合效应模型、动态回归来建模。
第三代 | 因果推断用梯度提升、双重机器学习、合成控制、Meta Learner 这类方法。结合明夏要的「弹性建模」——每次促销强度不同,模型得能处理不同的折扣率、陈列位置、时长——这是既务实又前沿的一条路。
真正让很多企业算错账的,是蚕食效应。大多数人只看到一种,其实有三种。
① 同品牌内蚕食你给某款黑巧打七折,销量涨了,可增量里有一部分是原本要买你家牛奶巧克力的顾客,换个口味而已。
② 跨品类蚕食饼干促销,抢了同一消费场景里膨化食品的预算——同一个购物场景,预算是共享的。
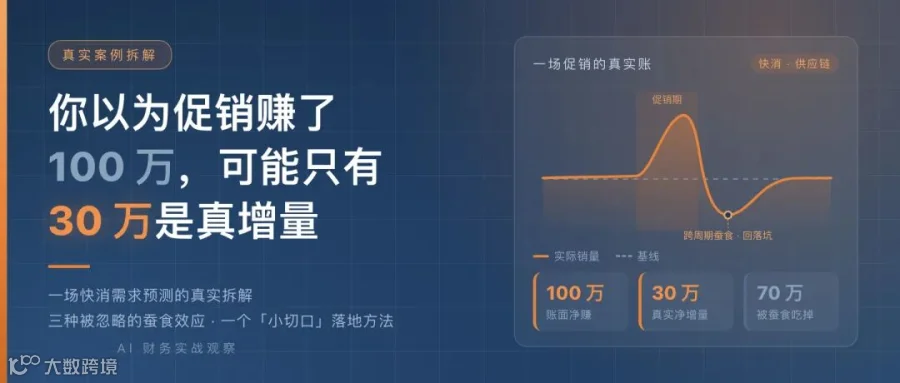
③ 跨周期蚕食(囤货效应)消费者一看打折,一口气囤了三个月的量。促销期暴涨,促销后两到三周暴跌。这不是需求来了,是「未来的自己,蚕食了现在的自己」。
忽略蚕食,会严重高估促销 ROI。你以为一场促销净赚 100 万,把被你自己打下去的自家销量也算进去了,真实增量可能只有 30 万。
很多企业的促销预算,就是这么悄悄漏掉的。他们从不测算蚕食,于是每一场「看起来很成功」的促销,都在用自家的钱,买自家的销量。CFO 手里那张促销 ROI 报表,数字越漂亮,水分往往越重。
这也解释了为什么需求预测准确率每提升 1%,对企业就是上千万到上亿的量级——把账算对,省下的就是纯利。
回到明夏的数据。要把这个模型建起来,需要什么?
销售数据要日级、SKU 级;促销字段要全——折扣率、陈列方式、促销日历、海报/买赠/满减、每个 SKU 的实际售价和原价;辅助数据要有天气、节假日标记。竞品促销数据缺失?行业常态,不是致命缺陷。门店客流没有?遗憾,但也不是必须。现有工具是 SAP 和 Power BI。
数据齐了,下一个问题来了:百亿级的数据,怎么跑?
BI佐罗 给了一招,叫「小切口」。
小切口 · 抽样方案
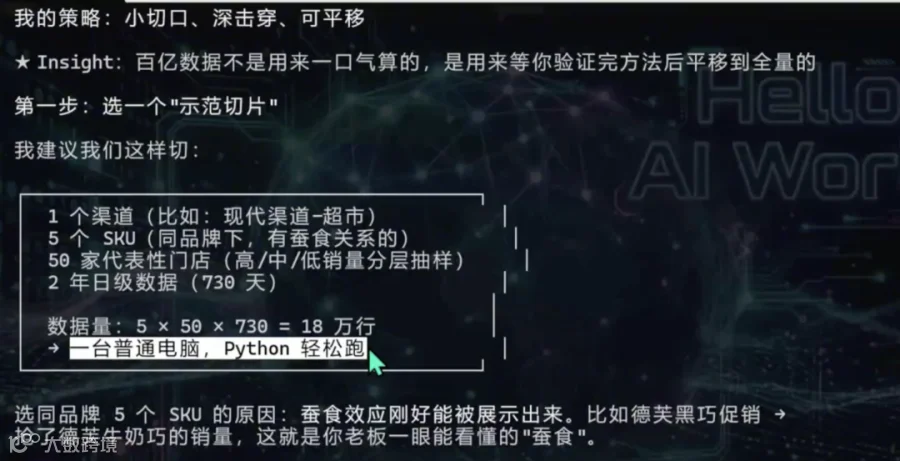
不憋着一口气算全量。先选一个渠道(现代渠道超市),挑 5 个同品牌、有蚕食关系的 SKU,抽 50 家代表门店(高、中、低销量分层抽样),取两年日级数据——大约 18 万行。
一台普通电脑,用 Python 就能跑。
百亿级的难题,瞬间被化解成一个 18 万行的经典问题。这背后的思维,就是「拆解」:把复杂问题拆成可落地的局部,验证有效了,再平移到全量。底层用的其实是「分层聚合 + 参数共享」的策略——不同 SKU、不同门店,各有各的模型,但又共享一部分参数,既保精度,又控成本。
然后,最精彩的部分来了。
AI 没有直接丢给你一段代码,而是当场生成了一个可交互的 HTML 分析看板。明夏和老板坐在屏幕前,能沉浸式地看见结果——BI佐罗 当时还俏皮地跟 AI 说了一句:「老板在旁边看着呢,你一定要来一个好的效果哦。」
这个「样板」,长这样:
样板看板 · 八个模块
01 两年销售总览:基线、促销增量、蚕食量、净增量,一眼看清。
02 5 个 SKU 的日趋势线:基线、实际销量、促销增量叠在一起看。
03 折扣深度 vs 增量回报率(ROI):花多大折扣,换回多少增量。
04 促销增量 + 蚕食损失 vs 净增量:按活动逐场拆解。
05 同品牌蚕食热力图:一张 5×5 的交叉弹性矩阵,谁抢了谁,清清楚楚。
06 跨周期蚕食的「回落坑」:促销后那两到三周的暴跌,被画了出来。
07 What-if 模拟:你输入折扣深度和活动时长,它直接预测毛利增量、蚕食损失、跨周期回落和净增量。
08 甚至可以加登录、按部门或标签设权限——相当于自己搭了一个 Power BI 门户,但不用等 IT。
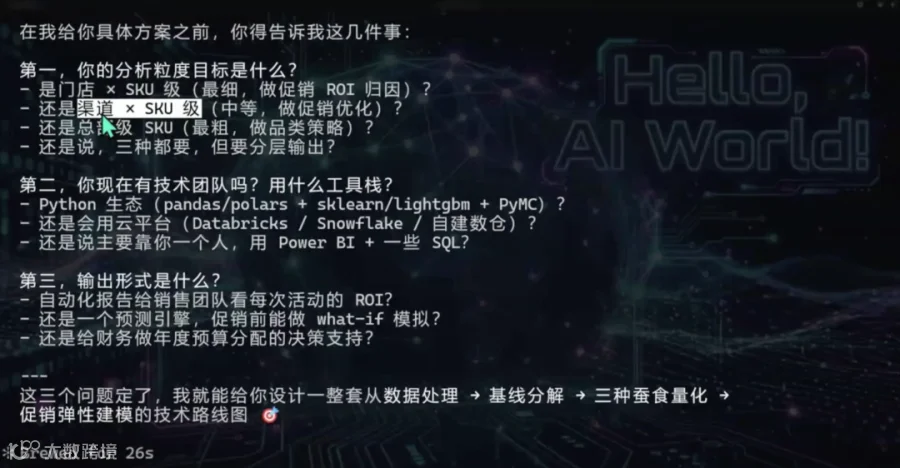
注意一个细节:99% 的人让 AI 干活,是甩一句话就开始。那 AI 永远很难干到你想要的那个点。BI佐罗 和明夏前后聊了几十条,把问题、数据、目标、输出形态全部对齐,AI 才动手。
沟通的质量,决定了产出的质量。

CFO 最关心的那件事,这堂课也正面回答了:把敏感数据交给 AI,安全吗?
整个过程中,明夏没有给 AI 任何一条真实数据。BI佐罗 让 AI 先模拟生成一份「具有典型特征」的数据——周末高峰、春节、情人节脉冲——把模板和看板先做出来。模板验证好了,真实数据直接套上去。
数据不出内网,不开放到公网,攻击都打不到你。安全,是设计出来的,不是碰运气。
讲完技术,我想说这堂课最贵的地方。
明夏之前在 Gemini 上问过同样的问题,对方给了几个模型方向,但「没法给我建模」。区别在哪?BI佐罗 用的不是「聊天」,而是通用智能体(Claude Code),它能在你的电脑上直接干活,而不是只陪你聊。
但更底层的一招,是提问的方式。BI佐罗 在课上反复强调一个原则:只谈需求,不谈方法。
你越在 AI 面前假装懂、越急着指定技术方向,AI 越容易顺着你的思维惯性走,最后只会说「你说得对」。
反过来,用大白话把问题甩出去——「我不知道我在说什么,但我觉得你知道我在说什么,你告诉我我在说什么,再告诉我我还该补充什么」——反而能把 AI 撬动起来,帮你做结构化梳理。这不是偷懒,是把「定义问题」这件事,交还给更擅长结构化思考的一方。
从「聊天」到「落地」到「产品化」,每个人都是产品经理。明夏后面顺带问的权限管理、置信区间展示,本质上都不再是数据分析问题,而是产品需求——他要的其实是一套软件,不是一张表。
成本呢?这个「价值上亿」的问题,当场跑了 12 分钟,token 消耗大约 2.6 元。
市面上有很多「行业专用智能体」,但 BI佐罗 在课上亮了一个判断:最强的,是通用智能体。
钉钉负责人有过一句公开判断——「软件时代结束了」,软件正在变成按需即时生成,不再需要 IT。明夏要的那套东西,本质上是一套软件,而 AI 当场就生成了。
这也正是这门课和「只教工具操作」的 AI 课最大的不同。它教的不是某个按钮在哪,而是三件事的组合:思维(怎么把问题拆对)、通用智能体(怎么让 AI 真正接手干活)、可复用系统(怎么把一次性的结果,沉淀成能反复用的资产)。
AI 能很快给你结果。但结果准不准、数据安全不安全、能不能稳定复用,依然需要专业的人来设计和判断。
这,才是真正的差距开始的地方。
如果你也面对着类似「算不清、跑不动、不敢给数据」的难题,这门课也许值得你花两天看看。
课程信息
《AI 智能体实战训练营》
BI佐罗(连续 8 年微软数据技术 MVP,10 年以上企业数字化实践,16 万+ 学员,100+ 企业培训经验)与优贲联合呈现。
两天线下实战:
DAY1 让 AI 真正接手你的日常工作
DAY2 把你的工作方法沉淀成一套 AI 系统
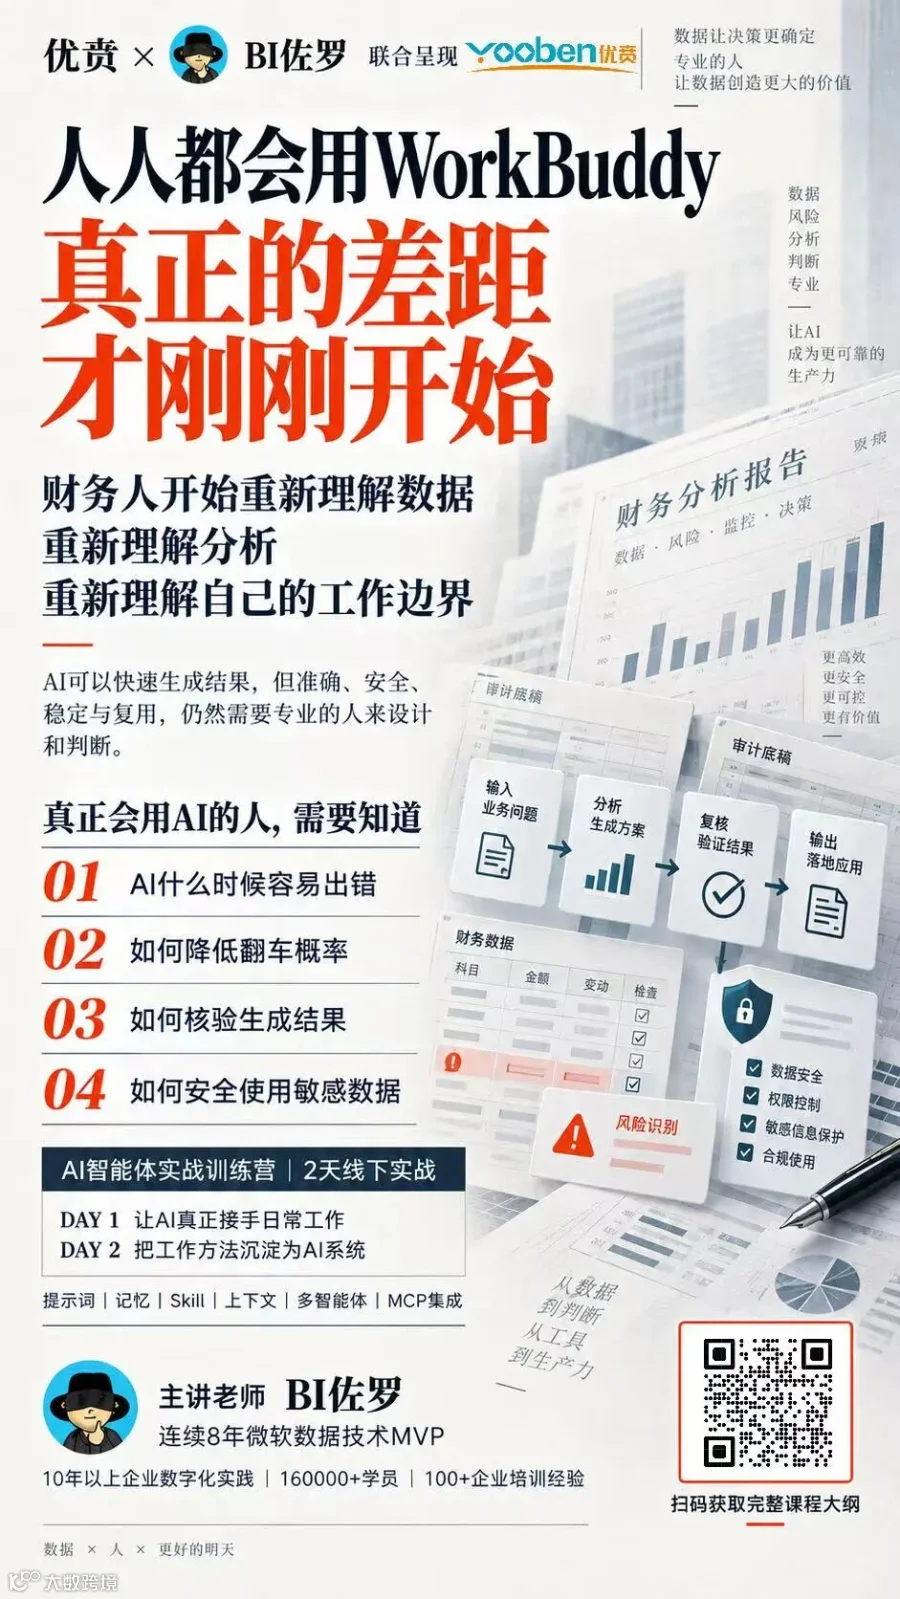
真正会用 AI 的人,需要知道四件事:AI 什么时候容易出错、怎么降低翻车概率、怎么核验生成结果、怎么安全使用敏感数据。这门课,就是冲着这四件事去的。
扫码获取完整课程大纲,可直接领取试听课程片段
下期上海线下培训时间安排是 11 月 14–15 日,有兴趣的同学欢迎扫码咨询。

下期上海线下培训时间安排是 11 月 14–15 日,有兴趣的同学欢迎扫码咨询。