

⭐ 设为星标 · 第一时间收到推送
换个对话,还知道你要什么吗
北京时间10月13日01:02:20,Meta研究团队正式公告了Muse Wonder系列。Wonder已经进入API和Muse Code,能力更高的Full也已开放,但访问条件更窄。
我们没有独立运行这两款模型。功能描述来自Meta,体验反馈来自公开原帖。
Meta把跨会话记忆能力称为 Active Memory:把有关你的重要背景带到后续对话里,并在当前任务需要时,主动调取相关细节。
拿旅行做个假设:你之前说过预算、饮食禁忌和不想早起,后来请它安排一天的行程。Active Memory的目标,就是在做新计划时用上这些限制,省掉重复交代。
官方用MemoryBench测试记忆:在64K到100K token的长对话里,加入干扰内容、冲突信息和后续更新,再检查模型能否找回关键事实。下面是Meta公布的内部测试结果。

能跨会话利用背景,不等于永久不会忘。 这套测试也不能直接证明几年后的记忆效果。具体产品如何保存、更新、删除记忆,能读取哪些个人资料,还要看产品设计和用户授权。
任务卡住后,还能接着干吗
Active Focus说的是持续推进任务:尝试别的办法,处理障碍,并根据新信息调整行动。
写一个小程序很好理解。生成第一版代码以后,还得运行测试、找出失败原因、改多个文件,再验证结果。Meta表示,两款模型都在多种长任务上接受了训练,希望减少做到一半就停下来的情况。
但官方主文同时写得很清楚:需要时会提问澄清,重要操作前会确认。 持续执行有这个约束,不能理解成模型可以无限行动,或者所有任务都能做成。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
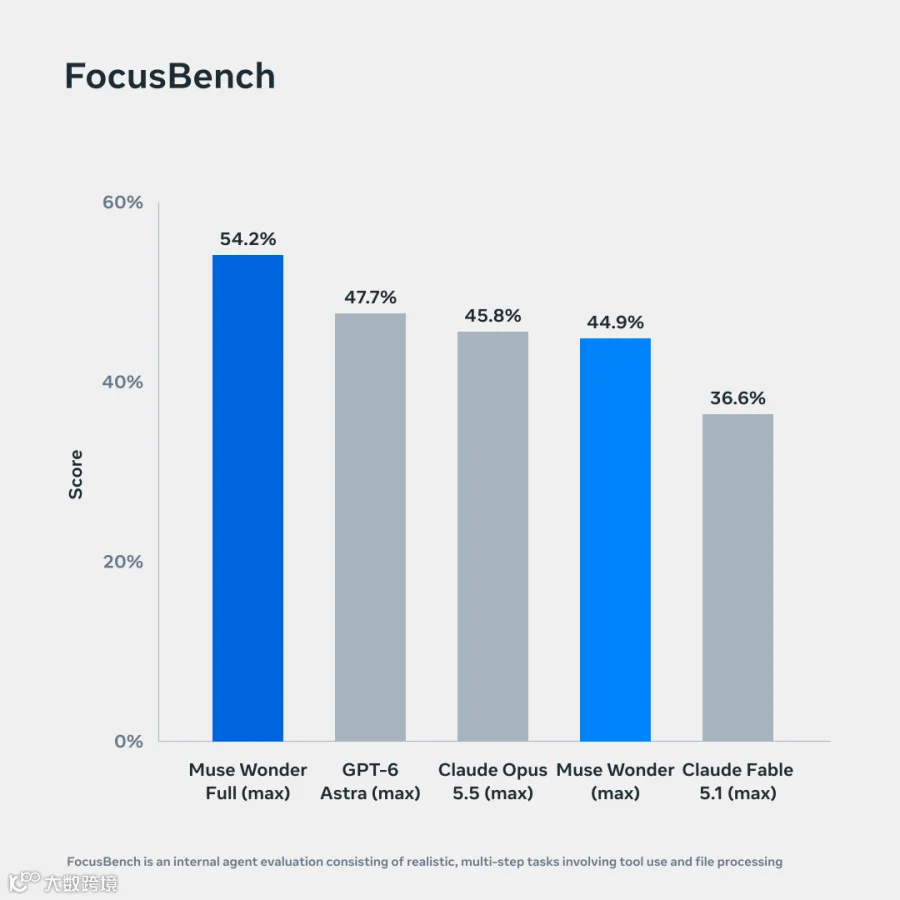
FocusBench是Meta的内部评测,涵盖住房、旅行、IT、金融等任务,重点看环境变化、遇到障碍以后,模型能否继续工作。
实际执行还得有工具和运行环境。模型判断下一步,产品框架提供浏览器、文件、命令执行和任务状态。接通API以后,跨会话资料怎么存、工具怎么接、权限怎么管,仍需要应用来安排。
Wonder、Full和三个入口,分开看
截至北京时间10月13日,官方公告和开发者文档给出的开放范围如下。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
这张关系图把模型和使用入口分开,避免把“模型发布”看成“个人App已经全部升级”。
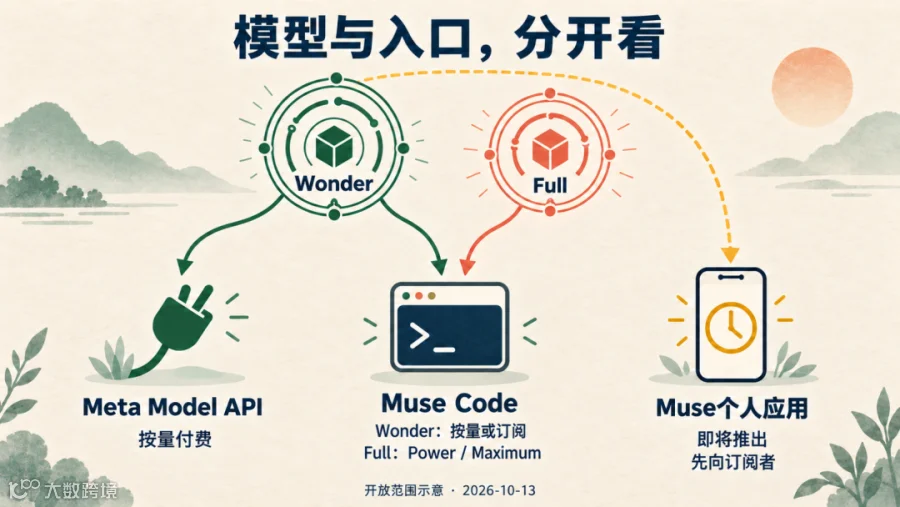
Wonder的API模型ID是 muse-wonder-1.0。按每百万token计,输入4美元、缓存输入0.20美元、输出20美元。长任务会多次调用模型,实际花费要看累计用量,不能把token单价当成一个项目的总价。
Full对应的Muse Code套餐是 Power Usage每月50美元、Maximum Usage每月200美元。官方没有给出Full的独立API token报价;把Wonder的推理档调到 max,也不会变成Full。
开发者入口:https://dev.meta.ai/
还有一个与资料授权有关的设置:官方文档说,Standard模式下,发送的内容不用于训练Meta模型;Muse Code订阅者默认启用Contributor模式,用允许训练来换更多用量,可以在设置中关闭。
具体模型、套餐和数据模式见:https://dev.meta.ai/docs/models
想自己搭Agent,可以从Wonder API开始;想在代码项目里直接用成套工具,可以看Muse Code。个人App里的Wonder还要等上线,不能把订阅Code理解成个人App已经能用。
订阅需要Meta Account,官方注明权益与可用性可能因地区而异。中国大陆账号能否注册、支付和接通,这次没有实测。
看跑分,也要看它怎么测
Meta已经发布了13页模型卡,列出了规格、评测方法和局限。PSI是内部综合指标,MemoryBench、FocusBench也是内部评测;它们不是一个统一的第三方总榜。
SWE-Marathon则引用Abundant AI报告的结果。其中GPT-6 Astra跑在Codex里,Claude Fable 5.1跑在Claude Code里,Full使用xhigh推理档。模型卡明确说明,这一行不是同一个Agent框架下的受控比较,不能据此推导“全面夺冠”。
模型卡这页说明了各项编程评测的来源、产品框架和推理档。

模型卡写明,两款模型接受文本、图片、视频、音频输入,输出是文本。1M token指推理时的上下文长度,不能推导出无限记忆。
官方演示里,根据图片做出可玩的3D厨房游戏,展示的是理解输入、生成游戏代码的流程。Wonder的原生输出不含图片或视频,模型卡还把视觉、空间推理,尤其3D任务,列为已知局限。
早期反馈里,开发者Anshu发帖称,同一提示词下,他更喜欢Astra生成游戏的观感。不过他给两者用了不同推理档,这只是个别体验,不能当成受控评测。额度也出过问题:Alexandr Wang今早称,已修复Wonder系列异常快速消耗额度的问题,并重置Muse Code用量。这个修复结果是Meta方面的说明,我们没有复测。
现有模型卡已经包含风险与安全评估,官方说稍后还会补充更完整的安全报告。Meta承诺稍后开放权重的是Spark。Wonder没有开放权重公告,参数规模也未公开。
真要试它,拿一个需要记住约束、又能检查结果的连续任务。中途改一次需求,核对它有没有用上新信息,再检查交付结果和关键操作前的确认记录。把这些留下来,才好判断它适不适合你的工作。