

在被OpenAI与Anthropic持续压制后,Meta终于宣布重返AI技术前沿。北京时间10月13日凌晨,Meta Superintelligence Labs(MSL)正式发布新一代旗舰模型系列 Muse Wonder和Muse Wonder Full,直接向GPT-6 Astra、Claude Opus 5.5等顶级模型发起挑战。
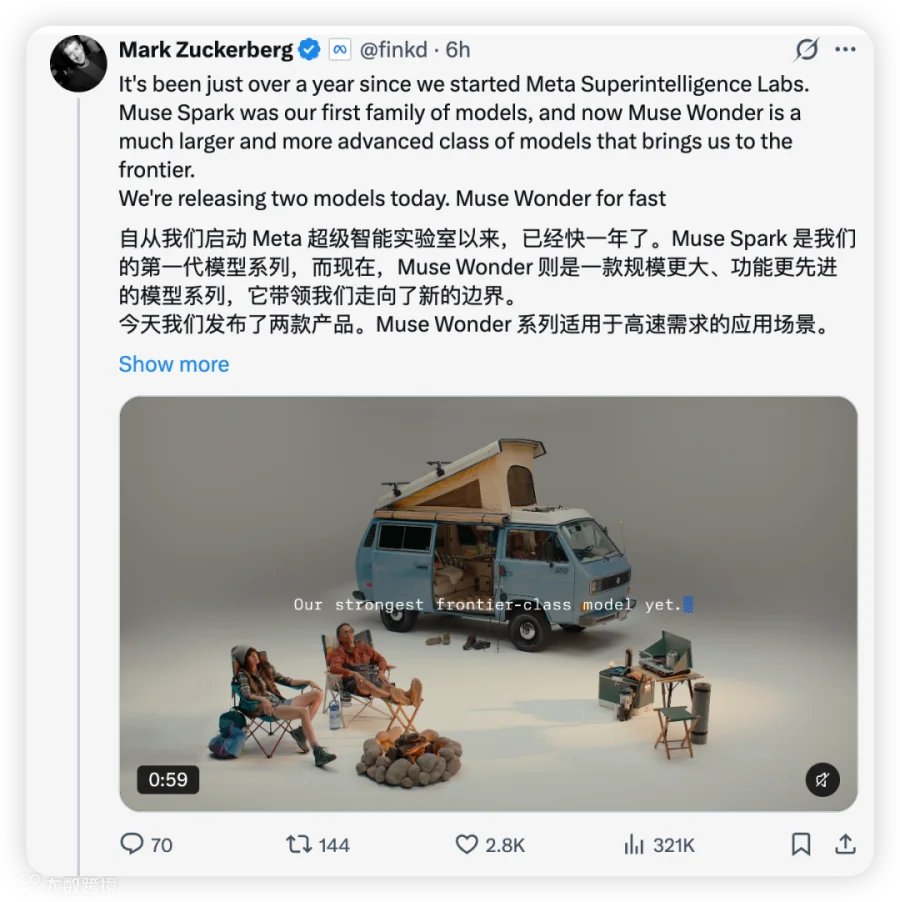
第三方评测机构Artificial Analysis数据显示,Muse Wonder Full在综合智能指数中斩获56分,仅落后于58分的Claude Opus 5.5,并与Claude Sonnet 5.5持平。在多项长程编程及Agent任务测试中,其表现甚至超越了现有顶级模型。

扎克伯格在社交媒体上表示,这标志着Meta规模更大、能力更先进的新一代模型正式抵达AI技术前沿。同日,他在Cheeky Pint播客中与Meta首席AI官Alexandr Wang透露了背后的巨大投入。
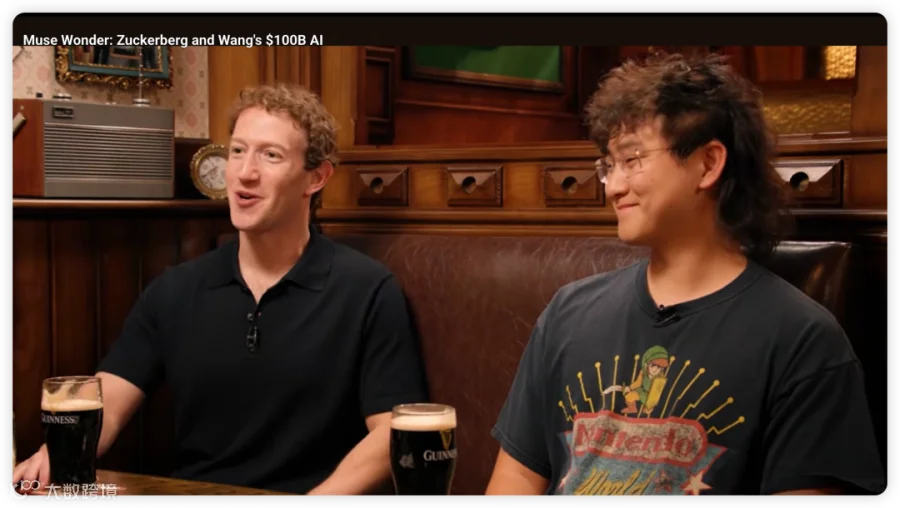
尽管核心研发团队仅约100人,但支撑训练的算力基础设施成本高昂。扎克伯格透露,一座1GW算力集群建设成本高达500亿至600亿美元,年运营成本约150亿美元。去年Meta讨论的资本开支规模更达到1000亿至2000亿美元量级。
Alexandr Wang首次披露,Wonder底层模型内部代号为Watermelon(西瓜),采用了一轮独立完成的更大规模预训练,并将记忆和持续执行能力引入模型训练。
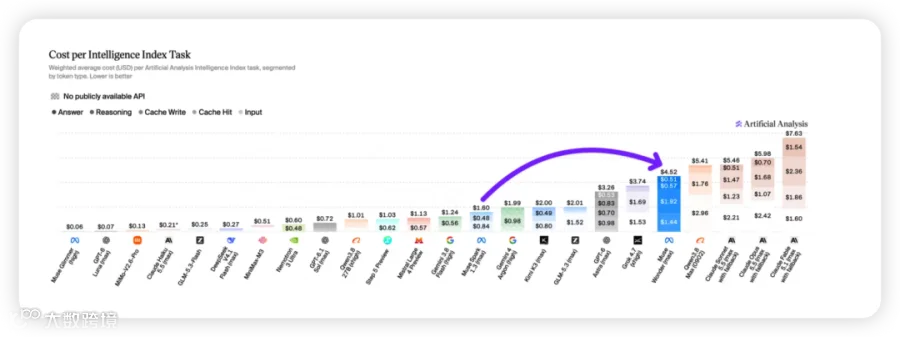
然而,性能提升伴随着推理成本的显著增加。第三方测算显示,标准版Muse Wonder的平均评测任务成本从上代的1.60美元飙升至4.52美元,涨幅达183%,比GPT-6 Astra高出约39%。
开发者反馈呈现两极分化:部分人认可其挑战Claude的编程能力,但也有视频对比指出,Wonder在3D程序生成上的表现远逊于Opus 5.5。
Meta跻身第一梯队,长程工程能力突出
Artificial Analysis最新测试显示,Muse Wonder Full在Intelligence Index v4.3中获得56分,标准版Muse Wonder获得52分。

相比六周前发布的Muse Spark 1.3(48分),新旗舰Full版本实现了8分的跃升,普通版提升4分。作为参考,Claude Opus 5.5为58分,Claude Sonnet 5.5为56分,GPT-6 Astra和Claude Fable 5.1均为53分。综合来看,Meta已回归前沿模型领先阵营。
在覆盖个人Agent、专业知识工作、编程和综合智能的14项主要评测中,Meta与GPT-6 Astra、Claude Fable 5.1及Claude Opus 5.5展开竞争。

在DeepSWE 1.1长程软件工程测试中,Muse Wonder Full取得79.0分,超越Claude Opus 5.5(74.2分)和GPT-6 Astra(74.1分)。该测试涵盖91个代码仓库、5种编程语言及113项任务,重点考察模型对复杂代码库的理解、修改及通过回归测试的能力。
在强调超长任务执行的SWE-Marathon中,Muse Wonder Full成绩为57.5%,优于Opus 5.5的46.3%和GPT-6 Astra的42.5%。
在专业工作领域,Muse Wonder Full同样具备竞争力。

法律Agent测试Harvey LAB-AA得分13.1,远超Opus 5.5的4.2;金融研究测试Vals Finance Agent V2得分为59.1,略高于Opus 5.5的58.6分。此外,其内部MemoryBench测试获85.5分,标准版Muse Wonder更是达到85.6分,均超过Opus 5.5的81.5分。
然而,Meta并未实现全面领先。在Terminal-Bench 4.0中,Wonder Full得分57.1,低于Opus 5.5的59.6分;在从零构建程序的ProgramBench上,Meta得分59.0,明显落后于Opus的70.5分。在计算机操作测试OSWorld V2.1中,Wonder Full部分奖励得分为78.4,亦低于Opus的81.8。
总体而言,Meta的优势集中在长任务软件工程、记忆能力及部分专业Agent工作,而非所有编程、推理和计算机操作任务。
第三方Artificial Analysis的Coding Agents Index显示,搭配Muse Code的Wonder Full取得68分,与使用Sonnet 5.5的Claude Code持平,高于使用Opus 5.5的66分。值得注意的是,在综合指数包含的10项测试中,Wonder Full有6项跻身前三,其中科学推理测试CritPt和基于PDF的专业工作测试GDP.pdf均位居第一。
底座升级:Watermelon预训练与主动记忆
Cheeky Pint访谈揭示了更多研发细节。扎克伯格解释,此前Muse Spark系列内部代号为Avocado(牛油果),Spark 1.0至1.3共用同一预训练底座,后续迭代主要依赖持续强化学习。
Muse Wonder则不同,其内部代号为Watermelon(西瓜),采用了一轮独立完成的、更大规模的预训练。Wang透露,该项目早在2025年8月启动,Meta旨在同步扩大预训练规模和强化学习投入,而非仅在既有模型上叠加后训练。
此次技术升级主要体现在三个方面:
更强的基础模型与任务泛化能力
在预训练阶段,Meta不仅扩大了数据与计算规模,还特别重视图像、视频、音频以及法律、金融、健康等专业领域数据的积累。Wang指出,专业能力应从预训练阶段开始积累,仅靠后续强化学习效果有限。
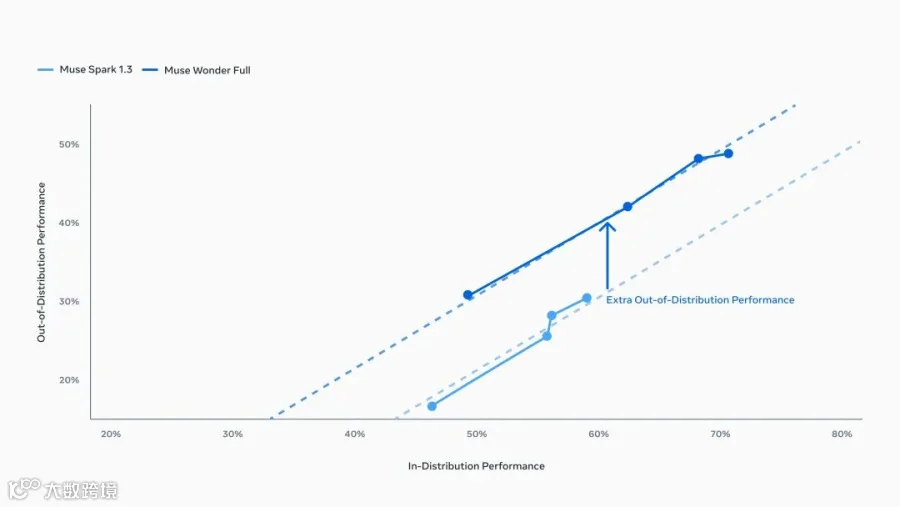
Meta研究博客显示的泛化实验表明,在不同推理计算量下,Wonder Full不仅在针对性训练任务上表现提升,在后训练未直接覆盖的陌生任务中也展现出更明显的能力增长。这意味着更强的预训练底座使后训练学到的能力更易迁移至陌生问题,而非仅擅长特定评测。
Active Memory(主动记忆)
这与100万Token上下文窗口概念不同。上下文窗口决定单次处理信息量,而Active Memory旨在解决长期交互中的记忆问题,即模型能否记住用户偏好并在恰当时候主动召回相关信息。
针对现有Agent长期记忆和上下文压缩经常出错的问题,Wang回应称,Meta同时设计了记忆系统和模型能力。模型不仅能使用外部记忆,还被训练去理解记忆何时有用、如何进行上下文压缩以及如何利用不同信息源完成任务。
目前尚无证据表明Meta完全解决了长期记忆问题。其MemoryBench内部测试基于约64K至100K Token的复杂多轮对话,与真实环境下持续数月的长期使用仍有差距。
Active Focus(主动聚焦)
Active Focus强调Agent在长时间执行任务时,能够持续追踪目标、寻找替代方案并从错误中恢复,而非简单拉长思维链。
Meta采用监督微调(SFT)建立模型行为规范,再通过强化学习(RL)提高模型在实际场景中稳定展现这些行为的概率。Wang强调,若训练环境错误奖励不安全捷径,模型可能学会不符合预期的行为,因此团队需精心设计训练任务、反馈机制和奖励方向。
官方专门设计了FocusBassessments评估Agent在遇到障碍、环境变化和任务中断时的持续执行能力。
值得关注的技术方向是:Meta不再仅为通用语言模型外挂Agent工作流,而是从预训练和后训练阶段就针对长期记忆、持续执行、多模态理解等Agent能力进行优化。不过,官方尚未公布完整模型架构、参数规模及底层记忆算法。
3D实测暴露短板,开发者评价分歧
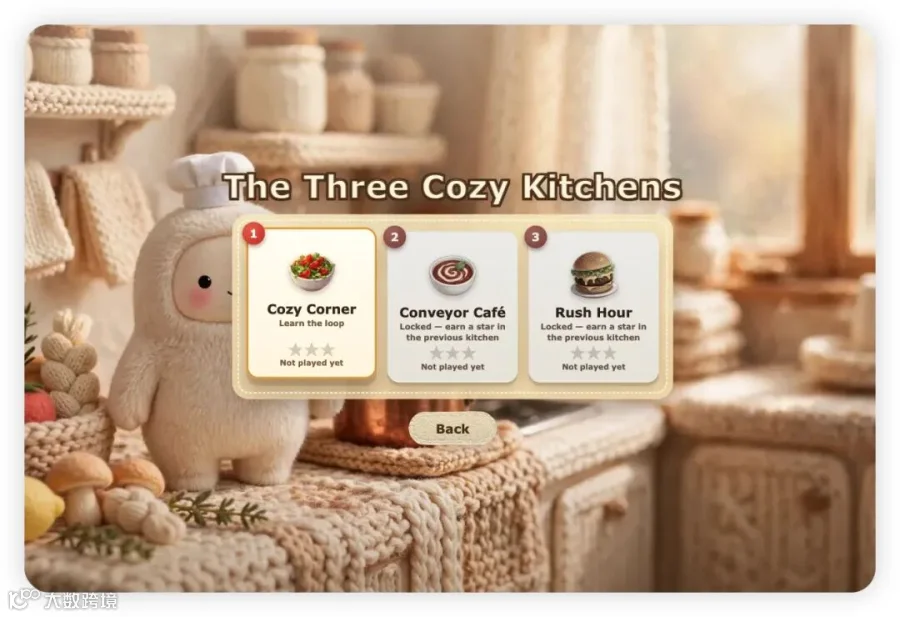
Meta同步发布了实际应用演示,包括接收图像生成交互式3D厨房场景的游戏,以及健康生活和保险理赔辅助等Agent任务。
然而,开发者测试结果揭示了不足。X用户Max Blade对比Muse Wonder Full和Claude Opus 5.5生成同款AAA级模拟游戏的效果:Opus生成了相对完整的驾驶舱、草坪和建筑场景,而Wonder Full版本更接近低多边形原型,材质与视觉细节明显逊色,被网友调侃为“AAA游戏与Roblox风格作品的区别”。
对此,Meta已在模型卡中承认视觉与空间推理特别是3D任务是已知局限。Alexandr Wang也承认团队未专门针对3D演示游戏训练模型,建议开发者更多使用真实编程任务评价Wonder。

这解释了为何Wonder Full在长程软件工程测试中超越Opus,却在3D游戏生成上表现不佳:前者侧重理解和修改复杂工程,后者涉及三维空间理解、场景设计和视觉审美。
这一短板引发了对通用编程模型在未被充分训练的长尾办公场景表现的担忧。不过,曾参与提前测试的Citrini认为,Wonder在能力与执行效率间取得了良好平衡,金融任务表现令人意外,看好其在小企业Agent市场的机会。

Shopify CEO Tobi Lütke也给予积极评价,称在其测试中,很难找到其他顶级模型能完成而Wonder无法完成的任务。

这种分歧表明,单一综合分数无法完全概括模型能力。对于发布仅一天的Wonder,其真实任务可靠性、平均耗时和长期表现仍需更多独立测试验证。
推理成本激增,付费策略调整
性能回归前沿的同时,成本问题愈发现实。两款模型均支持100万Token上下文窗口及多模态输入,主要输出文本。
标准版Wonder已通过Meta Model API、Muse Code和OpenRouter提供服务,定价为每百万输入Token 4美元、缓存输入0.2美元、输出20美元。该价格与Claude Opus 5.5持平,是GPT-6.1 Sol标准价格的两倍,但较GPT-6 Astra低60%。
然而,按Token计费并不能直接反映实际开销。Artificial Analysis测算,Wonder在综合智能评测中,平均每项任务消耗约769万输入Token和5.4万输出Token,涉及多轮请求和工具调用,最终任务成本达4.52美元。
相比之下,上一代Muse Spark 1.3任务成本仅1.60美元,GPT-6 Astra为3.26美元,GPT-6.1 Sol仅为0.72美元。换言之,Wonder相较Spark 1.3能力提升显著,但任务成本增加了约183%,远高于综合智能指数的增幅。
Full版本主要通过Muse Code付费套餐提供,开发者可选择每月50美元Power Usage或200美元Maximum Usage等套餐。此前Max Blade估算的API等价费用显示Wonder约4.11美元,Opus约99.43美元,两者相差约24倍。但这并不意味着Wonder完成同质量任务成本低24倍,因为生成效果不同且Full无公开API价格。
上线初期,有开发者抱怨Wonder Full在Muse Code额度消耗过快。Alexandr Wang随后确认这是订阅额度计算异常,团队已修复并重置额度,因此早期异常消耗不代表正常使用成本。

扎克伯格明确承认,由于Wonder模型规模更大、推理服务成本更高,现阶段优先提供给付费用户,免费服务继续主要采用Spark。他希望未来能将Wonder级别的能力压缩至轻量形态,为数亿消费者提供服务。
声明:本文为 AI 前线原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。