大数跨境

Muse Wonder 建模大翻车,亚历山大·王辩护遭马斯克无情补刀

Muse Wonder 建模大翻车,亚历山大·王辩护遭马斯克无情补刀 AI科技评论
2026-10-13
4
导读:官方承认 3D 短板,跨模型测试 Harness 不同。
官方承认 3D 短板,跨模型测试 Harness 不同。

    作者丨郑佳美

    编辑丨岑   峰


Meta 近期发布的 Muse Wonder 系列模型,因一项 3D 编程测试在开发者社区引发关于 AI 模型评测有效性的热议。
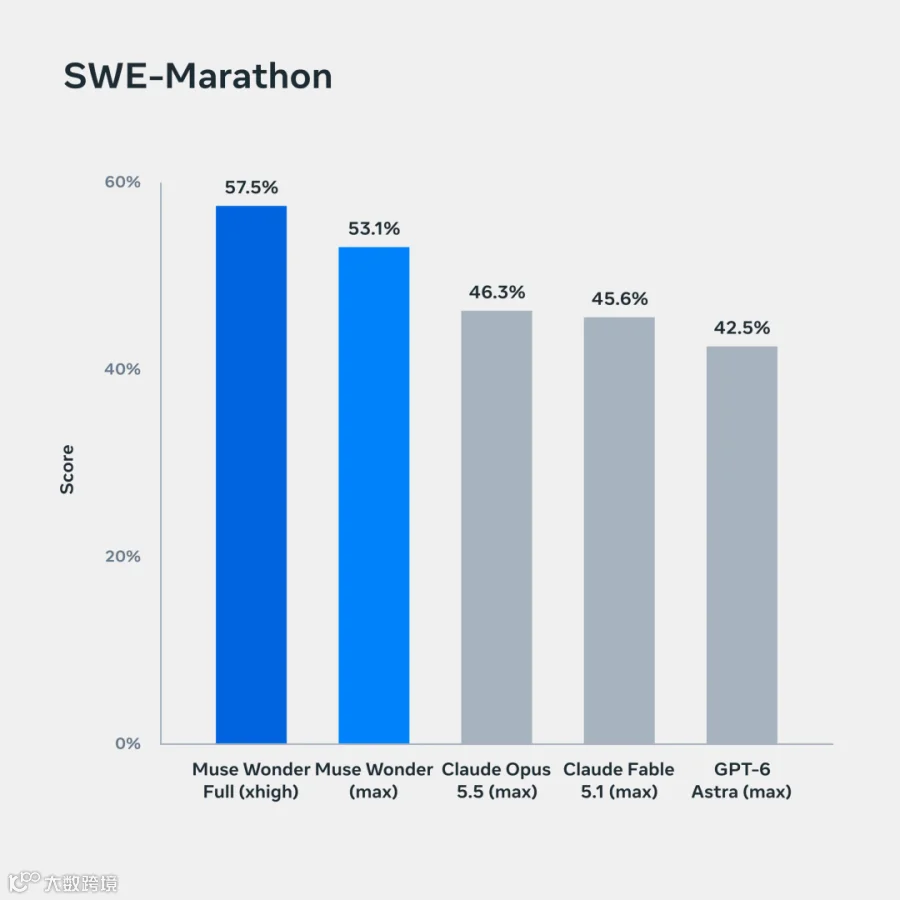
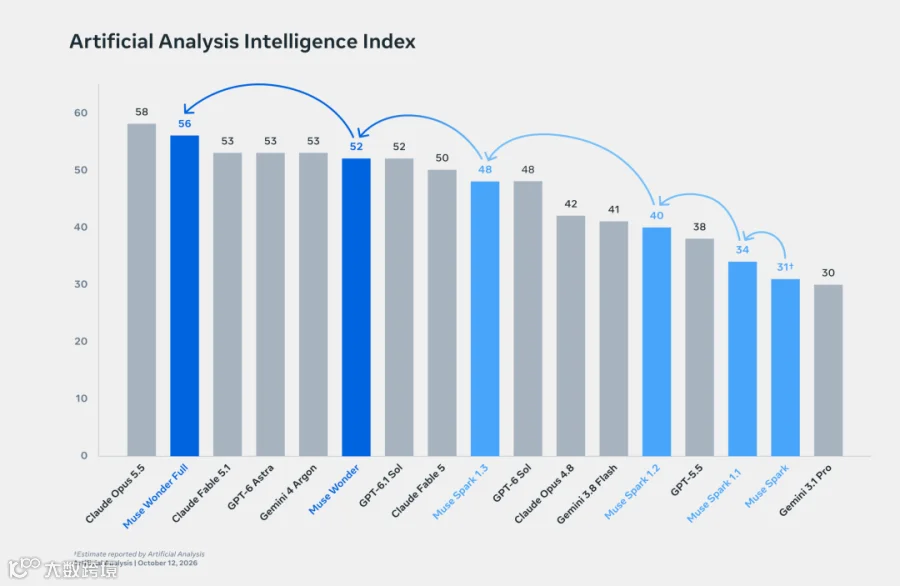
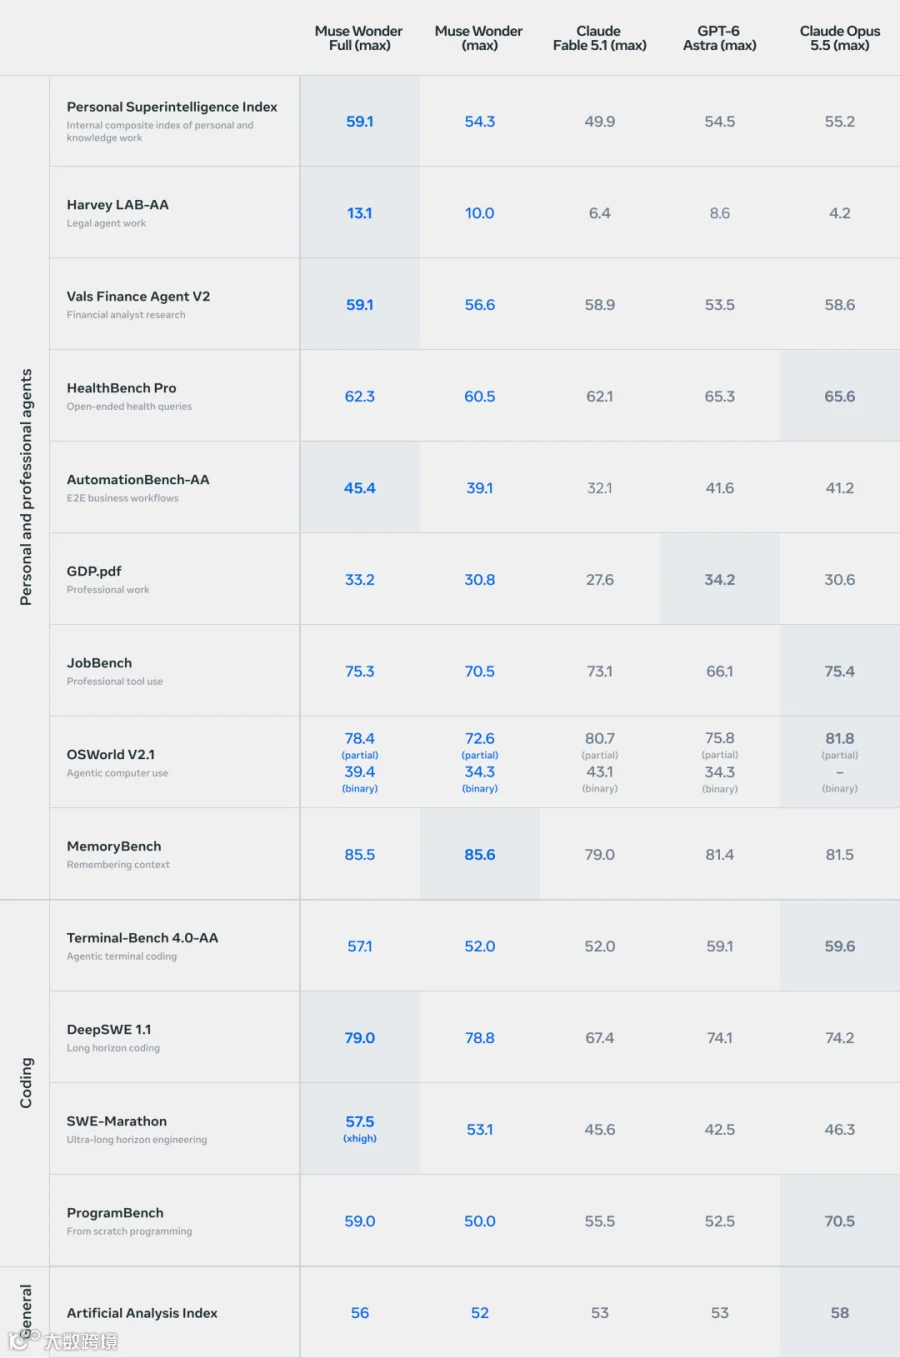
10 月 12 日,Meta 推出 Muse Wonder 及 Muse Wonder Full,重点强化 Coding Agent、工具调用及长任务执行能力。官方数据显示,Wonder Full 在 SWE-Marathon 基准测试中得分为 57.5,DeepSWE 1.1 达到 79.0,具备与前沿模型竞争的实力。
随后,开发者社区 BridgeMind 发起一项 3D 编程挑战,要求模型生成包含透明玻璃外壳、动态熔岩及光照效果的熔岩灯代码。结果显示,Muse Wonder 仅生成了一个简单的红色圆柱体。
BridgeMind 据此质疑 Meta 存在“Benchmaxxing”(针对基准测试过度优化)现象,即模型在标准测试中表现优异,但在陌生任务中暴露短板。这一争议甚至引起了马斯克的关注。
Meta 首席 AI 官 Alexandr Wang 回应称,团队未对 3D 演示游戏进行显式训练,并承认视觉与空间推理是 Muse Wonder 的已知短板。值得注意的是,此次测试针对的是普通版 Muse Wonder,而高分数据主要来自能力更强的 Wonder Full。
尽管存在版本差异,但高分模型在特定陌生任务中的失败,引发了行业对当前大模型训练方法及 Agent Benchmark 反映实际能力程度的深层思考。

01


奖励机制决定模型擅长领域

Muse Wonder 的表现折射出当前大模型依赖 Post-training(后训练)提升任务能力的技术路线。在预训练阶段,模型学习通用知识;而在后训练阶段,通过强化学习塑造其在特定环境下的行为策略。
Coding Agent 的训练依赖于明确的反馈机制,如编译结果和单元测试。模型通过不断试错,学会缩小搜索范围、选择工具及维护任务状态。Meta 引入的 Active Focus 机制进一步增强了模型在受阻时的恢复与推进能力。
然而,熔岩灯任务打破了传统 Coding Agent 熟悉的反馈闭环。该任务涉及三维几何、透明材质、光照计算及动态形变,即使代码能正常运行,视觉效果仍可能错误。编译器和单元测试难以直接判断此类视觉偏差。
这意味着 Agent 需具备视觉反馈机制,通过渲染截图识别偏差并修正代码。单纯增加工具调用或延长推理时间无法替代这一环节。Alexandr Wang 承认缺乏针对 3D 任务的显式训练,表明该领域未获得与核心 Coding 场景同等的资源投入。

02


Agent 高分涵盖模型之外的系统能力

当前的 Agent Benchmark 已不仅是给语言模型出题,而是对整个执行系统的综合考量。以 SWE-Marathon 为例,其考察持续性软件工程任务,完成率受底层模型及 Harness(执行框架)共同影响。
Harness 负责管理工具接口、上下文及异常处理。优秀的 Harness 能自动提取关键报错、压缩无效信息并维护进度,直接影响长任务的稳定性。此外,错误恢复机制和推理预算(Token 消耗、工具调用次数)也是影响成绩的关键变量。
Meta 官方 Model Card 指出,SWE-Marathon 评测中不同模型使用了各自的执行系统(如 Codex、Claude Code),且 Muse Wonder Full 使用了高推理档位。这种配置差异使得横向比较变得复杂:高分可能源于模型推理能力提升,也可能来自执行框架优化或资源投入增加。
对于开发者而言,Agent 处理长任务的稳定性比单轮代码生成质量更具工程价值。因此,评测需提供包括任务完成率、Token 消耗、运行时间及失败恢复情况在内的详细执行信息,以便更准确地评估工程体验。

03


Meta 正视 Benchmaxxing 问题

Meta 在技术文章中专门探讨了泛化能力问题,将任务划分为 Post-training 重点优化的分布内任务(In-distribution)和未针对性优化的分布外任务(Out-of-distribution)。
实验显示,Wonder Full 在陌生任务上的表现优于前代模型,得益于更强基础模型带来的迁移收益。然而,评测设计需明确“陌生”的程度:更换代码仓库仍属相近任务,而引入全新编程框架或视觉开发任务则构成更大挑战。
熔岩灯任务结合了空间建模与视觉判断,对能力组合要求极高。单一任务失败不足以证明严重的过拟合,但提示我们需要更系统的实验来评估泛化能力。
更合理的评测方法是在相同执行条件下逐步改变任务分布,从修复 Bug 到使用未见 API,再到缺乏明确测试脚本的视觉任务。同时,通过改变环境约束(如替换工具接口、引入新错误信息),检验模型阅读文档、建立方案及自我验证的能力。
记录模型的执行轨迹,如是否主动使用截图工具、能否识别材质错误及修正策略,比单纯统计成功率更能揭示能力缺口。随着公开基准测试的成熟,动态任务和隐藏测试将成为补充固定排行榜的重要手段。

04


高分之外,需看清能力边界

Muse Wonder 在熔岩灯任务上的失利,并未否定其在软件工程领域的进步,也不足以证实严重的刷分行为。但这一事件提醒开发者重新审视 Agent 成绩的含义。
当 Post-training、工具系统和推理预算共同作用于能力提升时,排行榜高分反映的是特定条件下的任务表现。随着应用场景复杂化,单一分数的参考价值逐渐降低。
未来,Agent 将承担更独立的软件工程工作,面临更多超出既有训练范围的问题。此时,模型识别陌生环境问题、建立有效验证方法及通过反馈修正策略的能力,将决定其实际应用边界。
一盏熔岩灯虽未给出完整答案,却提供了一个具体警示:模型在熟悉任务中的成绩与在未知环境中独立工作的能力,需要分别进行严格检验。

上车,带你看遍全球 AI 顶会精华

可独家畅览:

专家演讲PPT

大会报告全文

热门论文解读

学术新星访谈
//

推荐阅读

深度拆解 Sonnet 5.5 :半价 Opus 只是表象,Agent Runtime 才是变化核心


GPT-6 丝滑「上身」宇树 G1,斯坦福把机器人控制链封装成了一套「专属 API」

未经「AI科技评论」授权,严禁以任何方式在网页、论坛、社区进行转载!

公众号转载请先在「AI科技评论」后台留言取得授权,转载时需标注来源并插入本公众号名片。

【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 8988
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读274.2k
粉丝0
内容9.0k