

点击蓝字
关注我们
AI TIME 欢迎每一位 AI 爱好者的加入!
本文作者|Ruinan Jin
本文编辑|蒲诗瑶
NeurIPS 2026
论文题目:RVCBench: Benchmarking the Robustness of Voice Cloning Across Modern Audio Generation Models
作者:Ruinan Jin*、Xinting Liao*、Hanlin Yu、Deval Pandya、Xiaoxiao Li(*共同第一作者)
机构:The University of British Columbia(英属哥伦比亚大学)、Vector Institute
论文链接:
https://arxiv.org/abs/2602.00443
代码链接:
https://github.com/Nanboy-Ronan/RVCBench(PyPI:rvcbench)
为什么语音克隆需要“体检”
零样本语音克隆技术进展迅速,但不同利益相关者面临不同的挑战:
开发者关注模型在真实场景下的稳定性,如背景噪声、长文本、外语混合及压缩传输后的表现;
声音所有者关注隐私保护,即对抗扰动能否有效防止克隆,以及是否易被去噪破解;
平台与审核方关注合成语音的可检测性,即深度伪造检测器能否有效识别。
现有评测多局限于干净条件,RVCBench 旨在通过可复现的协议,全面评估模型在复杂现实条件下的鲁棒性。
体检方案:四个环节、十类任务
RVCBench 沿语音克隆全链路设计评测,涵盖输入、生成、输出及音频扰动四大环节,对应真实部署中的各类情形。
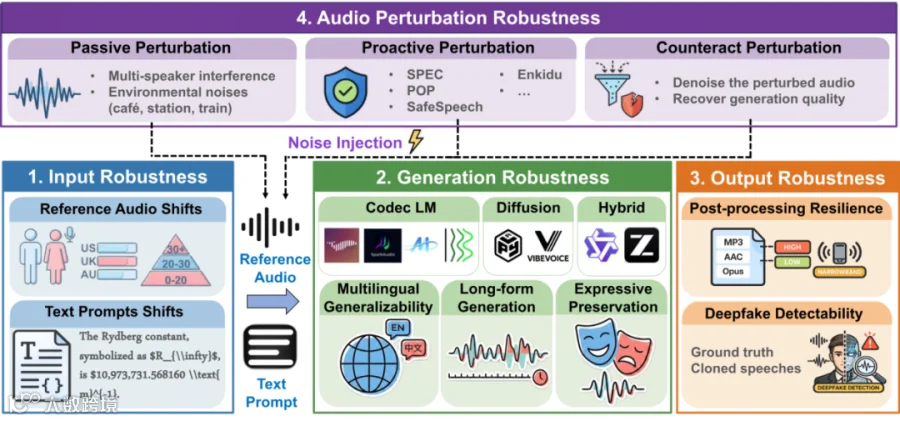
图 1|RVCBench 总览:沿语音克隆全流程,评测输入、生成、输出与音频扰动四类鲁棒性。
|
环节 |
体检项目 |
对应的真实情形 |
|
输入 |
AudioShift、TextShift |
不同口音、性别和年龄的说话人;含拼写错误、格式异常或诈骗话术的文本 |
|
生成 |
LongContext、Expression、Multilingual |
长参考与分钟级长文本;情感与风格传递;中文、法语与英-中跨语言克隆 |
|
输出 |
Compression、Detectability |
AAC / MP3 / Opus 压缩与窄带电话传输;九种深度伪造检测器的识别 |
|
音频扰动 |
PassiveNoise、AdvNoise、AntiProtect |
咖啡馆、车站等环境噪声与多人说话;防克隆对抗扰动;用去噪“破解”保护 |
评测涉及 204 名独立说话人,采用 SIM、SVA、WER、MCD、MOS、EMC、STOI 及 EER 等多维指标。被测模型涵盖自回归、扩散/流匹配及混合架构共 18 个主流开源系统。
基线检查:干净条件下,谁“既像又准”
在干净 LibriTTS 参考音频下,Qwen3-TTS 与 IndexTTS 表现最佳,相似度(SIM)达 0.61,词错误率(WER)仅 0.05。值得注意的是,“读得准”不等于“像”(如 StyleTTS 2),而“像”也不代表“读得准”(如 Higgs Audio)。单一指标易导致片面评估。

图 2|干净条件下各模型的说话人相似度与词错误率(LibriTTS)。
压力测试一:换个口音,换种语言
口音差异
在不同英语口音测试中,印度口音参考音频的 MCD 最高,加拿大口音最低。部分口音组样本较少,差异需进一步验证。

图 3|口音偏移:各模型在不同口音参考音频上的 WER 分布及平均 MCD。
语言与跨语言
跨语言相似度方面,混合模型表现较好;而主要面向英语的 OZSpeech、StyleTTS 2 在中文上相似度极低。内容准确性上,小参数模型 CosyVoice 在多语种设定下优于大参数模型 Higgs,表明架构设计与多语种训练数据比参数规模更影响鲁棒性。
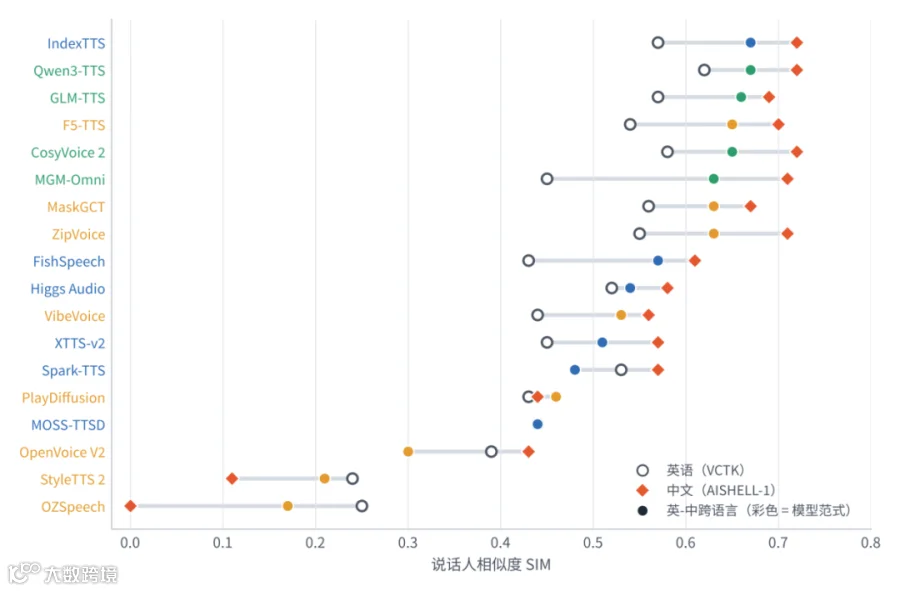
图 4|语言偏移下的说话人相似度。
压力测试二:参考录音不干净
加入环境噪声后,各项指标平均显著恶化,但模型间差异较大。在多人说话干扰下,所有模型的说话人相似度均大幅下降,表明模型难以从混杂音频中准确提取目标声纹。
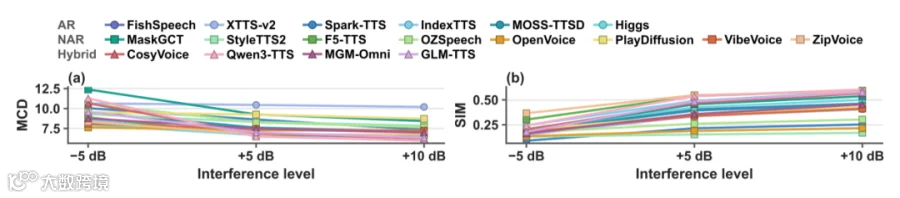
图 5|多说话人干扰:不同干扰强度下各模型的 MCD 与 SIM。
压力测试三:长文本、情感与压缩
安全视角:保护有没有用,伪造能不能被识别
防克隆保护效果
SafeSpeech 和 SPEC 等主动保护方法能显著降低说话人相似度,但效果因模型而异。部分最新模型(如 Higgs TTS 3)受保护影响较小。简单的去噪处理不足以绕过当前保护。

图 6|各模型在 SafeSpeech 与 SPEC 保护下的说话人相似度变化。
深度伪造检测难度
OZSpeech 等模型生成的语音易被检测,而 Qwen3-TTS、CosyVoice 2 等混合模型生成的语音难以被识别(EER > 30%),接近随机猜测水平。生成质量与可检测性需分开评估。
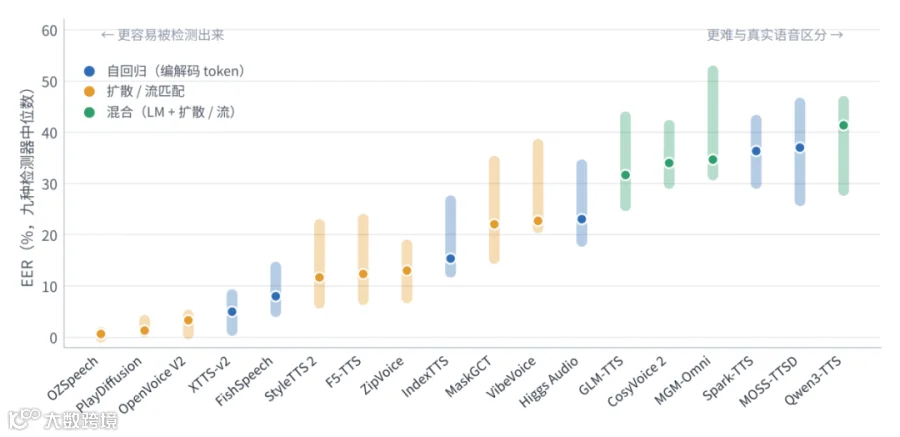
图 7|九种深度伪造检测器上各模型的 EER。
从“体检报告”到“改进方向”
|
薄弱环节 |
可能的改进方向 |
|
口音与人群差异 |
人群均衡的训练数据、与说话人解耦的表征、分组校准 |
|
嘈杂或多人参考音频 |
参考音频质量打分、声源分离、多段参考融合、噪声数据增强 |
|
分布外文本 |
文本规范化、提示清洗、感知不确定性的生成、语义一致性检查 |
|
长文本漂移 |
分层生成、显式记忆、分块一致性约束、说话人一致性正则 |
|
情感与风格控制弱 |
韵律监督、情感 / 风格解耦、风格一致性目标 |
|
压缩失真 |
编解码感知训练、压缩增强、可微后处理、更稳健的声码器 |
|
对抗扰动 |
感知扰动的说话人编码器、自适应鲁棒性评测 |
|
去噪与保护的对抗 |
自适应防御评测、抗净化的保护扰动 |
鲁棒性应成为语音克隆系统从训练阶段起的一等设计目标。
自己动手:给你的模型做同样的体检
RVCBench 已重构为 PyPI 安装包(v2.2.1),代码开源,数据托管于 Hugging Face。
pip install "rvcbench[eval]"
rvcbench setup-scorers
支持两种使用方式:
- 用法一(仅指标):调用
metrics.Evaluator批量计算已有音频的 7 项核心指标。 - 用法二(完整评测):导出评测集提示,生成音频后统一打分。
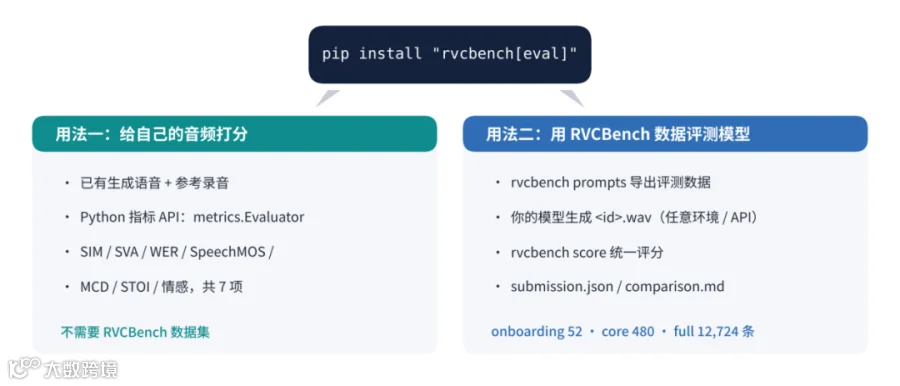
图 8|RVCBench 工具包的两种用法。
rvcbench prompts --suite core-v1 --output prompts/
# 用你的模型逐条生成,保存为 outputs/my_model/<id>.wav
rvcbench score --suite core-v1 \
--generated outputs/my_model \
--output results/my_model --device cuda
评测集分为 onboarding-v1(快速上手)、core-v1(核心覆盖)和 full-v1(大规模)三档。仓库内置多种模型适配器及保护方法,方便深入研究。
写在最后
RVCBench 提供了一份全面的语音克隆“体检报告”,揭示了干净条件下的高分并不等同于鲁棒性。噪声、长文本、跨语言及压缩等均暴露了模型短板。主动保护总体有效但需持续检验,且不同模型的可检测性差异巨大。希望这套基准和工具能为研究者提供可复现、可扩展的共同起点,助力语音生成安全研究。
往期精彩文章推荐
EMNLP 2026 Oral|机器人会抓会放,就真的会推理吗?RoboSPA 给 VLA 出了一套“逐级加难”的试卷
关于 AI TIME
AI TIME 源起于 2019 年,旨在发扬科学思辨精神,邀请各界人士对人工智能理论、算法和场景应用的本质问题进行探索,加强思想碰撞,链接全球 AI 学者、行业专家和爱好者,希望以辩论的形式,探讨人工智能和人类未来之间的矛盾,探索人工智能领域的未来。
迄今为止,AI TIME 已经邀请了 2000 多位海内外讲者,举办了逾 800 场活动,超 2000 万人次观看。

我知道你
提出观点,表达想法,欢迎

点击 阅读原文 查看原论文