


编辑丨cherry
蛋白质从头设计的核心挑战在于生成具备特定属性的结构。现有模型通常需为每种特性定制输入表示,限制了设计目标的多样性。近日,华盛顿大学大卫・贝克(David Baker)团队联合新加坡国立大学等机构,提出了一种基于文本条件化的全原子蛋白质结构生成模型——Prompteina。
Prompteina 以自然语言提示为输入,通过单一接口即可指定生成蛋白质的结构与功能特性,实现了类似“文本到图像”的蛋白质生成体验。为此,研究团队构建了包含 180 万个结构和超 5000 万条描述的大规模数据集 Prompteina-Data。
论文地址:https://arxiv.org/abs/2610.13917
开源地址:https://github.com/jleechung/prompteina
文本条件化的生成模型架构
理想的自然语言接口应支持跨尺度的特性指定,涵盖从全局折叠类别到残基特异性功能位点。为此,研究团队构建了 Prompteina-Data 数据集,将蛋白质结构与跨尺度自然语言描述进行配对。该数据集基于 PDB 实验结构、AlphaFold 数据库预测结构及 Teddymer 合成二聚体构建。
Prompteina 模型建立在预训练 Complexa 模型之上,新增了两条文本条件化通路及辅助的文本—残基对齐目标。

全局与残基级文本条件化机制
Complexa的去噪器负责生成主链坐标及侧链潜变量,随后由冻结的变分自编码器解码为全原子结构和氨基酸序列。为提供全局特性条件化信号,研究通过自适应层归一化广播来自冻结 Qwen3-Embedding-8B 的池化嵌入。

文本—残基对齐优化
在预训练阶段,研究利用流匹配损失训练去噪器,并结合 Prompteina-Data 中的残基位置注释,构建文本—残基对齐监督信号,解决文本片段与具体残基对应的难题。
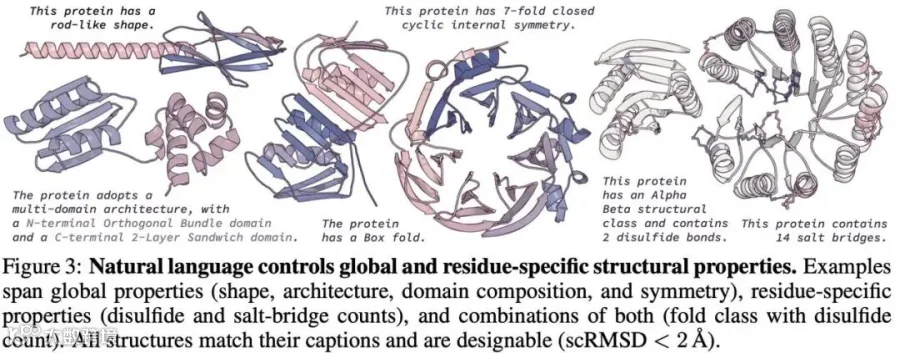
通过单一自然语言接口,Prompteina 可精确控制以下特性:
- 折叠与拓扑:CATH 类别、架构及结构域分布
- 二级结构:螺旋、链、片层数量及拓扑结构
- 三级基序:二硫键与盐桥数量
- 全局形状:尺寸、紧凑性、对称性、接触序及柔性
- 表面特性:平面性、聚集倾向及埋藏未满足极性基团
- 界面特性:残基数量、埋藏表面积、几何形状及疏水性
- 功能定义:特定家族或活性(如溶菌酶、绿色荧光蛋白)
目前,Prompteina 支持单体及蛋白质结合体设计,并可集成至智能体工作流中。其语言接口使智能体能直接将研究需求转化为设计提示,显著提升界面置信度。
实验评估与性能表现
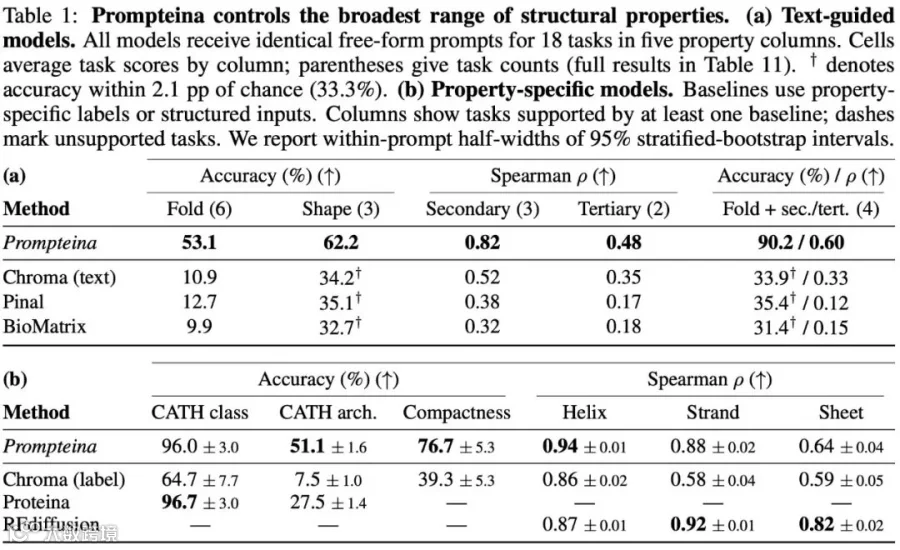
在结构特性基准测试中,Prompteina 在 18 项任务中的 15 项上优于基线模型,支持的特性维度更广,且生成结果与功能描述的匹配度更高。
在精细结构尺度上,Prompteina 对 20 个靶标的结合体—靶标界面残基数量调控表现出极高相关性(ρ > 0.99)。
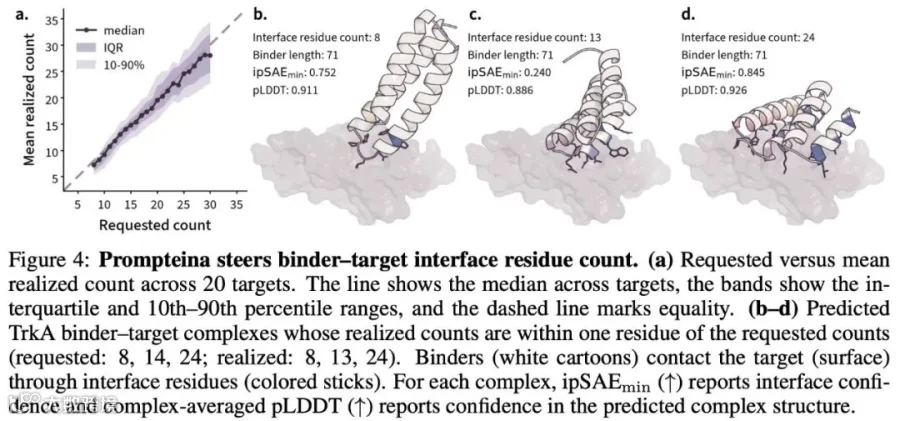
在智能体引导的蛋白质结合体设计评估中,Prompteina 在 20 个靶标中的至少 13 个上超越所有基线,界面置信度较最强基线提升 14%。

前瞻性概念验证显示,针对此前无报道从头设计结合体的 GM2A 蛋白(与 GM2 神经节苷脂沉积症相关),Prompteina 在 90 个测试设计中成功产生 9 个有效结合体。

研究结果表明,Prompteina 确立了自然语言作为蛋白质设计高效条件化接口的地位,实现了跨尺度的结构与功能控制,并将基于语言的推理与迭代优化深度整合进蛋白质设计流程。