
   (完整版.pdf )


   以下仅展示部分内容


   下载方式见文末
智见AI蓝皮书系列第三册,冻结版本 WorkBuddy 5.3.13。
它把 UI 上的按钮,翻译回磁盘上的文件与发给模型的请求。
今天这篇,带你一次性看懂 Agent 的“工程挽具”。
你有没有发现,WorkBuddy 这类 AI Agent 很神奇:
有时它记得你三周前说过的一句话;
有时它忘了你昨天刚定的规矩;
装个插件,能力暴涨;
再装几个,它又变“笨”;
专家中心里一百多个名字,你不知道哪个真有用。
多数人以为,这是“AI 的玄学”。
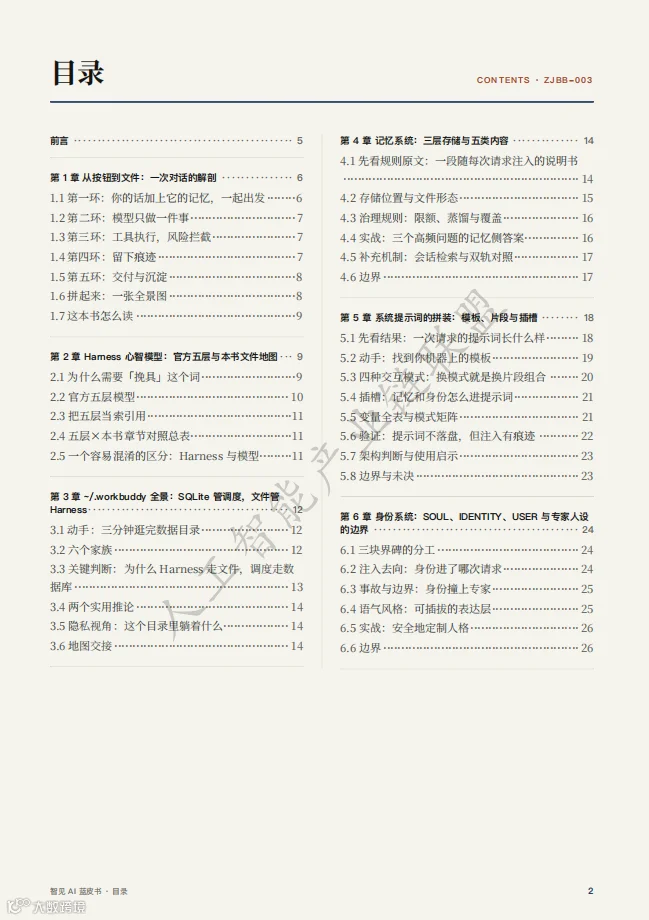
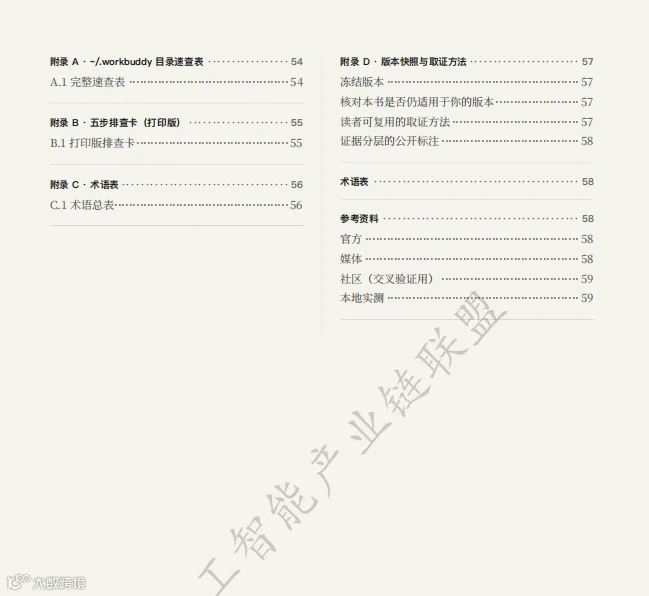
但《WorkBuddy Harness技术与实践指南蓝皮书》给了一个更硬核的答案:
不是玄学。你看到的每个行为,背后都有文件、字段、模板和请求。
这本书只做一件事:把 WorkBuddy 打开给你看。
从界面上的按钮,一路追到本地目录 ~/.workbuddy,再追到每次发给模型的请求。
它的核心方法只有一条:
看到什么行为,就去找实现它的文件。
UI 上的每个按钮,都能翻译成本地的一个文件或一个字段。
这就是 Harness。
01 先搞懂:Harness 到底是什么?
2026 年,Agent 行业收敛出一个词:Harness,工程挽具。
沙盒是减法,Harness 是加法。
沙盒约束,挽具赋能。
用大白话讲:
模型本身像一位很聪明、但完全不了解你的外援专家。
它有能力,但它不知道你的文件在哪、你的偏好是什么、哪些操作不能碰。
Harness 就是套在模型外面的整套工程系统:
-
• 告诉它开始前该知道什么; -
• 给它工具,让它能动手; -
• 拦住危险操作; -
• 记录它做了什么; -
• 把结果沉淀下来,影响下一次请求。
所以,同一个模型,接上好的 Harness,能稳定干活;
裸着用,连“读一下本地文件”都做不到。
WorkBuddy 的 Harness,官方分成五层:
-
1. 运行环境层:Agent 在哪里执行。文件系统、Shell、沙箱、浏览器、MCP、权限边界。 -
2. 引导层:Agent 开始前掌握什么。项目上下文、规则、技能、提示词缓存。 -
3. 反馈层:执行后如何获知错误。工具返回、时间戳、审计日志、文件快照。 -
4. 编排层:多个能力如何组织。专家团、渐进式加载、多模型路由、并行调用。 -
5. 迭代层:Harness 自身如何演进。更新日志、版本节奏、机制调整。
一句话:
模型决定“能不能想”,Harness 决定“能不能干成”。
02 一次对话,其实是五环流水线
你在 WorkBuddy 里说一句:
“帮我把这个文件夹里的照片按月份整理成相册,生成一份索引文档。”
十几秒后,它开始列文件、读图片、建目录、写文档,中途弹两次确认框,最后交付文件夹和 HTML 索引。
你以为它只是“发给大模型”。
其实,一次对话被拆成五个环节:
第一环:拼装
你的话,加上它的记忆、身份、规则、工具清单,一起组成完整请求。
这些零件几乎全部来自本地磁盘。
打开 ~/.workbuddy,你会看到身份、记忆、插件、技能、会话记录,几十上百兆文件。
第二环:推理
模型只做一件事:读规则、看工具清单、理解任务,然后决定下一步。
它不碰你的文件,不碰网络。
它只输出:“我想调用某某工具。”
第三环:执行
模型说“执行 mkdir 2026-07”,指令落回 WorkBuddy 执行层。
安全机制在这里主场:
-
• 工作空间内、新建而非删除,放行; -
• rm -rf某个目录,拦下,弹确认框。
这就是 Agent 和聊天机器人的分水岭:
聊天机器人一次回答完事;
Agent 在“模型思考—调用工具—拿到结果—再思考”的循环里干活。
第四环:记录
循环的每一拍都被记录。
会话文件 JSONL、执行轨迹 traces、审计日志 audit-log、文件历史快照 file-history。
你说它做了但文件没变?答案全在里面。
第五环:沉淀
任务结束,交付物落进工作空间。
同时,关键信息写入记忆层;定时任务写进本地数据库。
工作没有真的结束,它只是转成了下次请求的一部分上下文。
一句话:UI 上每个控件,都是这张五环图某个节点的入口。
03 打开 ~/.workbuddy:六个家族,文件管 Harness,数据库管调度
WorkBuddy 的全部复杂性,都安静地躺在 ~/.workbuddy 里。
这个目录有四十多个条目,分成六大家族:
-
1. 身份与记忆:SOUL.md、IDENTITY.md、USER.md、MEMORY.md、memory/ -
2. 扩展系统:plugins/、skills/、connectors/、extensions/ -
3. 配置:settings.json、mcp.json、models.json -
4. 会话与证据:projects/、traces/、audit-log/、file-history/ -
5. 调度:workbuddy.db,唯一 SQLite 数据库 -
6. 运行时杂项:app/、binaries/、logs/、shell-snapshots/
这里有个非常关键的架构判断:
Harness 走文件,调度走数据库。
实测 workbuddy.db 只有八张表:定时任务、执行历史、下次执行时间、投递队列、会话、用量统计、工作空间、迁移元数据。
没有记忆表、没有插件表、没有提示词表。
提示词模板、身份文件、记忆、技能、插件清单,全部用纯文本文件承载:Markdown、JSON、YAML。
好处很直接:
-
• 用户可以直接看、直接改; -
• 生态格式可以直接复用; -
• 版本更新按文件分发; -
• 数据库只承载需要高频查询和事务的调度状态。
记住这句话:
文件是给人和生态的,数据库是给调度器的。
04 记忆系统:三层存储、五类内容、限额与蒸馏
“它记得我”,是用户最常报告的惊讶,也是最多抱怨的来源。
WorkBuddy 的记忆不是一个东西,而是三层存储。
第一层:云端画像
服务器生成,会话开始时注入,本地只读。
缓存在 ~/.workbuddy/memory/,你手改也会被下次同步覆盖。
另外还有历史会话检索工具,需要时向服务器搜索,不占请求上下文。
第二层:用户级本地记忆
就是 MEMORY.md。
全项目共享,写入限额每次会话 4000 字符,由模型在你明确说“记住这个”时更新。
它是硬规则清单,不是笔记本。
第三层:工作区记忆
只在当前项目生效。
每天一个日期文件,追加式,不许改历史;
加一份精炼长期笔记,限额 3000 字符;
超过 30 天的日志,按主题蒸馏进长期笔记后删除。
官方还给了五类记忆:
-
• 稳定事实 -
• 知识背景 -
• 行为信号 -
• 表达偏好 -
• 会话延续
注意一个刻意设计:
程序性记忆——也就是“怎么做事情的方法论”——被排除在长期记忆之外。
怎么做事,归技能系统管。
记忆只管:你是谁、你知道什么、你偏好什么。
很多人配置失败,就是因为把该写成技能的方法论,塞进了记忆。
05 系统提示词:不是咒语,是拼装出来的产品
同一个 WorkBuddy,你在问答模式问“你是谁”,和在专家对话里问同样的问题,答案可能是两个人。
因为每次请求前,WorkBuddy 都会用本地模板,把身份、记忆、模式约束、专家人设拼成一份完整的系统提示词。
5.3.13 里,主线程系统提示词由四类零件拼成:
-
1. 主模板:带占位符的文本骨架,Jinja2 语法; -
2. 模式片段:ask、plan、craft、expert 四组行为约束; -
3. 插槽变量:模型名、界面语言、平台、三层记忆内容; -
4. 插件注入:专家人设、规则文件等覆盖内容。
你在界面上点一次“切换到问答模式”,落到文件层面就是:
下次渲染时,workMode 取值 ask,拼进去的是 ask 目录那一组片段。
模式不是不同的机器人,是同一骨架上换了一组约束。
更妙的是,“模式”在 WorkBuddy 里至少指两件事:
-
• 欢迎模式:work / code / design,换主模板; -
• 交互模式:ask / plan / craft / expert,换行为片段。
两者正交组合。
你在界面上做的一次模式选择,落到文件层可能是两层模板同时切换。
还有一个重要结论:
系统提示词不落盘,但注入有痕迹。
会话文件里没有 system 条目。
但专家会话首条用户消息会带 system-reminder 和 expert_selection 标签。
执行轨迹 traces 记录请求确实发生。
模板证明“怎么拼”,注入痕迹证明“拼了什么进去”,轨迹证明“确实发了”。
06 身份系统:SOUL、IDENTITY、USER 与专家人设的边界
数据目录根部躺着四个大写文件:
-
• SOUL.md:人格与工作方式; -
• IDENTITY.md:它是谁; -
• USER.md:你是谁; -
• MEMORY.md:长期记忆。
三个身份文件在安装引导阶段生成,之后随时可改。
格式全部是普通 Markdown。
这意味着:身份不是模型参数,是磁盘上的文本。
它能被定制、被迁移,也被误用。
这里有一次真实产品事故。
某个版本里,用户自定义的身份内容会覆盖专家人设,导致“专家不像专家”。
官方 4.8.1 更新日志修复条目原文:
“不再注入 IDENTITY.md 内容,确保专家人设不被覆盖。”
一行字,划出重要边界:
身份系统管辖常规助手;专家对话时,专家插件的人设优先,用户身份让位。
这次事故的教学价值超过事故本身:
多个“人格来源”叠加时,优先级必须在拼装层显式裁决。
否则模型收到矛盾指令,行为随机。
07 专家解剖:一个带 UI 的 SubAgent 插件
专家中心是 WorkBuddy 最像应用商店的地方。
头像、职业标签、一句简介、三个快捷问题按钮。
但拆到文件级,一位专家就是一个插件包。
以“数字生命卡兹克”为例,全部家当四个文件:
-
• .codebuddy-plugin/plugin.json:插件清单; -
• agents/aihot.md:人设提示词; -
• skills/aihot/SKILL.md:配套技能; -
• avatars/expert.png:头像。
你在界面上看到的每一格 UI,都能在清单里找到字段级对应:
-
• 头像 = avatar -
• 职业标签 = profession -
• 开场白 = defaultInitPrompt -
• 快捷按钮 = quickPrompts -
• 专家类型 = expertType
运行时,专家人设文件被完整注入首条用户消息。
模型推理原话可能是:“根据专家指令,我必须调用 aihot 技能获取实时数据,不能凭训练数据猜测。”
人设不只被塞进上下文,还实际支配了行为。
一次专家对话 =
清单字段渲染 UI + 人设注入 + 技能执行。
没有魔法,全是文件。
专家团则是另一种形态:多位专家加协作流程。
团长拆解任务、分派成员、并行执行、整合交付。
08 插件系统:五个市场、三层作用域与供应链
专家是插件,但插件远不止专家。
WorkBuddy 的插件管理用三个文件协作:
-
• installed_plugins.json:记录装了什么; -
• known_marketplaces.json:记录从哪装; -
• settings.json的enabledPlugins:装了不等于启用。
这是干净的注册—配置分离:
市场注册表管“货源”,安装清单管“库存”,设置文件管“通电”。
本机实测有五个市场,名字本身就是生态地图。
其中可见 codebuddy-plugins-official 开发者官方市场,还有内置市场、专家市场、Teams 市场等。
插件能往你的对话里注入四类内容,侵入度递增:
-
1. 技能:按需加载的方法论文档,最温和; -
2. 智能体 agents:人设提示词,替代或叠加人格; -
3. 规则 rules:常驻约束, alwaysApply: true,进入每一次对话; -
4. MCP 与工具:直接连外部服务的通道。
更新日志还显示,插件可以挂 Hook:在指定事件上做确认拦截。
这是第五种能力:不只影响说什么,还能影响什么被允许发生。
所以,插件系统本质是一条软件供应链:
市场(货源)→ 清单(目录)→ 注入(交付)。
评估任何插件,三问:
-
• 作者是谁,可不可追溯? -
• 注入物是什么?规则写了什么? -
• 能力边界在哪?要密钥吗?连外部服务吗?装 Hook 吗?
09 技能与规则:SKILL.md 按需,WORKBUDDY.md 常驻
技能不是代码。
技能主体是一份 Markdown 文档:SKILL.md。
开头一段元数据:名字、一句“什么时候用我”的描述。
正文写“这类任务怎么做”。
关键词是:按需加载。
系统提示词寸土寸金。
技能清单只把“名字 + 描述”放进基础上下文。
完整方法论文档,等你真的做这类任务时才读取。
规则文件则相反:常驻在场。
项目根目录放 WORKBUDDY.md,记录架构约定、依赖边界、安全要求、代码风格。
相关项目的每次请求里,规则都会被注入。
一句话判断标准:
“永远适用”进规则,“有时适用”进技能。
技能最关键的写法,是 description。
它不是写给人看的简介,是写给模型看的路由表。
措辞覆盖度,决定触发率。
比如你写“当用户需要生成周报文档时使用”,但用户真实措辞是“整理一下这周的工作”,模型就可能不唤醒技能。
改成:“当用户要求写周报、整理本周工作、总结一周进展时使用。”
触发率立刻上来。
10 会话与证据:JSONL、traces 与审计日志
WorkBuddy 在磁盘上同时记三本账:
-
1. 会话流水 JSONL:它做了什么; -
2. 文件历史 file-history:它改了什么; -
3. 执行轨迹 traces + 审计日志 audit-log:何时、多少、合不合规。
会话记录按项目分组,每个会话一个 JSONL 文件。
一行一个事件,事件类型有六种:
-
• message -
• reasoning -
• function_call -
• function_call_result -
• file-history-snapshot -
• ai-title
最有价值的设计是:每个事件都带 parentId,指向上一个事件,串成链。
这让“第 3 步的判断依据是什么”变得可追溯。
顺着链往回走,能看到模型读到哪个文件、拿到什么结果、然后做了什么决定。
三本账里没有任何一本存拼装后的完整系统提示词。
但它们能回答:
-
• 它做了什么? -
• 它改了什么? -
• 它用了什么模型? -
• 它在哪个目录? -
• 耗了多少 token?
providerData 里还有运行时元数据:model、requestModelId、traceId、usage、cwd。
排查“模型不对”“成本太高”,先看这里。
11 连接器与 MCP:数据出域,审批拦在哪
连接器与 MCP,是 WorkBuddy 伸向外部世界的手。
两套接入体系:
-
• MCP 服务器:业界标准协议,配置在 mcp.json; -
• 连接器 Connector:面向企业服务的预集成市场。
区别不在协议,在信任模型:
MCP 是你自己选服务、自己担责任;
连接器是市场背书的预集成,安装即用。
外部连接的核心问题只有一个:数据往哪流。
分三段:
-
1. 配置与凭证:OAuth 令牌、API 密钥,可能明文存在本地; -
2. 任务数据出域:文件清单、内容进入第三方调用链; -
3. 模型端点:所有对话先发给模型服务方;如果你配了第三方模型端点,再转一道弯。
审批有两层:
-
• 工具粒度:新 MCP 工具首次调用时请求授权; -
• 操作粒度:写敏感位置、删除、执行脚本、网络访问,按风险分级确认。
实践建议:
首次调用必看参数,优先选支持 OAuth 的服务,第三方自建 MCP 按供应链三问过一遍。
12 安全与隐私:四类风险,十分钟自查
Harness 的每一层都是攻击面。
四类风险:
-
1. 提示词注入:内容变成指令。插件规则、专家人设、技能文档,都可能被注入。间接注入更隐蔽:你让它读一个网页,网页里藏着“忽略之前指令”。 -
2. 本地明文凭证:通道令牌、会话标识、模型密钥,可能明文躺在配置目录。 -
3. 文件系统:权限模式、提示词规则、沙箱白名单,三层拦截。三层都不是绝对墙,层多概率低。 -
4. 数据出域:内容可能留下副本的六个位置——模型服务方、第三方端点、外部连接、插件目的地、本地记录、备份。
十分钟安全自查:
-
• 数一数启用的插件,想不起来源的关掉; -
• 确认每个 MCP 服务都是自己加的; -
• 断开超过一个月没用的连接器; -
• 权限模式确认在“默认权限”; -
• 通读身份与记忆文件,删过时条目,确认没有 secrets; -
• 清理敏感历史会话; -
• 给 ~/.workbuddy做一份加密备份。
13 生态坐标:CodeBuddy 同源、OpenClaw 兼容、腾讯产品矩阵
拆到文件层,你会发现 WorkBuddy 不是孤岛。
三组硬证据:
-
• 插件清单格式 .codebuddy-plugin; -
• 技能市场格式 .codebuddy-skill; -
• 身份四件套 SOUL、IDENTITY、USER、MEMORY,来自 OpenClaw 生态。
数据目录里那个拼写独特的 memory/、微信通道配置节 claw、通道状态目录,都是同一生态的组件痕迹。
本机身份文件甚至自述:“运行在 OpenClaw 上,也运行在 WorkBuddy 上。”
对你的实际意义很具体:
你为 OpenClaw 生态找的人格文件、技能,大概率能在 WorkBuddy 里直接用;反之亦然。
腾讯 AI 产品矩阵里,元宝、ima、CodeBuddy、WorkBuddy 分工并存。
WorkBuddy 的 Harness 会持续向“组织可管理”方向加码,同时借 CodeBuddy 生态获得开发者侧能力输送。
14 实战:五步排查法 + 第一次安全定制
“不生效”是高频抱怨。
真实原因几乎全部落进同一条链:
文件 → 拼装 → 请求。
五步排查:
-
1. 查层级:你改的东西在哪个作用域?技能有用户级与项目级,规则只对所在项目生效。 -
2. 查开关:它通电了吗?插件看 enabledPlugins,技能看 frontmatter 三横线是否闭合。 -
3. 查拼装:它在这次请求的清单里吗?新会话触发一次,去会话文件找注入痕迹。 -
4. 查缓存与同步:新内容被旧状态压住了吗?云端画像会覆盖本地手改;市场更新可能改掉模板。 -
5. 查版本:机制变了吗?产品平均两天一版,对照更新日志。
闭环还要加一步:
修复后新开会话验证。旧会话不反映修复。
第一次安全定制,推荐“规则 + 技能”组合:
-
• 项目根建 WORKBUDDY.md,写硬约束; -
• .workbuddy/skills/下建SKILL.md,写方法; -
• 验证:先列文件清单待确认,产出落固定目录,结构三段式。
这就是从“用户”变成“驾驭者”的一步。
15 教学复用:视频课、认证课与图书
这本书还是一套可拆用的教学资产。
90 分钟讲透 Harness:
-
• 开场 10 分钟:一次对话五环拆解; -
• 概念 15 分钟:五层模型; -
• 机制纵深 35 分钟:提示词拼装、专家解剖、记忆三层; -
• 风险与治理 15 分钟:安全清单; -
• 收尾 15 分钟:五步排查法。
认证课程可以组成 4—8 学时模块:
能解释、能操作、能设计。
图书写作要守两条边界:
机制内容带版本锚点;实操内容重写而非照搬。
最后:机制会过时,方法不会
WorkBuddy 平均两天一个版本。
书里的路径、字段、机制,终将过时。
但这本书真正想留给你的,不是某个版本的文件名,而是三样东西:
-
1. 五层模型:分析任何 Agent 的框架; -
2. “UI → 文件 → 请求”的追问路径:拆解任何黑盒产品的方法; -
3. 证据意识:会话、轨迹、审计,是与技术共处的底气。
按钮解决的是“能不能用”。
理解解决的是“能不能用好、敢不敢托付”。
下次再遇到一个现象级 Agent,打开它的数据目录,你就知道该看什么。
沙盒约束,挽具赋能。
Sandbox constrains, Harness enables.
版本说明:本文基于《WorkBuddy Harness技术与实践指南蓝皮书》公开测试版候选,适用 WorkBuddy 5.3.13(build 20fd9da5,macOS),as_of 2026-08-15。机制会变,方法长存。