

模型具备推理能力,并不等同于 Agent 拥有记忆;仅能存储历史记录,也不代表构建了真正的记忆系统。
许多 AI 用户都曾遭遇此类困境:首次交互时详细告知背景与偏好,AI 表现优异;但在后续跨会话协作中,AI 往往遗忘既定方案,迫使人工重复输入。尽管大模型在代码编写、工具调用及任务规划上日益精进,但在长期连续协作中仍显生疏。
这一痛点常被归咎于上下文窗口限制或记忆功能不完善,但从工程视角审视,问题远非如此简单。核心差异在于:模型擅长单次推理,而 Agent 需具备从历史交互中提取价值、判断有效性并沉淀新经验的完整机制。
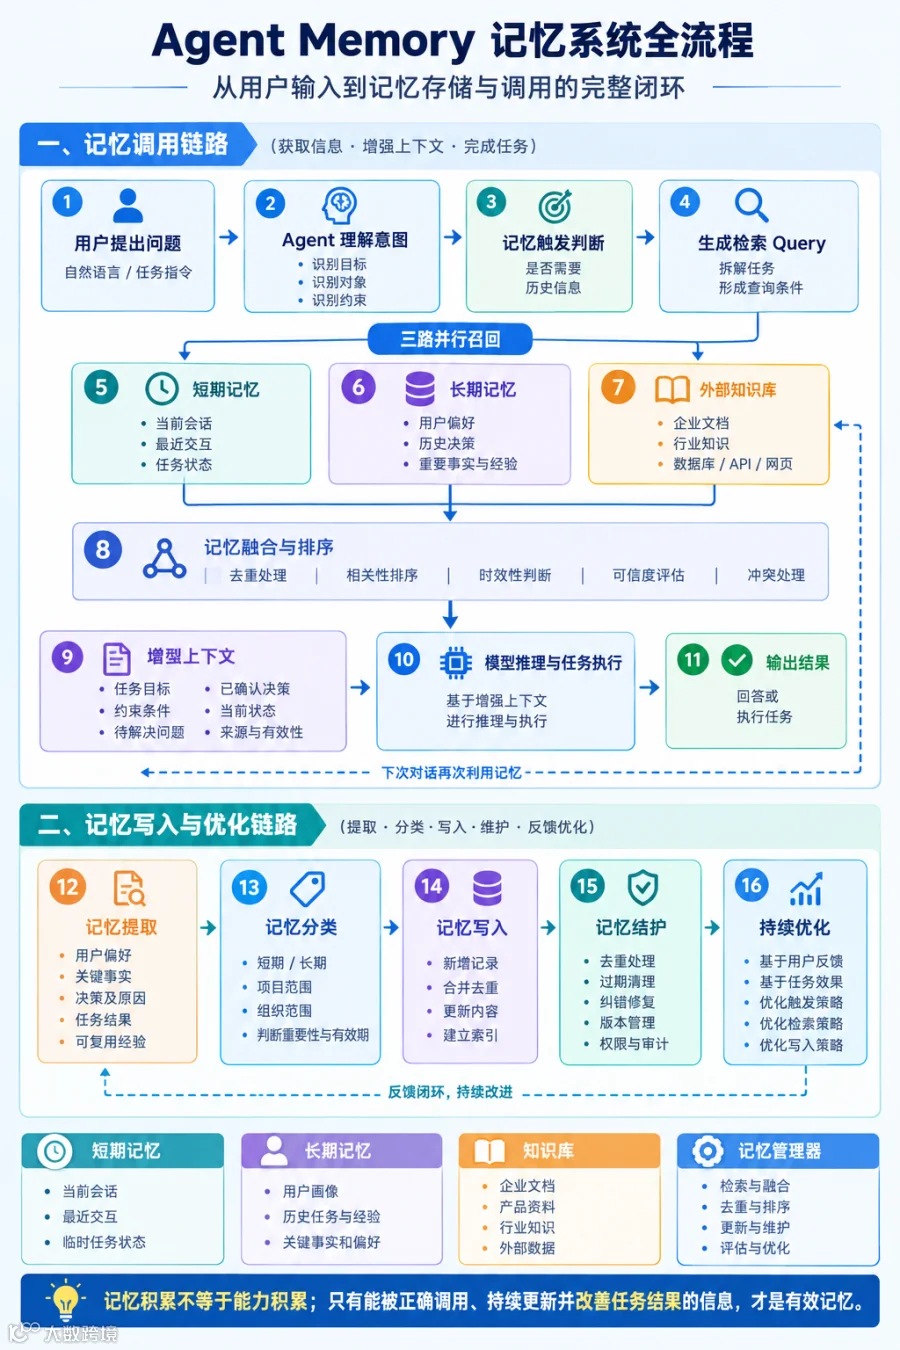
本文将 Agent 记忆系统拆解为七个模块、16 个处理步骤,覆盖从问题提出到记忆写入、维护及复调用的全生命周期,为构建高效 Agent 提供架构参考。
CONCEPTS
概念辨析:上下文、聊天记录与记忆
构建记忆架构前,需厘清三个易混淆概念:
1. 上下文窗口 ≠ 记忆
上下文窗口解决的是单次推理中的信息接收量问题。即便支持超长上下文,模型也无法自动判定信息的长期保存价值、过期状态或下次调用时机。扩大窗口仅缓解容量焦虑,无法解决信息管理难题。
2. 聊天记录 ≠ 记忆
聊天记录仅忠实保存“过去发生了什么”。当用户要求“继续完善方案”时,系统是重读全部记录,还是精准提取最终方案、决策依据及待办事项?前者效率低下,后者才是记忆系统的核心价值——解决筛选、组织、检索与更新问题。
3. 记忆系统 = 面向任务的信息管理机制
Agent Memory 需回答五个核心问题:
什么值得记? 区分一次性指令与长期偏好。
何时查找? 避免非必要的全量读取。
如何使用? 处理重复、过期及矛盾信息。
如何保存? 决定新增、更新或丢弃。
何时遗忘? 清理失效事实以防干扰决策。
ARCHITECTURE
架构拆解:Agent 记忆系统的七大模块
完整 Agent 记忆系统由以下七个模块构成,协同完成“信息流”与“记忆流”两条链路:
用户(User)
智能体(Agent)
记忆触发器(Memory Trigger)
短期记忆(Short-term Memory)
长期记忆(Long-term Memory)
记忆管理器(Memory Manager)
知识库(Knowledge Base)
各模块职责如下:
1. Agent:意图理解与任务判断
Agent 需解析用户意图(如“按上次思路完善方案”),判断是否需调用记忆系统获取背景信息。对于简单任务,应避免不必要的记忆检索以降低成本。
2. 记忆触发器:检索决策入口
负责判断当前任务是否需要历史信息。例如,“继续上次任务”或“按偏好修改”通常触发记忆;而简单数学题则无需。触发器需在“遗漏关键信息”与“过度检索噪音”间取得平衡。
3. 短期记忆:保障任务连续性
存储当前会话及进行中任务的关键信息,如已执行步骤、最新修改要求、中间结果等。其生命周期随任务结束而终止,可通过 Redis 或数据库实现,关键在于明确其临时性。
4. 长期记忆:沉淀复用经验
保存未来仍有价值的信息,如用户稳定偏好、项目关键决策、已验证的经验法则。需区分一次性指令与长期习惯,并允许随时间推移进行更新而非永久固化。
5. 知识库:外部事实支撑
主要索引企业制度、产品文档、行业数据等外部资料。与长期记忆不同,知识库侧重客观事实,长期记忆侧重个性化交互历史。两者在物理存储上可共用基础设施,但逻辑职责必须分离。
6. 记忆管理器:信息组织核心
负责检索、去重、排序、融合、更新及清理。这是记忆系统的“大脑”,需处理信息冲突、过期失效及重要性评估,而非简单的增删改查。
「存储仅是基础设施,决定记忆价值与管理策略才是核心逻辑。」
RETRIEVAL
调用流程:对话中的记忆检索机制

Agent 识别任务目标、对象及约束条件。若发现如“按上次标准”等依赖历史的表述,即标记需读取记忆。
基于规则或模型判断检索必要性,避免对简单任务执行全量检索。
将自然语言转化为结构化查询条件,如拆解出项目ID、评估标准版本、当前进度等,以提升检索精准度,超越简单的文本相似度匹配。
系统根据任务类型动态选择检索源:
短期记忆:确认当前进度与下一步动作。
长期记忆:恢复背景、偏好及历史决策。
外部知识:获取最新业务数据、制度或事实依据。
对多源信息进行去重、冲突检测及有效性评估。排序维度包括:
相关性:与当前任务的关联程度。
时效性:信息是否依然有效。
可信度:来源权威性(如正式审批 vs 模型推断)。
重要性:是否包含关键约束或决策。
语义相似不等于事实有效,需结合元数据与业务状态进行综合判断。
将整理后的信息结构化注入上下文,包括任务目标、关键事实、已确认决策及待解决问题,而非简单堆砌历史对话。
模型基于增强上下文生成回答。需注意,记忆仅提供信息支持,不保证答案绝对正确,需警惕错误记忆的持续影响。
WRITE-BACK
写入机制:对话后的信息沉淀与维护
完整的记忆系统需具备写入能力,从新交互中提取价值。
1. 信息提取与过滤
并非所有对话均需留存。应重点提取用户长期偏好、关键业务决策、任务状态变更及可复用经验。对于模型推断内容,需经确认或多次验证后方可转为长期事实,避免误标签化。
2. 分类与存储策略
依据信息用途、稳定性及适用范围进行分类:
临时任务状态:随任务结束清理。
稳定偏好:进入长期记忆,允许修正。
业务事实:以权威系统为准,对话记录仅作辅助。
3. 写入操作:新增、合并与更新
避免单纯追加导致信息冗余与冲突。例如,项目上线时间变更时,应更新旧记录状态并保留版本痕迹,确保检索时仅返回当前有效信息。
4. 生命周期管理
设定过期策略、优先级调整机制及定期清理规则。区分“重要性”与“有效性”,高重要性但已过期的信息不应占据检索高位。
FEEDBACK LOOP
质量保障:基于反馈的闭环优化
记忆系统的核心价值在于通过实际使用结果调整策略,形成闭环:
「对话产生信息 → 提取分类入记忆 → 检索使用 → 根据结果调整策略」
1. 多维评估指标
检索质量:准确率、召回率及重要记忆遗漏情况。
任务效果:回答质量、完成率及连续性的改善程度。
记忆准确性:错误事实、过期信息及未更新内容的占比。
运行成本:延迟、Token 消耗及冗余检索比例。
安全权限:数据隔离、访问控制及溯源能力。
2. 理性对待用户反馈
用户纠正具有高价值,但需判断其适用范围(当前任务 vs 长期偏好)。避免将局部临时变化错误泛化为全局规则。
3. 持续进化
优质记忆系统应随使用次数增加而愈发精准,减少重复错误,及时剔除失效信息,而非单纯追求规模膨胀。
PRACTICE
工程实践:自建 Agent 记忆系统指南
建议从具体业务场景出发,分阶段构建能力,避免初期过度设计。
1. 明确必记信息
优先分析“遗忘某条信息会导致何种后果”,以此确定存储优先级,而非盲目选择技术栈。
2. 规范数据结构
为记忆条目建立标准字段,至少包含:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
尽早引入来源、权限及状态管理,降低后期重构成本。
3. 分阶段建设
状态管理:实现当前任务进度的追踪。
持久化:建立跨会话信息的存储与查询。
提取分类:自动化区分指令、偏好与事实。
多路检索:融合短长期记忆与外部知识。
安全治理:完善权限、审计与纠错机制。
评估体系:持续监控检索质量与任务效果。
4. 避开常见误区
!全量存储:导致噪音淹没信号,应先筛选后存储。
!RAG 等同记忆:RAG 仅解决检索,缺乏记忆特有的提取、更新与偏好管理能力。
!只写不更:导致新旧事实冲突,需建立更新与版本机制。
!唯相似度论:忽视来源、时效与业务状态,易引发错误引用。
!忽略权限:个人、项目与组织记忆需严格隔离,符合数据安全规范。
THE END
结语:记忆是一套工程体系
Agent 的长期协作能力差异,本质在于记忆系统的设计优劣。一个成熟的记忆系统涵盖三个层次:
存储:留存有价值信息。
检索:及时找回所需信息。
管理:持续更新、纠错与优化。
对于企业级应用,还需统筹项目状态、业务对象、决策过程及权限边界。记忆系统的终极目标并非“记住更多”,而是:
「在正确的时间,为当前任务提供正确、有效、可信且合规的信息。」
唯有如此,过去的经验才能真正赋能未来的决策,体现记忆的深层价值。
END