

太长不读:
一家多品种、小批量的非标制造企业,希望用 AI 加快售前报价。团队最初尝试让模型看完图纸直接给价格,结果发现模型生成的数字与真实成本经常对不上。
后来,FDE 重新拆解了任务:
AI 负责把 PDF、CAD 和图纸里的非标需求转成标准字段;企业自己的物料、供应商、工艺和成本规则负责计算;技术人员确认低置信度字段和最终报价。
这个项目最值得学习的,不是多模态模型有多强,而是团队知道什么时候应该让模型退出。
一、客户只是发来一张图纸,企业为什么迟迟报不出价?
公开案例中的客户是一家两三百人的柔性制造企业,年营收约 10~20 亿元。它的业务特点是多品种、小批量,而且非标件很多。
客户发来的不一定是规范表单,可能是一份 PDF、一张 CAD 图、几页扫描件,甚至是夹杂在邮件里的补充说明。
要给出报价,企业内部需要先回答一串问题:
-
• 客户究竟要做什么零件? -
• 材料、尺寸、公差和表面处理是什么? -
• 现有设备能不能做? -
• 应该走哪条工艺路线? -
• 需要哪些物料和外协服务? -
• 应该找哪家供应商? -
• 材料、工时、损耗和风险成本是多少?
因此,报价并不是往模板里填一个数字,而是一条跨越销售、技术、采购和生产的售前决策链。
订单一多,真正稀缺的不是 Excel,而是少数能看懂图纸、理解工艺、知道历史价格的技术骨干。
报价慢,企业可能丢单;报价低,可能接到一笔越做越亏的订单;报价高,又可能直接失去客户。
二、AS IS:ERP 已经有了,为什么还要靠老师傅?
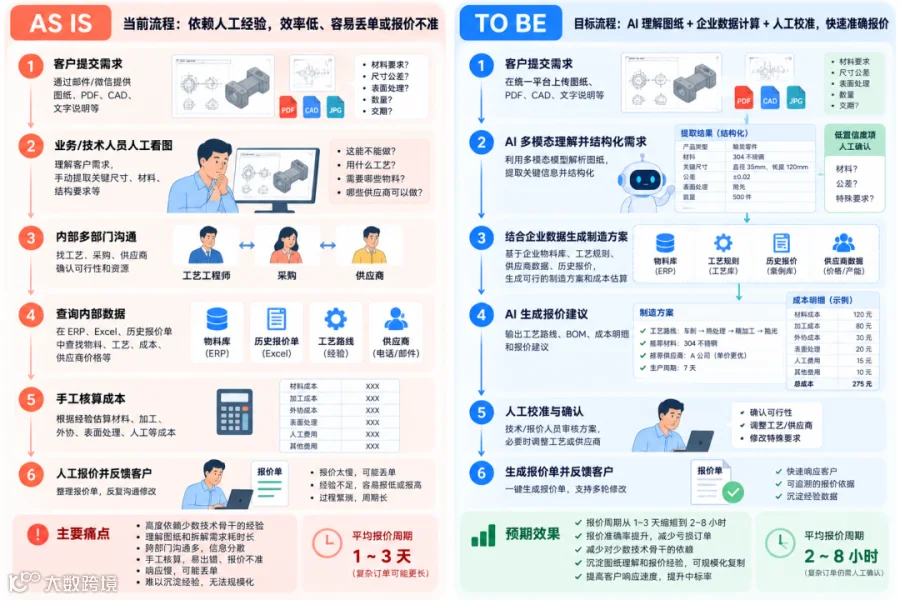
原来的流程大致是:
text客户发送 PDF / CAD / 图纸
             ↓
业务人员整理需求
             ↓
老师傅 / 技术人员人工看图
             ↓
提取材料、尺寸、公差、结构要求
             ↓
判断制造可行性和工艺路线
             ↓
查物料、供应商、历史价格
             ↓
核算材料、工时、损耗与成本
             ↓
人工形成报价
             ↓
复核后发给客户
这家企业并不是没有 ERP,也不是没有报价模板。
ERP 擅长处理标准字段:只要材料、数量、工艺和工时已经确定,它就可以继续查数据、跑规则、算成本。
真正的断点发生在 ERP 之前:
客户给企业的是非结构化图纸,ERP 等待的却是标准数据。
过去,这个转换只能由人完成:
text客户的非标表达
→ 技术人员理解
→ 转成企业标准字段
→ ERP 和报价系统开始工作
所以项目表面上叫“AI 报价”,本质上先要解决的是:
怎样把客户的语言和图纸,翻译成企业内部可以计算、可以追责的数据。
三、FDE 第一步:跟着一张订单走到底
案例里的 FDE 没有先讨论模型参数,而是进入车间、翻历史报价单,并分别跟着业务、技术和老师傅走完整个流程。
他要弄清楚:
-
• 谁第一次打开客户图纸? -
• 谁把需求拆成材料和尺寸? -
• 谁判断企业能不能生产? -
• 谁选择工艺和物料? -
• 谁查询供应商和历史价格? -
• 谁给损耗和风险留余量? -
• 谁对最终价格负责?
很多企业嘴上说“报价靠经验”,但经验并不是一个神秘按钮。
它通常由大量条件组成:某种材料优先找哪家供应商,什么尺寸必须换工艺,哪类订单要增加损耗,什么公差意味着更长工时。
只有跟着真实订单观察,FDE 才能把这些隐性的判断点找出来。
四、第一版为什么失败:模型能生成价格,不等于它会算成本
这个案例最有价值的部分,是方案并非一次成功。
团队最初尝试过更直接的路线:让模型理解图纸,再直接输出价格。
演示效果可能很好:上传图纸,几秒钟后得到一个数字。
但进入真实业务后,问题立刻出现:模型给出的价格与企业真实成本经常对不上。
原因很简单。
报价不是语言生成任务,而是带有严格业务约束的计算任务。它依赖实时材料价格、供应商协议、设备工时、工艺路线、损耗率和企业利润规则。
模型可以生成一个“看起来合理”的数字,却无法证明这个数字来自哪条成本规则。
更危险的是,数字越像真的,人越容易放松警惕。
于是团队放弃了“图纸直接变价格”的端到端幻想,重新划分系统职责:
让 LLM 和多模态模型处理不确定性的理解,让企业系统处理确定性的计算。
五、TO BE:AI 先结构化,企业规则再报价
调整后的流程大致是:
text客户上传 PDF / CAD / 图纸
              ↓
      多模态模型理解与提取
              ↓
  材料 / 尺寸 / 公差 / 数量
  表面处理 / 结构要求 / 备注
              ↓
   字段校验与低置信度人工确认
              ↓
        企业标准需求对象
              ↓
 ┌────────────┼────────────┐
 ↓            ↓            ↓
物料与供应商   工艺与 BOM    历史报价与成本规则
 └────────────┼────────────┘
              ↓
       生成成本与报价草稿
              ↓
        技术 / 业务人员复核
              ↓
            对外报价
这个架构里,模型负责:
-
• 看懂非结构化图纸; -
• 识别关键字段; -
• 统一不同客户的表达; -
• 对缺失、冲突和低置信度内容给出提示。
企业系统负责:
-
• 查询物料与供应商; -
• 匹配工艺路线和 BOM; -
• 使用最新成本数据; -
• 执行确定性计算; -
• 保存依据、版本和审计记录。
人负责:
-
• 校准模型不确定的字段; -
• 判断无法程序化的特殊工艺; -
• 处理高风险订单; -
• 确认最终对外报价。
这不是让 AI 少做一点,而是让每一方只做自己擅长的事。
六、老师傅经验怎样进入系统?
项目做到这里,会再次撞上制造业 AI 的老问题:系统有数据,但真实决策逻辑仍在人的脑子里。
例如:
text为什么这种材料优先找供应商 A?
为什么这个尺寸要预留 5% 损耗?
为什么同样的零件换一种公差,工艺路线就变了?
为什么这个客户的急单必须增加风险系数?
这些判断可能没有出现在数据库字段里,却真实影响着成本和利润。
因此,FDE 还要把历史报价、物料数据、供应商记录和老师傅判断放到一起,逐步还原企业真正使用的报价逻辑。
真正耗时的工作,往往不是调用模型,而是:
-
• 清洗历史物料和报价数据; -
• 统一单位、命名与分类; -
• 找出同类订单为何价格不同; -
• 把经验拆成适用条件、动作与例外; -
• 让领域专家确认规则是否可靠。
这一点与项目 5 的老师傅经验传承很像。区别在于,项目 5 把经验用于知识问答;项目 9 把经验放进了一条直接影响利润的决策链。
七、人工复核不是补丁,而是数据飞轮
因为报价会直接影响毛利,合理的目标并不是:
text图纸 → AI → 自动把价格发给客户
而应该是:
textAI 提取字段
→ 低置信度字段人工校准
→ 企业规则计算
→ 报价建议
→ 人工确认
→ 对外报价
更关键的是,人工修改不能只停留在当前订单。
假设模型把材料识别为 304 不锈钢,技术人员改成了 316L,系统应该保存:
text原始图纸
+ AI 提取结果
+ 人工修正结果
+ 修正原因
这些记录可以用于改进字段提取、补充规则、更新测试集,也可以识别某一类图纸是否长期容易出错。
因此,人在系统里不只是审批员,也是高质量反馈数据的生产者。
八、这个项目最容易低估的四个难点
1. “看懂图纸”的验收标准是什么?
不能只看整体字段准确率。材料、公差和数量的业务风险完全不同,关键字段需要单独评估,并明确低置信度时如何拦截。
2. 主数据是否足够干净?
如果同一种材料有多个名称、单位不一致、供应商记录重复,模型抽取得再准,也无法可靠连接后续系统。
3. 规则能否解释和追溯?
最终报价必须能回答:用了哪个版本的材料价、选择了哪条工艺路线、谁修改过字段、为什么增加损耗。
4. 怎样防止错误一路传导?
如果模型把材料、公差或数量识别错,后面的 BOM、工艺和成本都会“正确地计算出一个错误答案”。系统必须在关键节点设置校验和人工升级。
九、这个案例给 FDE 的五条方法
第一,先还原端到端业务,再决定 AI 放在哪里。
报价不是一个页面功能,而是一条跨角色、跨系统的决策链。
第二,把非结构化理解与确定性计算分开。
模型负责理解,规则和系统负责算账。
第三,允许第一版失败,但要从失败中重画职责边界。
端到端直接报价不可靠,不代表项目失败,而是说明任务拆分需要调整。
第四,把人工校准设计成正式流程。
高风险业务里,Human-in-the-loop 不是妥协,而是系统安全与持续学习的一部分。
第五,真正的护城河是企业自己的数据与规则。
模型能力会越来越通用,但历史报价、工艺经验、供应商关系和成本逻辑无法从公共模型里直接获得。
十、FDE 交付的不是一个价格,而是一条可控的报价链
回头看,项目 9 的价值并不是把报价员换成一个聊天机器人。
它重新连接了:
text客户非标需求
→ 图纸理解
→ 标准数据
→ 物料与工艺
→ 企业成本
→ 人工确认
→ 对外报价
这也是企业 AI 落地里非常重要的一条原则:
不要让大模型直接替企业做最终决定。先让它把过去必须靠人理解的非结构化输入,变成企业规则能够可靠处理的数据。
真正成熟的 AI 系统,不是看起来什么都会,而是清楚知道哪些事必须交还给数据、规则和人。
关注「MarvinTalk / 码文说」,一起研究 AI 如何真正进入企业交付现场。