

我在分析 AWS 到 Azure 的 NATS 出网流量时,遇到了一个方案:在 Azure 部署一个 NATS 叶子节点,让业务服务连接它,再由它连接 AWS 的中心节点。
压测报告显示,这条节点间连接可以使用 S2 压缩,减少约八成流量。但理解这个方案之前,有几个更基础的问题:Azure 服务还用中心节点的用户名吗?叶子节点会自动接收所有消息吗?原来的 JetStream 拉取消费还能直接使用吗?
先记住三个答案:业务客户端在叶子节点上认证;叶子节点另用一个身份登录中心节点;消息按照订阅和权限跨节点传递。 消息是否保存、断线后能否补读,则要继续看 JetStream 的配置。
本文以 2026-10-13 的流量分析记录为案例,版本边界是 nats-server 2.10.29。案例中的实测数字来自该记录;下面的配置是帮助理解机制的示例,没有在生产环境执行。
1. 加一个叶子节点,连接到底变成什么样?
案例中,Azure 服务直接连接 AWS 中心节点的客户端端口 4222,读取订单状态批次。改用叶子节点后,Azure 服务连接本区域的 NATS,Azure NATS 再主动连接中心节点的叶子端口 7422。
NATS 文档把被连接的一侧称为 hub,把主动建立这条连接的一侧称为 leaf。本文沿用这两个名字,避免把 hub 误解成数据库式的主节点。叶子节点本身运行的也是 nats-server,能够接收本地客户端的发布和订阅。
注意图中间的蓝色链路:S2 压缩发生在跨云连接上。下方业务服务收到的仍是原来的 JSON。
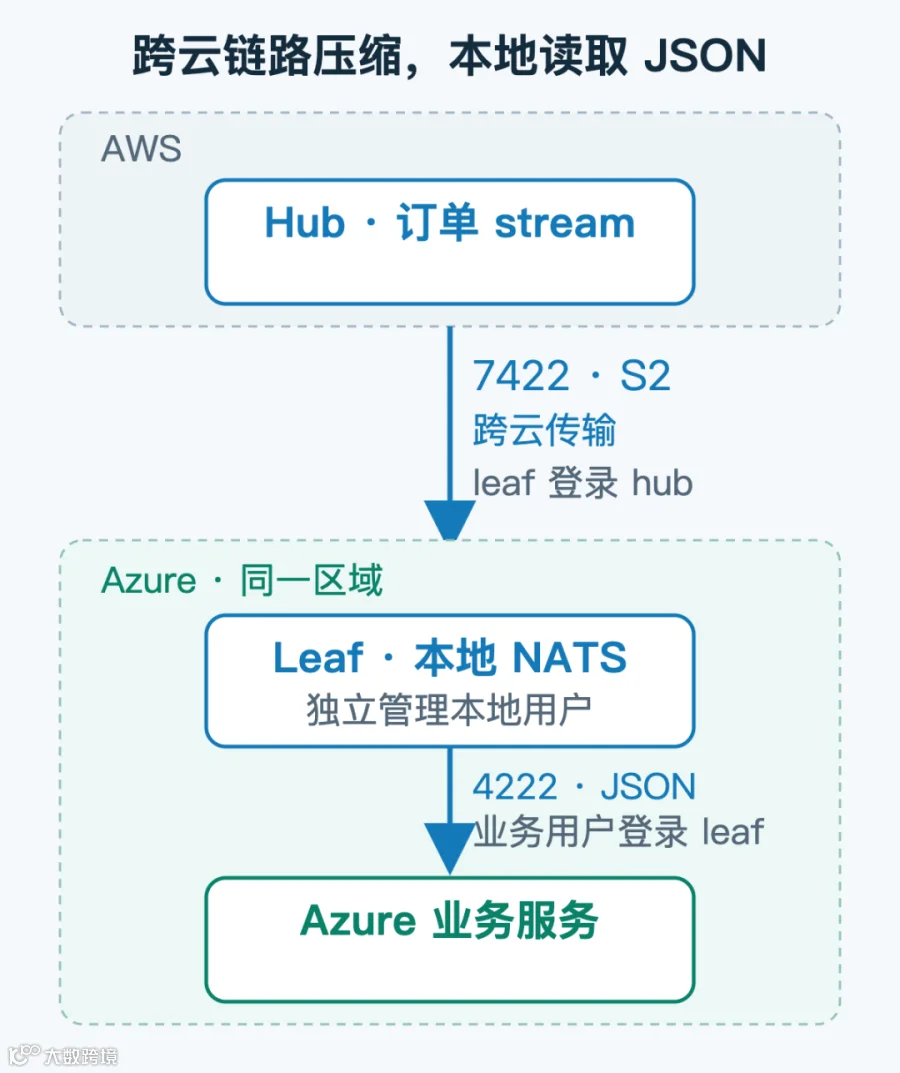
S2 压缩跨云的节点连接,Azure 服务仍通过本地客户端连接读取 JSON。
叶子节点没有自动加入 hub 的 JetStream 副本组,也不会自动成为所有 stream 的备份。它首先解决的是两个 NATS 系统之间的消息通路。如果还需要本地存储,要另外开启并配置 JetStream。
报告中的两个 Azure 读者延迟差异很大,因此建议每个区域部署一个 leaf。这样业务服务到 leaf 的连接留在本区域。如果两个区域共用一个 leaf,远端区域仍然要经过另一段跨区域链路。
2. 用户认证:业务用户和 leaf 登录用户是两回事
假设 Azure 有一个订单服务。它连接本地 leaf 时使用 azure_reader;leaf 连接 hub 时使用 leaf_azure_jpe。
这两次登录由不同的服务器处理:
业务服务 → leaf: leaf 检查
azure_reader的凭据和本地权限。leaf → hub: hub 检查
leaf_azure_jpe的凭据和连接权限。
hub 不会因为建立了 leaf 连接,就把 authorization.users 自动复制过去。你可以在两边配置同名用户,但这是自己的配置选择;同名不代表共享配置,也不代表密码会同步。
因此,报告中“Azure leaf 使用现有的 leaf_171 登录”,指的是复用节点间连接的凭据。Azure 业务服务无需拿到这个密码,也无需改名为 leaf_171。本地业务用户仍由 Azure leaf 管理。
为什么需要两层权限?
leaf 上的业务权限决定:这个本地服务能发布和订阅什么。
hub 上的 leaf 连接权限决定:整条桥接连接能把什么带进来、带出去。从 hub 看 leaf 的身份,publish 对应 leaf 向 hub 发消息,subscribe 对应 leaf 从 hub 接收消息。本地服务有权订阅某个 subject,也不能绕过桥接连接的限制。
对于报告里的推送方案,跨云连接至少要能接收指定的投递 subject,并向 hub 发送 ACK 和流控回复。将来如果增加拉取消费,还需要相关 JetStream API 和回复 subject;不能只放行业务 subject 就认为配置完整。
hub 通常看到的是 leaf 连接,而不是 leaf 后面的每个本地客户端连接。这也是为什么 hub 侧权限需要限制整条连接,而本地 leaf 仍要管理业务用户。
Account 又是什么?
NATS 的 account 是 subject 的隔离空间,user 是这个空间里的访问身份。两个 account 中即使都有 orders.open,也不会仅凭名字相同就互通。
leaf 的一个 remote 配置,把本地的一个 account 与 hub 上登录身份所属的 account 接起来。remotes[].account 选的是本地 account,不是替 hub 选择 account。两端 account 的名称不要求一致,关键是连接如何绑定。
报告中的临时方案使用默认 $G account。它便于理解,但不自动提供业务隔离。若 leaf 使用权限很大的 leaf_171,本地权限配置就尤其重要。
3. 默认转发全部消息吗?看订阅,而不是列出所有 stream
先区分两个名称:
Subject: 消息的路由地址,例如
raw.order_statuses.batched.dev。Stream: JetStream 中保存消息的对象,例如
STREAM_raw_order_statuses_batched_dev。
客户端做普通订阅时,订阅的是 subject。leaf 不会扫描 hub 的 stream 列表,再把全部内容搬回来。
NATS 使用“订阅兴趣”来决定路由。这里的兴趣只是一个技术词:对端有订阅者需要这个 subject。 订阅信息跨连接传播后,匹配的消息才沿连接过去。
下面用较短的 orders.open 举例。顺着蓝色路径从上往下读:先传播订阅,再传输匹配消息;右侧灰色分支没有对应订阅。
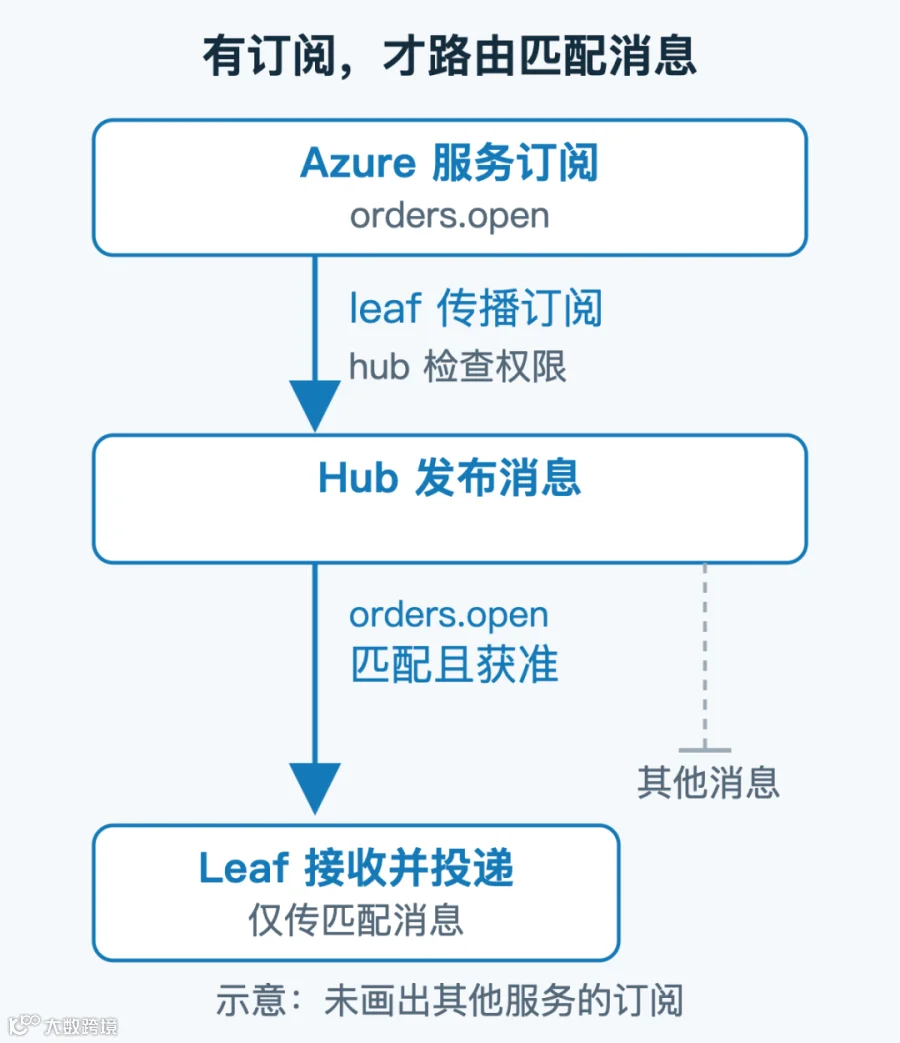
本地订阅先传到 hub,只有匹配且获准的消息才进入 leaf。
对配置的影响是:
建立 leaf 连接时,不需要逐一写出所有业务 subject 的转发规则。
业务服务订阅新的 subject 后,只要 account 绑定正确、权限允许,路由会自动跟随订阅变化。
orders.*匹配一个层级,orders.>匹配其后的一个或多个层级。宽泛订阅会扩大需要接收的流量。允许访问所有 subject,不等于当前正在传输所有消息。权限决定可以传什么,订阅决定此刻需要什么。
实际订阅者也可能是另一个服务,或者本地 JetStream stream。配置一个覆盖很广的本地 stream,会产生相应的订阅兴趣,即使当前没有业务客户端读取它。
所以可以自动转发,也可以设置限制。常见限制包括 hub 登录用户的 subject 权限,以及 leaf remote 的 deny_imports、deny_exports。这些都是 subject 级规则。
它们不能筛选 JSON 内部的 status 字段。 如果同一个 subject 的批次同时包含 open、canceled 和 filled,leaf 不能只凭订阅过滤留下 filled。要获得这种节省,需要生产者或中间服务生成新的过滤 subject。
4. 为什么增加 leaf 就能压缩,业务代码却不用解压?
在案例版本中,普通客户端连接没有这套 S2 压缩功能,leaf 连接有。因此 Azure 业务服务直接连接 hub,无法通过一个客户端参数获得同样的压缩收益。
加入 leaf 后,hub 将节点连接上的数据压缩,Azure leaf 解压,再按普通客户端协议投递。JSON 没有变成 Protobuf,stream 保存的消息也没有因链路压缩而变小。
这解释了方案 A 的收益范围:减少跨云链路字节数,保留业务消息格式。 报告用真实 2.10.29 服务器测得:48.9 MB 业务负载对应约 10.6 MB 网络发送量,减少约 78%。更高的模拟负载结果约为 82%;不能把模拟结果当作每条生产连接的固定收益。
为什么只在 Azure leaf 上写 s2_better 还不够?
压缩涉及双方各自的发送方向。案例里最贵的方向是 hub → Azure。报告测试中,leaf 请求 s2_better,但 hub 仍按自己的 s2_auto 策略发送,低延迟连接保持 s2_uncompressed。
s2_auto 的默认阈值为 [10ms, 50ms, 100ms]。低于 10 ms 不压缩。东京附近的 Azure 连接虽然跨公网,RTT 只有约 2.4 ms,因此自动模式不一定解决账单问题。
报告推荐的配置是:
# hub:现有 leafnodes 块中的一项设置
compression: accept

# Azure leaf:对应 remotes 条目中的一项设置
compression: s2_better
accept 让 hub 接受对端选择的模式。报告在这个组合下观察到 s2_better。验证时要检查实际协商结果,而不仅是配置文件里有没有这一行。
S2 也不替代 TLS。压缩减少字节数,TLS 保护链路上的数据和凭据。公网正式部署应分别配置和验证这两项能力。
5. 原来的 JetStream 拉取消费,为何不能只换连接地址?
普通订阅和 JetStream 消费做的事情不同。
普通订阅接收匹配 subject 上正在投递的消息。JetStream 消费还要访问 stream 和 consumer,发出拉取请求,处理 ACK、超时和重投。因此,“业务 subject 能穿过 leaf”不等于“JetStream API 已经能穿过 leaf”。
报告的本地测试中,客户端通过 leaf 调用 JetStream API 得到 no responders available。这表示当时没有可达的 API 响应者;它不表示 hub 的订单 stream 已经不存在。
Domain 解决的是 API 寻址问题
默认 JetStream API 使用 JS.API.>。当 hub 和 leaf 各自运行独立 JetStream 时,需要知道请求究竟交给哪一侧。domain 让它们具有明确的 API 名称,例如 JS.hub.API.> 和 $JS.azure_jpe.API.>。
NATS 对跨 leaf 的默认 JetStream API 有专门的隔离和扩展规则。domain、系统 account 的连接方式及 JetStream 模式都会影响结果。因此,报告中的“没有 domain 就不能调用”应理解为这次配置和测试的结论,不能当作所有 leaf 拓扑的完整规则。
domain 也不复制消息。它让客户端能够明确访问某套 JetStream;复制数据还需要配置 mirror 或 source。
在这次迁移中,有三种接法。它们共享 leaf 压缩能力,但可靠性和流量行为不同。
A1:直接订阅原始 subject
Azure 服务通过 leaf 普通订阅 raw.order_statuses.batched.dev,接收连接正常期间的新消息。
这条路径简单,但普通订阅没有 consumer 进度。断线时错过的消息,不会因为 hub 保存过它们而自动补发。只接受实时更新、允许缺失的服务,可以考虑这条路径。
同一 leaf 后多个普通订阅者接收同一条消息时,通常由 leaf 本地分发,跨云链路无需为每个本地订阅者发送一份。这个结论以同一 subject 的普通广播订阅为前提;队列订阅有自己的负载分配规则。
A2:hub 保留 durable push consumer,leaf 只传递投递和 ACK
报告推荐从这里开始:stream 和持久 consumer 都留在 hub。hub 上提前创建一个 push consumer,把消息发送到 azure.jpe.order_statuses。Azure 服务通过 leaf 普通订阅这个投递 subject。
这里有两个 subject,不能混淆:原始 subject 接收生产者发布;投递 subject 承载这个 consumer 发给 Azure 的消息。
图中上方的 hub 保存进度,下方的 Azure 服务完成处理。蓝色箭头传消息,绿色回路把确认送回 hub。
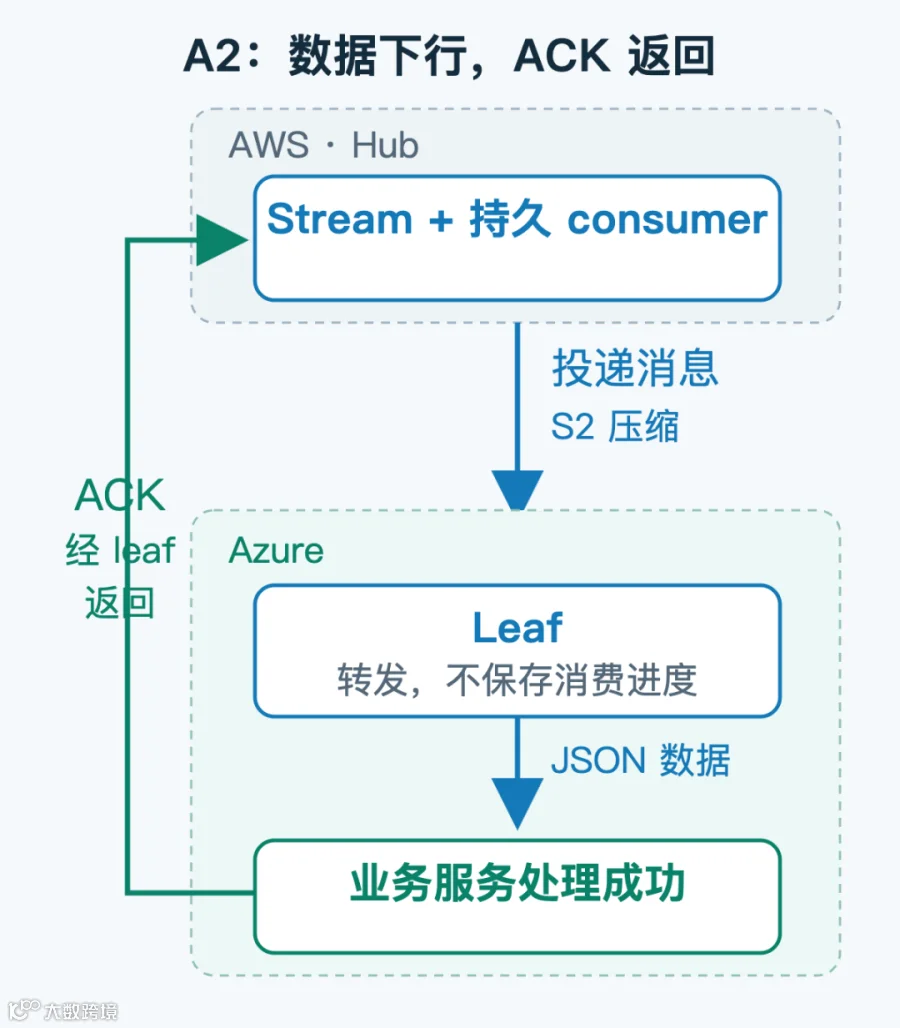
A2 的持久状态在 hub,leaf 转发数据,业务服务把 ACK 沿原路送回。
处理成功后,服务向数据消息携带的回复 subject 发 ACK。hub 更新消费进度,未按时确认的消息可能重投。因此,业务处理需要考虑重复消息。
Durable 是进度可保留,不是无限期保留数据。 如果断线时间超过 hub 的保留窗口,旧消息已被删除,就无法补读。报告估计当前保留窗口约 44 分钟,迁移计划必须把这一限制算进去。
启用 flow control 和 heartbeat 时,客户端还需要区分数据与控制消息。流控请求需要回复;heartbeat 用于监测链路和消费状态,有些心跳还携带停滞恢复信息。普通 Subscribe 不会自动获得完整的 JetStream 消费管理行为,不能把每个收到的包都交给 JSON 解码器。
报告提到调用 msg.Ack() 的测试已经成功。这支持它使用的版本和接法;正式实现仍应验证 SDK 的 ACK 行为、重连后的订阅恢复,以及控制消息处理。本文不把几行伪代码当作完整消费实现。
还要注意:多个服务若需要各自独立进度,需要多个 consumer,也就会产生多份跨云投递。把多个服务放在同一个 push consumer 后面,不会自动获得独立 ACK 进度。队列消费可以分工,但每条消息只由其中一个成员处理。
A3:在 Azure leaf 上保存 mirror,本地创建消费者
如果多个 Azure 服务都需要独立消费同一份完整数据,可以让 leaf 运行自己的 JetStream,再显式创建 hub stream 的 mirror。
hub 向 Azure 同步一份消息,Azure 的多个 consumer 读取本地副本。这样本地消费者数量增加时,通常无需按人数增加 hub 的同一份跨云数据。mirror 断线后可以恢复同步,但前提仍是源端保留了缺失区间的数据。
代价是 Azure 要承担存储、保留策略和运维责任。本地故障也要单独设计恢复方案。mirror 已同步的数据在 hub 链路断开时仍能读取,但它不会凭空得到断线期间尚未同步的新消息。
报告计划为 hub 和 leaf 设置独立 domain,再创建 mirror。这比只放置一个负责转发的 leaf 多了一套持久化系统,也解释了 A3 为什么需要更多配置。
6. 一个小配置,看清用户到底写在哪里
下面仅用于隔离实验环境:示例不启用 TLS、不运行本地 JetStream,也不包含生产级权限设计。CHANGE_ME 是占位符。公网方案需要沿用正式的 TLS、凭据和网络访问控制。
hub 的示例配置:
server_name: hub-demo
listen: "127.0.0.1:4222"

leafnodes {
  listen: "127.0.0.1:7422"
  compression: accept
  authorization {
    user: leaf_link
    password: "CHANGE_ME_LINK"
  }
}
同一机器上 leaf 的示例配置:
server_name: azure-demo
listen: "127.0.0.1:4223"

authorization {
  users: [
    { user: azure_reader, password: "CHANGE_ME_LOCAL" }
  ]
}

leafnodes {
  remotes: [{
    url: "nats://leaf_link:CHANGE_ME_LINK@127.0.0.1:7422"
    compression: s2_better
  }]
}
读这个例子时,沿着两个端口检查:
业务服务连接
4223,使用azure_reader。leaf 连接
7422,使用leaf_link。leaf 配置里的顶层
authorization管本地客户端。hub 配置里的
leafnodes.authorization管入站 leaf 连接。
127.0.0.1 让这个例子只在本机运行。真实跨云部署需要换成相应可达地址,业务客户端端口应按本地网络布局开放。
这个例子可以帮助确认两次认证和普通消息转发。它没有 JetStream stream 或 consumer,所以不能用它证明 A2 的持久消费已经可用。
7. 报告中的“无需重启”,前提到底是什么?
报告记录 hub 已经有 7422 listener 和 leaf_171 登录身份。A2-now 复用这些已有条件,只修改压缩设置,并创建 hub push consumer。
因此,“不需要重启”来自现有部署和所选变更,不是 leaf 功能天然不需要重启。
对于 2.10.29,报告的 reload 测试和对应源码支持以下边界:改变 leaf 压缩配置可以 reload;新增 listener、改变专用 leaf 登录用户或密码,以及新增 hub JetStream domain,不属于这条简单 reload 路径。
报告还测试了给原本无 TLS 的 leaf listener 增加 TLS,需要重启。它与替换已有 TLS 配置所用的证书是不同的变更,不能只看到“证书可 reload”就推断添加 TLS 也可 reload。
这里还有一个权限配置细节:hub 顶层 authorization.users 和 leafnodes.authorization 是不同配置入口。不能因为普通客户端用户可 reload,就认定专用 leaf 用户也可 reload。正式权限配置应使用该版本支持的入口,再用同版本 nats-server -t -c ... 检查。
复用 leaf_171 可以降低首次迁移的配置改动,但多个区域会共享节点间凭据。它应当是有明确后续安排的过渡方案。区域独立身份、TLS 和 domain 可以集中到一个计划窗口处理。
8. 怎样知道方案真的起作用?
验证应分成三件事。
先看连接和权限。 leaf 是否连接到正确的 hub account?业务用户是否能订阅指定投递 subject?ACK 和流控回复是否可以返回?连上端口只证明网络可达。
再看消费可靠性。 A2 需要检查 ACK 进度、待确认数量和重投。主动断开实验链路,恢复后确认能补读,且重复消息不会导致重复业务操作。A3 则需要检查 mirror 同步延迟,以及本地存储和消费进度。
最后看压缩和账单。 检查 hub 的 leafz 中实际连接是否显示 s2_better。报告发现 leafz.out_bytes 统计的是未压缩字节,不能直接拿它计算网络节省。实际网络流量和计费数据才回答“出网少了多少”。
迁移前后还要控制消息量、消费者数量和观察时段,否则业务流量变化会被误算成压缩收益。
对这次 AWS → Azure 的订单状态流,A2 是一个有实测依据的起点:保留 hub 的持久状态,让 leaf 压缩跨云投递。但它依然需要客户端处理投递、ACK 和控制消息,不能只改连接地址。
如果未来同一区域有多个独立读者,A3 的本地 mirror 更值得评估。如果消费者只需要 filled,则应该先讨论新的过滤 subject:减少不需要的数据,可能比改变压缩算法更有效。