
输入一个预训练扩散模型加一组黑盒奖励,输出一个RL微调后的模型。不用EMA调参、不用可微奖励模型,在13B的视频模型上把追平基线的GPU小时压到约十二分之一。论文、代码、权重、项目页已经全部公开。
给扩散模型做在线强化学习微调,现在主流两条路各有毛病:走reverse-process的Flow-GRPO系列信用分配差、效率低;走forward-process的DiffusionNFT效率高,但没有精心调过的EMA off-policy训练就不稳定。
NUS HPC-AI Lab联合快手Kling AI、HKUST推出DiffusionART(Diffusion Reinforcement with Aggregation-First Reward Tilting),
首先制定总体奖励指导方针,然后根据政策变化进行调整。与 DiffusionNFT (EMA) 相比, GPU 运行时间减少了12.02 倍, 训练奖励提高了28.8%。在HunyuanVideo-13B上,VQ:MQ=1:1的奖励权重设定下,追平DiffusionNFT和Flow-GRPO-Fast的末段奖励水平分别只需12.02倍和11.72倍更少的GPU小时,训练奖励高出28.8%和53.0%。同一框架支持文生图、文生视频、图生视频三种任务、六种基线算法,SD3.5-M和HunyuanVideo两个微调后权重已挂Hugging Face。
相关链接
-
论文:https://arxiv.org/abs/2610.12572 -
代码:https://github.com/vanzll/DiffusionART -
主页:https://vanzll.github.io/diffusionart-project/ -
模型权重: -
https://huggingface.co/vanzl/DiffusionART-HunyuanVideo -
https://huggingface.co/vanzl/DiffusionART-SD35M-MultiReward
内容介绍
一句话:给扩散模型(图像和视频都行)接上一个奖励信号,让它按你的偏好继续训练,而且比现有方法便宜一个数量级、稳得多。

与常规扩散RL方案相比,核心特点有三个:
-
一个框架通吃三类任务:T2I、T2V、I2V共用一套训练入口,DiffusionNFT(EMA/on-policy)、Flow-GRPO、Flow-GRPO-Fast、Flow-DPPO、DanceGRPO、ReFL六种算法都能在同一个框架里复现对比,官方把论文配方全部放在configs/paper/下。 -
不需要可微奖励模型:GenEval、PickScore、OCR、CLIPScore、Aesthetic、VideoReward这些黑盒奖励都能直接用,还原生支持pairwise偏好反馈(两两比较给1/0/0.5标签)。 -
对小的rollout组鲁棒:每个prompt只采2个样本(K=2)也能稳定训练,这是它敢说"scalable"的底气。
适用场景:给文生图/文生视频模型做偏好对齐、用美学或OCR等指标定向强化某个能力、以及想复现对比六种扩散RL算法的研究者。
方法概述
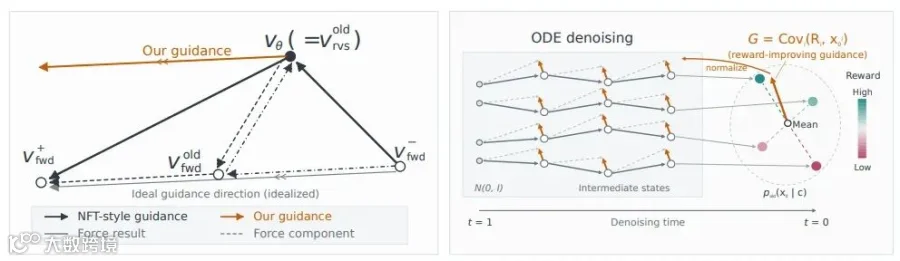
一套机制管"往哪走",一套机制管"别走飞了"。
1. 先找到藏在目标函数里的敌人(一致性力)
论文先证明了一件此前没人说透的事:NFT-style的前向过程RL目标里藏着一个forward-reverse一致性力,正负样本联合训练只能部分抵消它。数学上,这个力等于2g+(2q-1)e,其中g是真正的奖励指引、e是自洽方向——只要正样本概率q不刚好等于0.5,e就在拖后腿。这不是调参能解决的,是目标函数自带的。这个诊断是全文的地基:DiffusionNFT之所以必须靠EMA续命,根子在这里。
2. Aggregation-First Guidance:把K个样本聚合成一条指引
DiffusionART的做法:每个prompt用ODE求解器rollout K个样本,计算奖励与终点潜变量的协方差G(c)=Cov(R,x0)并归一化,然后把这条"奖励改进方向"直接施加到这次rollout经过的所有状态上。思路很像把classifier-free guidance内化进模型——先聚合全部奖励证据,再统一施加指引,从构造上就不存在那个一致性力。不需要反向转移概率,也不需要理想前向速度场。
3. Two-Update Restoration:用第二次更新替代EMA
稳定性靠两次不相交的minibatch更新:第一次只施加指引G(c),第二次在保留指引的同时把速度漂移往rollout策略方向拉回来,配合trust-region掩码(KL散度超阈值的状态直接跳过)。论文给出的一组诊断数字很直观:恢复项的输出力RMS只有指引的1/9.4,但参数梯度范数是指引的4.9倍——小输出误差、大参数修正,这正是EMA隐式在做的事,现在被拆成了显式的第二更新,不再需要调EMA系数。
4. Pairwise:两两比较也能算
DiffusionART-Pairwise把标量奖励换成偏好标签(胜1/负0/平0.5),协方差在数学上等价于"赢家减输家"的平均差值。实测pairwise K=2(每个prompt只采2个视频)用260.8 GPU小时拿到12.235的VQ,标量K=8要891.1 GPU小时才到13.637——约三分之一的成本拿到接近的画质分。
实验结果
文生视频(HunyuanVideo-13B,TA:VQ:MQ=7:2:1)
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| DiffusionART | 8.970 | 4.224 | 2.111 |
三项全第一,比最强基线的VQ和MQ分别高31.4%和57.4%。

左:文生视频;右:图生视频。纵轴是平均训练奖励,横轴是GPU小时。红线(DiffusionART)到达基线末段奖励水平的GPU小时约为基线的1/12到1/13。图为官方数据。
图生视频(Wan2.1-I2V-14B蒸馏版,VQ:MQ=1:1)
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
| DiffusionART | 11.196 | 10.476 |
两项指标都接近翻倍,而且基线在记录范围内已趋于平台期。
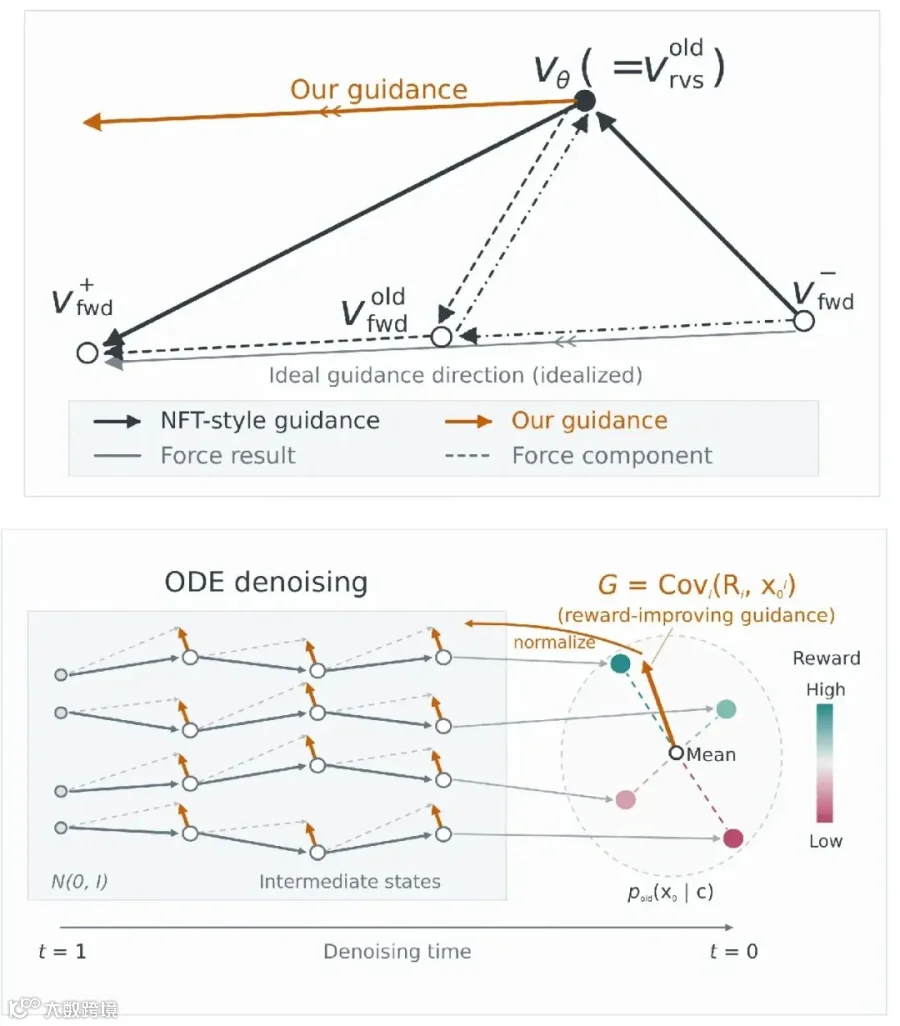 上:NFT式指引与DiffusionART指引的几何对比;下:每个prompt的K个样本聚合为协方差指引G(c)后施加到rollout状态。
省卡账的两种口径
-
到达VQ=5.5:DiffusionART用24步、63.4 GPU小时;DiffusionNFT(EMA)要273步、1401.4 GPU小时——步数11.4倍、GPU小时22.1倍的差距。 -
另一组关掉TA奖励的设定:44.2 GPU小时对250.2和502.5,是5.7倍和11.4倍。 -
摘要口径(末段50步平均奖励):12.02倍和11.72倍,最终平均奖励13.018对10.105和8.510。
同一篇论文里,按不同milestone和奖励权重,倍数在5.7倍到22.1倍之间浮动。引用任何一个数都得带上口径,这一点官方项目页自己也写了"empirical late-stage rewards, not a guarantee of asymptotic convergence"。
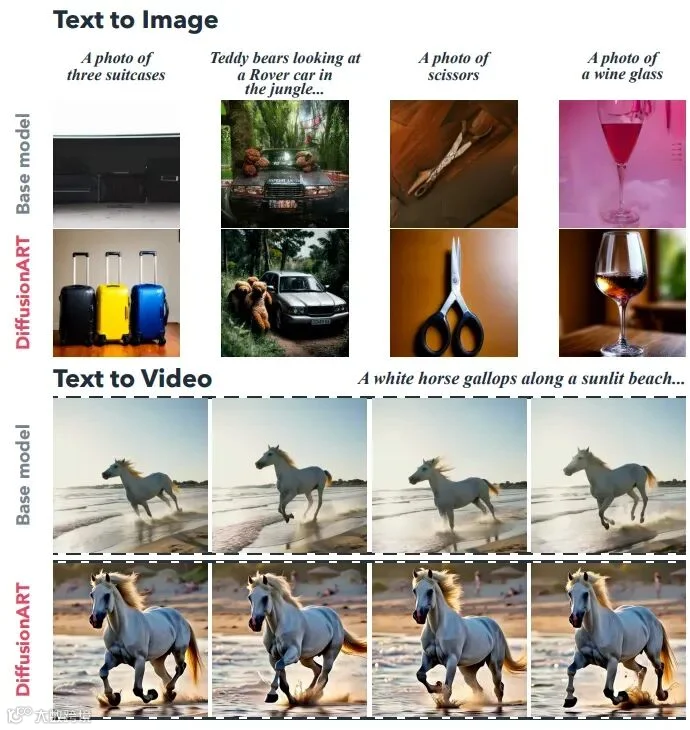
 左列文生图、右列文生视频,均为pre-trained与DiffusionART的同prompt对比。 prompt遵循度与画质提升肉眼可见。
局限与未来方向
首先,所有倍数都是官方自报,没有独立复现;且口径多样(末段平均奖励/到达指定VQ水平/不同奖励权重组合),跨论文直接比较没有意义。 其次,训练门槛不低:视频配方是8卡×4节点起,图像配方8卡1000步。README提供的CPU smoke测试只是4步的装机自检,不代表个人设备能训。 此外,协议要单独说:GitHub仓库至今没有任何license文件被识别,两个HF权重仓都标license:other。想商用先去确认条款,确认不了就当不能商用。 最后,一致性力的分析建立在NFT-style目标上,换别的RL formulation不能直接套用结论。
结论
DiffusionART把扩散模型RL微调里"效率"和"稳定"这对老矛盾拆成了两个可分别处理的组件:聚合指引管方向,显式恢复管稳定。这不是一个小改进,是把一个必须有专家调参的流程变成了开箱可复现的框架。
对于做训练的读者,直接看configs/paper/里的配方,T2I那条8卡就能跑;对于只想用模型的读者,两个微调后权重已经挂HF,直接下载推理即可,不用自己训。风险提示照旧:协议未明确、倍数是厂商自报、视频训练是32卡级的门槛。
扩散模型的对齐成本被打下来之后,下一件事大概是人人都能按自己的审美微调一个视频模型。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~