

大模型正在从"能用"走向"好用"。几乎每个团队都希望把旗舰模型的能力装进自己的业务,但百亿、千亿参数模型带来的推理成本、响应时延和部署门槛,让大量场景停留在试点阶段。模型蒸馏是当下最直接的答案:让强大的教师模型先"做一遍题",再把能力沉淀到小一个量级的学生模型中,用更小的模型换来成本与时延的数量级下降。
今天,阿里云人工智能平台 PAI 模型蒸馏模块正式发布场景化蒸馏新能力:在端到端蒸馏流水线之上,推出一系列开箱即用的场景化蒸馏模板,把蒸馏从"算法专家的手艺活",变成"选一个模板就能开工"的产品化能力。
01
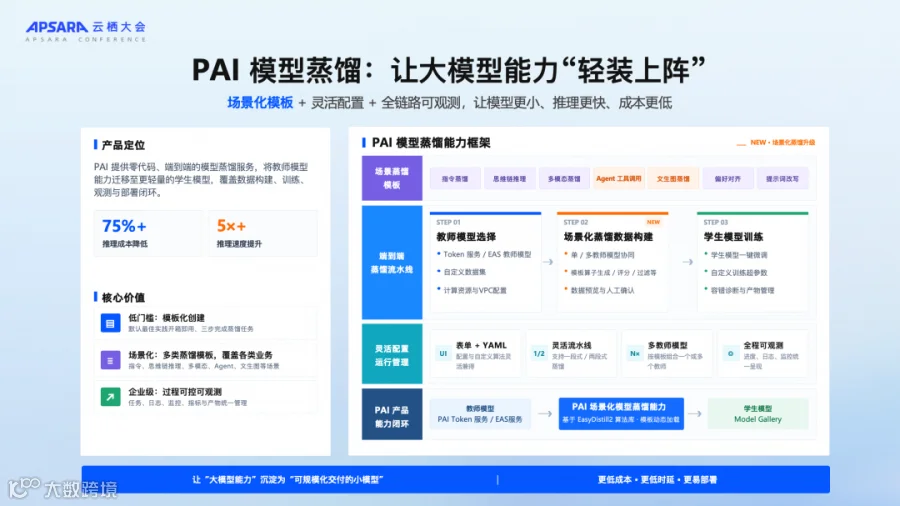
PAI 提供基于自研 EasyDistill2 算法库的零代码、端到端的模型蒸馏服务,将教师模型能力迁移至更轻量的学生模型,覆盖数据构建、训练与部署的完整闭环,全程无需自建任何管线:
教师模型选择:通过 PAI Token 服务直接调用在线教师模型,或接入 PAI-EAS 上自部署的模型服务;
蒸馏数据构建:由教师模型面向目标数据生成高质量响应,自动构建蒸馏训练数据集;
学生模型训练:基于 PAI-Model Gallery 开源模型一键微调,配套容错诊断与产物管理,训好的模型可直接部署上线。
蒸馏后的学生模型在部分场景下可实现推理成本降低 75%+、推理速度提升 5x+。同时,PAI 模型蒸馏提供企业级的过程管理:灵活配置(表单配置 + YAML 算法配置)、一段式/两段式灵活流水线、多教师模型协同,任务进度、日志、监控、指标与产物统一呈现,全流程可管可控。
02
此前 PAI 已提供通用的模型蒸馏管线,通用蒸馏管线的能力毋庸置疑,但痛点在于配置不够灵活:数据怎么合成、怎么评分、怎么过滤,都依赖算法经验。场景化蒸馏的做法,是把 PAI 算法团队沉淀的最佳实践固化为模板。
平台预置一批开箱即用的场景化蒸馏模板。每个模板将「合成 · 生成 · 评估 · 过滤 · 构建」等原子算子编排为端到端流水线,选择场景即可复用最佳实践配置,快速产出 SFT / DPO / 多模态训练数据。
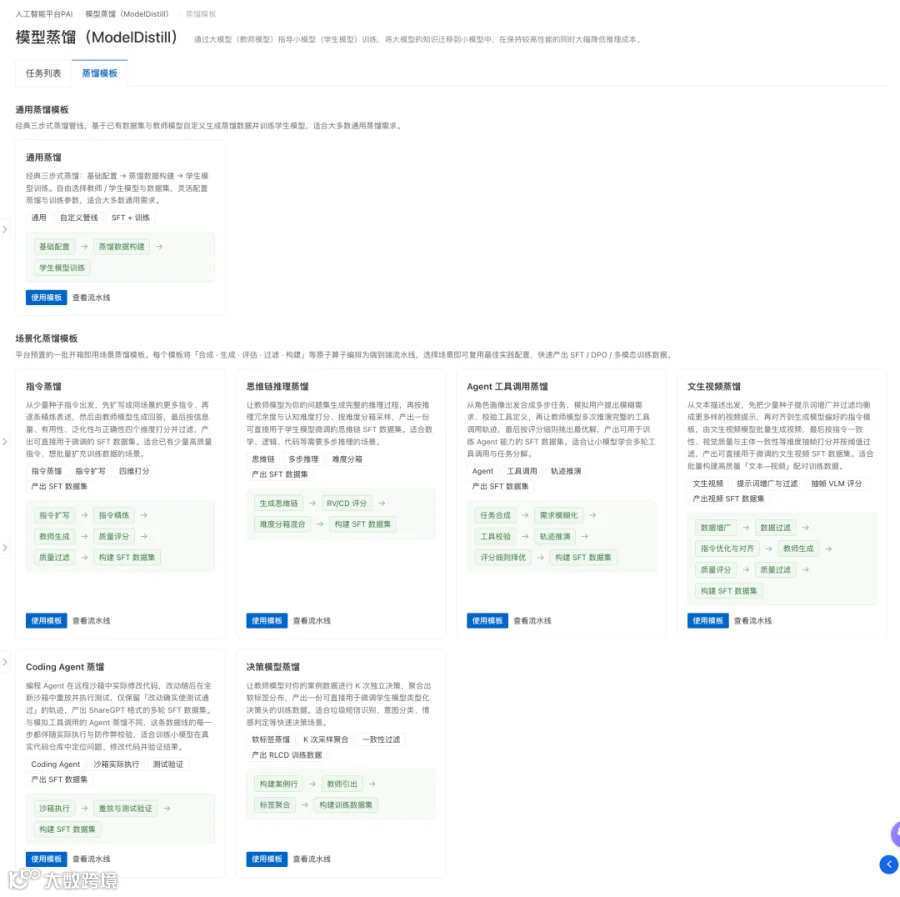
使用时只需三步:选择模板、完成基础配置(教师模型、数据与输出路径)、提交任务。平台即按模板流水线自动完成数据合成、生成、评分、过滤与构建,并可无缝衔接学生模型训练。每个模板自带最佳实践默认的算法配置:新手直接默认配置开箱即用,进阶用户可深度定制全部算法参数;各阶段中间产物均保存可查,数据质量一目了然。
首批上线的场景模板覆盖6大高频场景:

此外,经典的通用蒸馏模板依然保留:经典三步式蒸馏管线,基于已有数据集与教师模型自定义生成蒸馏数据并训练学生模型,适合大多数通用蒸馏需求。
值得一提的是,我们在陆续上架更多场景的蒸馏模板,覆盖各类业务需求。
03
场景化模板不只是"流程封装"。流水线内置的细粒度评估与过滤策略(LLM-as-a-Judge 定量评测、真实沙箱验证等),让蒸馏数据"对且精"而不是"多就好",从而带来效果与成本的双重收益。以下为三类场景的实测数据,可看出 PAI 模型蒸馏的方案优势:
推理场景:以 Qwen2.5-3B 为学生模型、Qwen3.5-Plus 为教师模型,思维链推理蒸馏流水线(生成 → RV/CD 评分 → 筛选)对比标准的单阶段蒸馏:在GSM8K,MATH等典型benchmark数据集上,在保持准确率基本一致的前提下,数据构建 Token 消耗节省约 29%~35%,训练数据量节省 70%~80%。
Agent / Coding 场景:在达到相同测试准确率的前提下,得益于数据质量的提升,Coding Agent 蒸馏流水线所需训练数据 Token 仅为标准蒸馏方案的约 1/11(11.56M vs 129.43M,降低约 91.1%),训练轨迹从 500 条降至 100 条;Coding 难题解决率从 56.1% 提升至 91.1%。更值得一提的是,随着优质轨迹持续积累,测试准确率还可进一步提升。
AIGC 文生视频场景:生成前先做质量打分与语义去重,筛除低潜力、冗余的种子数据,省下昂贵的视频生成调用;管线合成与增强的 caption 又让更多生成数据可用于训练。最终在达到相同评测指标的前提下,综合视频生成调用成本可降低 37%(API调用次数)。
降本的背后,是流水线中一系列工程化的"精打细算":在线监督教师模型的执行状态,发现反复试错、长时间无进展即提醒纠偏乃至及时止损;难题自动切换多教师、换思路继续探索;所有轨迹经真实沙箱验证,只保留"做对且有用"的关键步骤。每一分 Token,都花在刀刃上。
04
模型蒸馏的价值,在于让"大模型能力"沉淀为"可规模化交付的小模型"——更低成本、更低时延、更易部署。场景化蒸馏现已在 PAI 控制台全面上线:登录人工智能平台 PAI 控制台,进入模型蒸馏模块,选择一个场景模板,让你的业务用上"轻装上阵"的大模型能力。
/ END /
点击“阅读原文”快速体验更多关于大数据&AI产品解决方案