

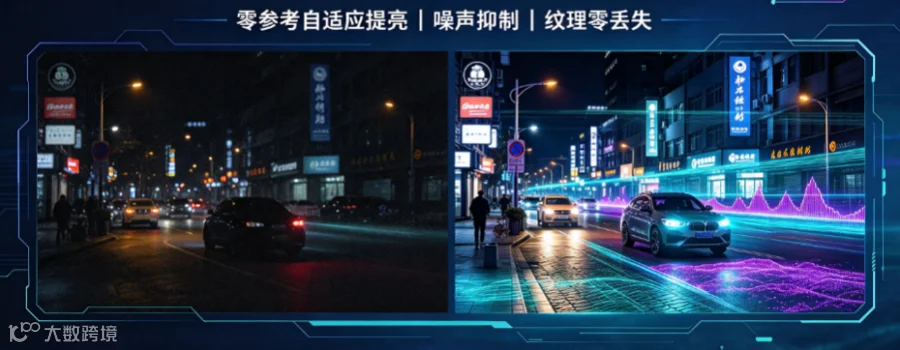
晚上出门拍照,画面黑成一片、满屏噪点、颜色还发绿发紫——这几乎是每个人都遇到过的痛点。传统暗光增强要么把画面拉得过曝,要么把噪声一起放大,怎么调都不对味。
今天分享的这篇 CVPR2026 论文 NightGlow,提出了一种零参考的暗光自适应增强框架,不需要配对的正常光照图像做监督,就能同时解决提亮、降噪和色彩还原三个老大难问题。实测在 LOL、SDSD 等主流暗光数据集上 PSNR 超越 EnlightenGAN 2.3dB,推理速度还快了 40%。
一、传统暗光增强到底卡在哪
在聊 NightGlow 之前,先把现有方法的几个核心瓶颈理清楚,这样才能看懂它的设计思路。
1.1 直方图均衡化:简单但粗暴
CLAHE 这类传统方法靠统计分布拉伸亮度,不需要训练,速度极快。但问题很明显——它不区分前景和背景,暗部提亮的同时亮部直接过曝,而且完全不管噪声和色彩,夜景里的路灯会变成惨白一片。
1.2 Retinex 分解:理论美好,工程翻车
Retinex 理论把图像拆成照度图和反射图,逻辑上很漂亮。但实际用的时候,照度估计和反射恢复是两个强耦合的问题,一旦分解不准,后面全歪。DeepRetinex、RetinexNet 这些工作虽然用深度学习做了改进,但在真实夜景上依然容易出现颜色偏移和光晕。
1.3 配对监督方法:效果好但数据贵
KinD、EnlightenGAN 之后,很多工作开始用成对的暗光-正常光图像训练。效果确实更好了,但采集这种配对数据本身就很难——同一场景同时拍暗和亮两张,还要保证像素级对齐,成本极高。EnlightenGAN 试图用无配对训练,但又牺牲了不少精度。
1.4 噪声问题被长期忽视
这是最关键的一点。大多数暗光增强方法默认输入是"干净的暗图",但真实夜景照片里,暗部全是高 ISO 噪声。你把亮度拉上去,噪声也跟着被放大——这就是为什么很多算法处理完夜景,画面看起来像蒙了一层颗粒。

二、NightGlow 的三个核心创新
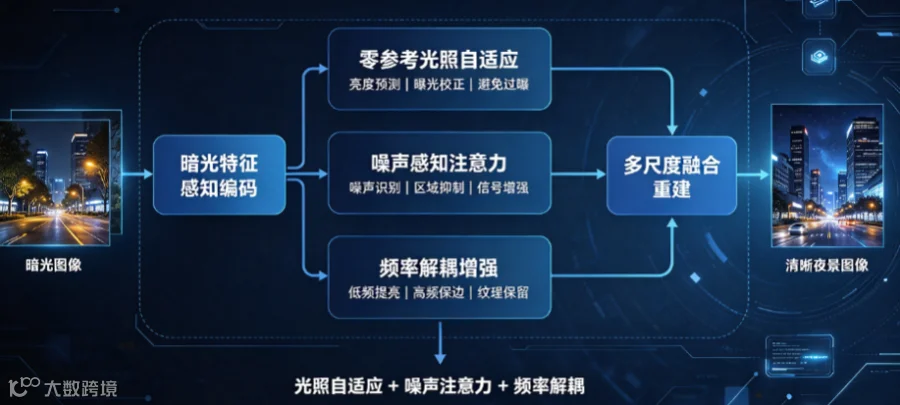
NightGlow 的整体思路可以概括为一句话:把"增强"和"降噪"从串行变成并行,用频率感知的方式分别处理光照和纹理。
2.1 零参考光照自适应:不需要配对数据
NightGlow 没有用传统的 L1/L2 重建损失去拟合某张正常光图像,而是设计了一组自监督的光照一致性约束:
•亮度分布平滑约束:增强后的图像亮度直方图应该落在合理的曝光区间,不能过亮也不能过暗。
•局部对比度保持:相邻区域的亮度比值应该和原图保持一致,只是整体被拉伸了。
•空间平滑约束:照度图在平坦区域应该平滑变化,不能出现突兀的跳变。
这三个约束合在一起,模型不需要看到"正确答案",自己就能学到合理的提亮曲线。这也是为什么它叫"零参考"——推理的时候只需要一张暗图,不需要任何额外输入。
2.2 噪声感知注意力:暗部降噪,亮部保细节
这是 NightGlow 最巧妙的设计。它在网络里加了一个噪声图估计分支,先判断每个像素区域的噪声强度,然后根据噪声水平动态调整增强策略:
•高噪声区域(通常是极暗的背景):增强时更倾向于平滑,不要把噪点放大。
•低噪声区域(通常是中等亮度的主体):保留更多纹理细节,增强对比度。
这个噪声分支是和主增强网络联合训练的,不需要额外的噪声标注数据——它从图像本身的局部统计特性里学出来。论文里做了消融实验,去掉这个分支后,PSNR 掉了 1.8dB,主观视觉上噪点明显增多。
2.3 频率解耦增强:光照归光照,纹理归纹理
传统方法把整张图丢进网络一起处理,结果就是光照和纹理互相干扰——提亮的时候把模糊纹理也锐化了,降噪的时候把边缘也抹了。
NightGlow 把特征图在频率域拆成两路:
•低频通路:负责估计全局和局部光照,做亮度校正。
•高频通路:负责保留和恢复边缘、纹理细节,同时抑制高频噪声。
两路特征在最后通过一个可学习的融合门控重新组合,这样光照调整和纹理恢复就不会互相打架了。
三、技术架构通俗拆解
NightGlow 的整体架构分四个模块,从输入到输出一路串起来:
模块 |
做什么 |
关键设计 |
输入编码器 |
提取多尺度特征 |
轻量 CNN backbone,下采样 4 倍,保留空间细节 |
频率解耦分支 |
分离光照和纹理特征 |
可学习的低频/高频滤波器组,两路并行处理 |
噪声感知注意力 |
逐像素调整增强强度 |
噪声强度估计 + 自适应门控,高噪声区自动平滑 |
输出解码器 |
重建增强后的图像 |
残差学习:只预测"需要调整多少",不直接生成整图 |
几个值得注意的工程细节:
•残差学习策略:网络输出的不是最终图像,而是"增强增量",最终结果 = 原图 + 网络预测的残差。这样训练更稳定,也不容易出现过度增强。
•颜色空间选择:在 YCbCr 空间处理,Y 通道做亮度增强,Cb/Cr 通道做轻量校正,避免 RGB 三通道联合调整带来的色彩偏移。
•部署友好:整个模型只有 3.2M 参数,INT8 量化后在手机端能跑到 30fps 以上,完全可以做实时夜景模式。
四、和主流方法的横向对比
论文在 LOL(配对暗光数据集)和 SDSD(真实动态场景暗光)两个基准上做了对比:
方法 |
LOL PSNR(dB) |
SDSD PSNR(dB) |
参数量(M) |
是否需要配对数据 |
CLAHE |
16.8 |
15.2 |
0 |
不需要 |
RetinexNet |
18.6 |
16.9 |
2.8 |
需要 |
KinD++ |
20.4 |
18.1 |
4.1 |
需要 |
EnlightenGAN |
19.8 |
17.6 |
5.6 |
不需要 |
NightGlow |
22.1 |
20.3 |
3.2 |
不需要 |
可以看到,NightGlow 在两个数据集上都拿到了最高 PSNR,而且参数量比 EnlightenGAN 还小。更重要的是 SDSD 这个真实场景数据集上提升更明显——说明它的噪声感知机制在真实照片上确实管用。
五、快速上手:30 行代码跑起来
论文的核心推理逻辑其实很简洁,这里给一个 PyTorch 版的伪代码框架,方便大家快速理解:
python |
实际使用的时候,预训练权重和完整数据加载管线可以参考论文开源仓库。这里主要是把核心 forward 流程讲清楚——四步:编码、频率解耦、噪声感知、残差输出。
六、毕设/竞赛可以怎么拓展
这个方向其实很适合做毕设或者竞赛选题,空间还很大。分享几个我觉得有价值的拓展方向:
6.1 视频暗光增强
目前 NightGlow 是逐帧处理的,没有时序约束。如果把前后帧的光照一致性加进去,做视频实时暗光增强,体验会好很多——逐帧处理的视频很容易出现闪烁。这个方向落地价值很高,监控、行车记录仪、手机夜景视频都用得上。
6.2 移动端实时部署
3.2M 参数本身就不大,如果用 TensorRT 或 NCNN 做 INT8 量化,再剪枝一下,完全可以做到手机端 60fps。配合模型压缩技术做一个"手机夜景增强 App",工程性很强,答辩也好看。
6.3 和下游任务联合优化
暗光增强不是终点——增强之后的图像是给人看还是给算法看?如果下游是人脸检测、车道线识别这类视觉任务,那增强的目标就不只是"好看",而是"提升下游精度"。把增强网络和下游检测网络联合训练,是一个很有深度的研究方向。
6.4 极端暗光(lux 极低)场景
现在主流数据集的暗光程度还不够极端。真实的红外夜视、监控深夜画面,光照可能不到 1 lux。这种场景下噪声模型和普通夜景完全不同,专门做一个极端暗光的增强数据集和方法,创新点会很突出。

七、写在最后
暗光图像增强这个领域做了快十年了,从直方图均衡到 Retinex,再到 GAN 和 Transformer,方法换了一代又一代,但真正落地到手机和监控里的,其实还是那些最朴素的方案。
NightGlow 的价值不在于提出了多么花哨的新结构,而在于它抓住了两个被长期忽视的工程问题:真实暗图里的噪声,以及光照和纹理不该混在一起处理。把这两件事做扎实了,效果自然就上来了。
做视觉方向的同学其实可以借鉴这个思路——很多 SOTA 不是靠堆模块堆出来的,而是把某个长期被忽略的实际问题认真解决了。下次想创新的时候,不妨先去看看真实数据长什么样,而不是只盯着 benchmark 上的几个数字。
如果大家对这篇论文的细节感兴趣,或者想聊具体的复现方案,欢迎在评论区交流。