

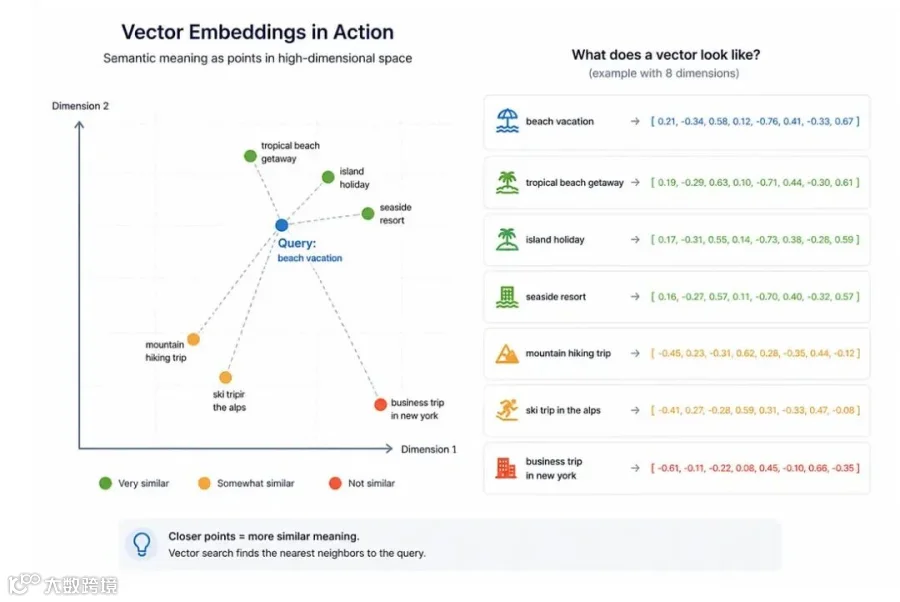
过去几年,embeddings 和向量搜索在 Booking.com 的 ML 和 GenAI 系统中从几个实验用例,长成了驱动用户体验的共享基础设施。相似性搜索、语义过滤、RAG,都跑在上面。
它不再是后端实现细节了。用户能感知到快慢,而快慢背后,取决于检索到的上下文有多丰富。这直接决定推荐和个性化体验的质量。
选什么向量数据库,跟选主存储或消息队列一样,是一个基础设施级别的决策。要可预测,要能扩展。
随着接入团队越来越多,需求也变得五花八门。有的要 hybrid search,有的要多向量支持,有的单纯要更高 RPS。当这些需求堆到一定程度,Booking.com 决定重新评估:现有方案还能撑多久?
起点:OpenSearch
一开始选 OpenSearch 加向量插件,完全出于务实考虑。公司内部已经用 OpenSearch,AWS 上有托管,Terraform 能直接配。不需要引入新技术,没有额外运维负担,能快速上线第一批 embedding 用例。
这套方案在早期验证阶段够用。问题是,当用例和规模都上来以后,就不够了。
什么时候开始疼
几个维度同时施压。数据集膨胀到上亿条 embeddings;查询从单纯的 KNN 变成向量搜索叠加元数据过滤;并发量增大;用户侧延迟要求变严。
OpenSearch 开始吃力。要维持可接受的性能,得不停调参,集群越扩越大,运维负担和成本都显著上升。
没到"彻底坏了"的程度,但变得更难运维、更慢演进、更贵。团队花在管理 AWS OpenSearch 基础设施上的时间,超过了花在开发上层 AI 用例上的时间。
为什么不信任公开 benchmark
开始调研替代方案时,团队看了不少公开 benchmark 和对比文章。初看有帮助,细看发现问题:数据集小、工作负载是合成的、并发低。跟 Booking.com 的生产环境差距太大。
Booking.com 的实际场景:海量 embedding 数据集、向量搜索叠加过滤、高并发。在这个尺度下,延迟或资源效率(达到目标 recall 和尾延迟所需的 CPU、内存、集群规模)的微小差异,对用户体验和成本都有乘数效应。
于是团队决定不依赖外部基准,自己设计一套尽可能复刻生产环境的评估。目标不是找出 benchmark 数字最漂亮的系统,而是找到在真实条件下行为最可预测的那个。

评估设计
数据集
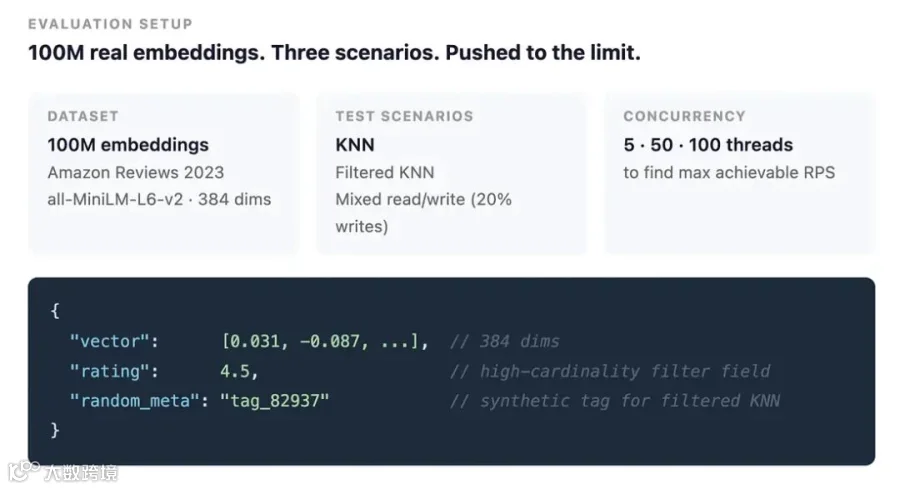
基于 Amazon Reviews 2023 数据集构建了 1 亿条 embeddings。涵盖 Electronics、Baby Products、Home & Kitchen 等多个品类的数百万条评论。
向量化用的是 all-MiniLM-L6-v2 模型,因为它在 Booking.com 内部模型目录中已有,能代表生产环境实际使用的模型。它在 embedding 质量和推理速度之间取得了不错的平衡,足够支撑这个规模的数据集生成。
每条记录还附带了评分和自定义标签等元数据,用来测试过滤条件下的 KNN 搜索性能。
三种工作负载
纯 KNN 搜索:在整个 1 亿条数据集上做近似 K 近邻搜索。两个系统都调到约 0.99 的 recall,确保延迟和吞吐的差异反映的是系统效率,不是检索质量。
带过滤的 KNN 搜索:向量相似度搜索叠加元数据过滤(评分范围、品类、高基数标签)。这更接近真实使用场景。过滤逻辑先通过元数据缩小候选集,再在缩小后的空间里跑 ANN 并做向量排序。
混合读写:在搜索请求之外持续注入约 20% 的写入操作,模拟实时更新。采用 closed-loop 模式,每个客户端收到响应后立即发下一个请求。这能测出查询延迟在并发写入压力下如何变化。
压测维度
并发从 5 线程递增到 50 再到 100。更高的并发自然推高吞吐,把系统逼向饱和。所有测试都在完整的 1 亿向量数据集上执行,避免小数据集的偏差。
每个场景都记录了单请求延迟、总吞吐、资源利用率和稳定性。尤其关注 P99 尾延迟,因为它最直接反映用户体验。
召回率校验
因为 ANN 本身就是近似算法,团队要确认性能差异不是因为返回了更差的结果。做法是从索引中随机抽样约 200 万条向量作为查询,检查查询向量自身是否出现在预期 top-k 最近邻中。两个系统都调参到约 99% recall,确保对比的是系统效率本身。
差距不在索引,在存储
测试结果清晰说明了一点,但原因值得多解释一层。
Connor Shorten(Weaviate 的开发者关系负责人)在引述这个测试时,指出了一个经常被忽略的差异。Weaviate 的索引和存储引擎是一起设计的。HNSW 图驻留在内存,通过追加日志做持久化;对象和过滤器存储在自定义 LSM 存储里。过滤时从 LSM 生成位图,直接引导 HNSW 的搜索路径(这叫 ACORN),写入只是廉价追加。HFresh 机制更进了一步,向量簇直接放在 LSM 存储中,索引在后台自我调整,不需要全量重建。
OpenSearch 的底子是另一套东西。它是基于段的搜索引擎,每个段独立建图,查询时扫描所有段,合并时重建图。索引是一层附加功能,底下的存储引擎不会主动配合它。写入产生新段、查询横跨多段、合并触发重建,负载一高,延迟曲线就开始翘。
这跟 Booking.com 测出来的现象完全吻合。OpenSearch 在低并发下表现尚可,但并发和写入压力一上来,延迟急剧恶化。Weaviate 几乎是一条直线。
数据
P99 延迟对比(越低越好):
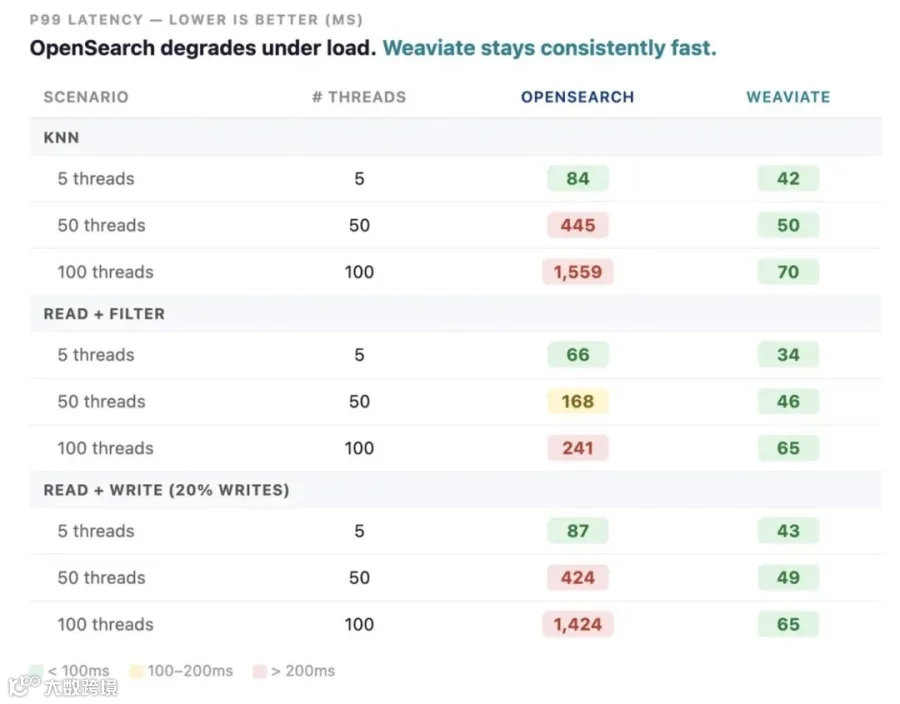
几个关键数据点:
- 纯 KNN
:5 线程时 OpenSearch 84ms,Weaviate 42ms。100 线程时 OpenSearch 飙到 1559ms,Weaviate 稳定在 70ms。 - 读+过滤
:100 线程时 OpenSearch 241ms,Weaviate 65ms。 - 读+写(20% 写入)
:100 线程时 OpenSearch 1424ms,Weaviate 65ms。
差距不是线性的。并发越高,OpenSearch 劣化越快,Weaviate 几乎不受影响。
不只是快,还要能活
性能是主要驱动力,但数据库还得看运维存活能力。Booking.com 对比了几个关键维度:部署灵活性、水平扩展、多租户支持、备份恢复、监控集成、安全合规。
在特性对比表中,Weaviate 在大部分维度上覆盖了 Booking.com 的需求,而 OpenSearch 在向量搜索的专用能力上有明显缺失,比如原生多向量支持、更精细的过滤搜索等。
成本
在可比 recall 和 SLO 目标下,Weaviate 的 compute/memory footprint 比 OpenSearch 基线降低了约 40%。这个数字是效率差异的直接体现,不只是更少的机器,也是更少的调参和运维时间。
迁移:换后端,不是改架构
一个提前做对的事情让迁移简单了很多。Booking.com 的 Embedding Service 早就把数据库访问抽象在内部服务后面,所有客户端不直接碰存储层。这意味着可以同时跑多套数据库,在背后切换后端,对业务透明。
对大部分团队来说,迁移不过是一次配置变更,不需要改代码。
最大的教训
回头看,团队认为最重要的收获不是关于某个供应商或功能,而是对评估过程的 ownership。
在大规模场景下,工作负载高度个性化,通用 benchmark 很少反映真实行为。自己跑贴近生产环境的测试,才能对最终选择有信心。
向量搜索已经是现代 ML 和 AI 系统的基础设施。像对待任何关键数据存储一样对待它:做真实测试、抽象存储层、优化稳定性而非峰值数字。这些事 Booking.com 做到了,省了 40% 的成本,也省掉了未来不知道多少个深夜 on-call。
原文:How we selected the next vector database at Booking.com (https://booking.ai/how-we-selected-the-next-vector-database-at-booking-com-1e738a5e3bb0)
关注公众号回复“进群”入群讨论