分析对象:REA: Reverse Engineer Anything(
github.com/morluto/rea,npm 包rea-agents,v6.4.0,MIT)
数据时点:2026-10-12(报告生成日)。明星数据来自仓库实时页面,文章观点来自用户提供的 InfoQ 原文,架构与工程结论来自对本地完整源码包的阅读。
方法说明:本报告严格区分 事实(可核验)、推断(有依据的判断) 与 未知(无法从现有材料确证),与 REA 自身的产品哲学保持一致。
REA 爆火的真正原因,不是它造出了更强的反编译器,而是它把一个长达四十年、只有少数专家掌握的"逆向手艺",第一次变成了LLM Agent可以稳定调用的"标准能力",并用一整套证据纪律和工程护栏让这个能力变得可信、可复现、可规模化。
把这句话拆开,就是本报告要论证的六条鲜明观点:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
npx rea-agents setup、19 种语言、技能生态、官网案例、Discord——增长是被工程化设计出来的。
|
|
|
|
|
|
|
|
|
|
一. 现象:一组令人窒息的数据
先摆事实。截至 2026-10-12,仓库实时页面显示:

|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0.1.0
6.4.0(2026-10-11)
|
|
|
|
|
src/
|
|
|
|
|
|
|
|
docs/
|
|
|
|
|
|
|
|
|
参照系:把 REA 的增长与年初"养龙虾"热潮中的 OpenClaw 对比——后者爆发第三天累计新增 6 万星。REA 的曲线更陡。
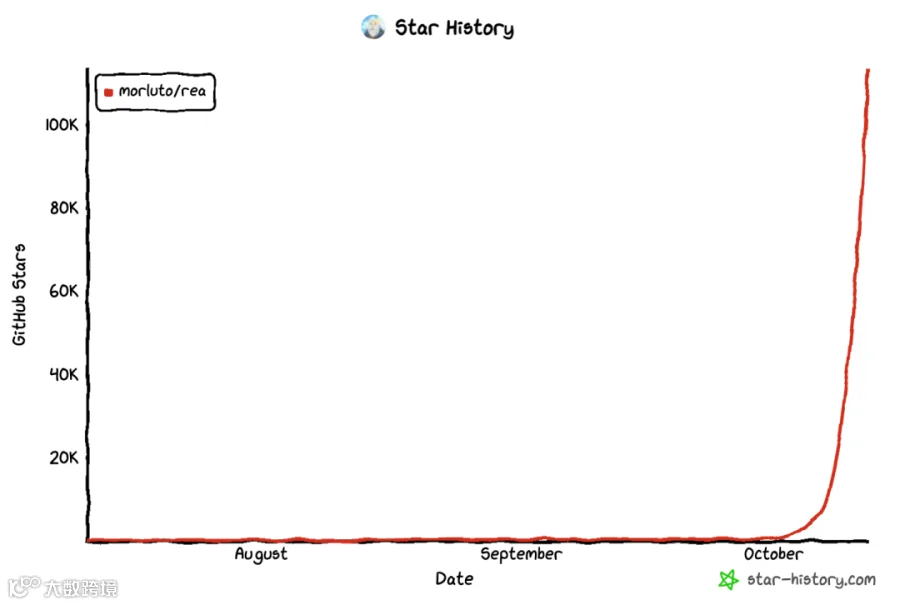
关键观察:这组数据里,最"反常"的不是 star数,而是fork 数(30.2k)和 commit 数(2,494)。纯营销项目通常 star高、fork低、commit少;REA 三者齐高,说明它同时具备"传播性"和"可动手性"——这是产品型开源项目最难同时满足的两端。
2. 它到底是什么:一个被刻意做"薄"的编排层
REA 的定位在 README 里写得极克制:
One MCP for reverse engineering across binaries, applications, and runtime behavior.
See a feature you like. Understand how it works, down to the binary level.
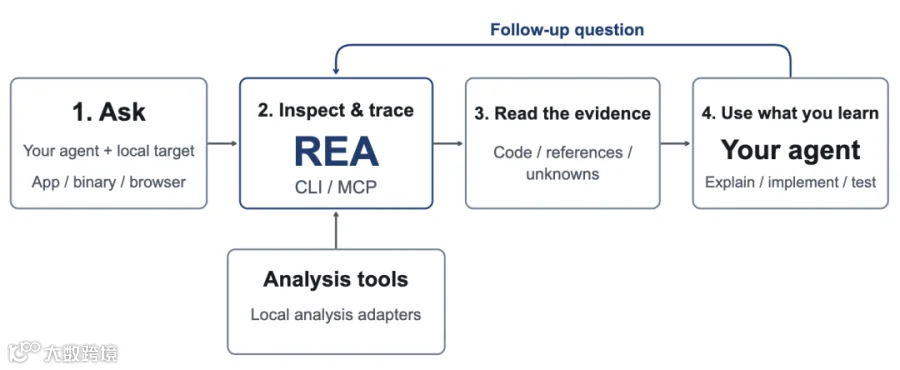
一句话概括:它把"逆向工程"这件原本需要人肉串联多种工具、啃低层细节的硬功夫,封装成 AI Agent 通过 MCP 就能调用的标准能力。用户用自然语言描述"我想理解某个 App 的某个功能",Agent 调用 REA,REA 调度 Ghidra/Hopper/IDA 等引擎,把伪代码、汇编、符号、调用链、引用关系连同证据一起交回。
1. 三种入口,一套结果契约
REA 同时提供三种使用路径,但底层是同一套工作流与结果契约:
-
MCP:接入 Claude Code、Codex、Cursor、Gemini CLI 等 15+ 客户端; -
CLI: npx rea-agents@latest analyze-javascript-application <path> --json; -
技能(Skill): npx rea-agents setup在注册 MCP 的同时,安装配套的调查工作流指令。
洞察点 1:第 3 点最容易被忽视,却最关键。REA 官方反复强调:"安装 skill 只提供指令,不注册 MCP 服务器;注册 MCP 必须用 setup。" 这说明团队把 "给 Agent 的提示词工程"当作一等公民产品,而不是附属品。一个 MCP 服务器只解决了"Agent 能调用什么",而 skill 解决了"Agent 该怎么调用、按什么顺序、如何区分观察与推断"。这两者结合,才是"稳定可用"的前提。
2. 它不是新引擎——恰恰相反
有文章点破了本质:REA 调用的逆向工具全都不是新东西——Ghidra 2019年开源,Hopper 可追溯到 2011年,IDA从90年代就在用。
REA做的是编排:把过去需要人工串联(换工具、啃 API、追调用图、手动复制粘贴)的步骤,接进编程 Agent的工作流。有网友的比喻非常精准:"这就像有人给 Claude Code 配了一个反编译器。"
三. 为什么是它火了:七层归因
爆火从来不是单一原因。下面从"需求—时机—创新—信任—工程—分发—叙事"七个层次逐层拆解,每层都尽量落到可核验的证据上。
1. 需求层:踩中了开发者最普遍的"最大公约数"
痛点具有普适性。几乎每个开发者都有过这样的时刻:用着某个 App,发现某个功能做得特别顺(离线搜索秒出、同步丝滑),想在自己产品里复刻,但没源码、没文档、不知其实现。
-
传统路径:去学逆向工程→找反汇编器→啃 API→在字符串和符号里翻找→手动追调用图→在多个工具间来回倒腾。 -
REA 路径:把这件事描述给 AI 编程助手。
洞察点 2:REA 瞄准的不是"安全研究员的专业需求",而是"应用开发者的抄袭式学习需求"。后者的用户基数大几个数量级。这是一个需求侧的"降维打击"——它把专业工具的用户从"会逆向的人"扩展到了"会描述需求的人"。
InfoQ 文章里那句网友实测——"我拿剪映和几个项目试了试,确实底裤都没了"——正是这种需求的真实映射。
2. 时机层:站在两个浪潮的交汇点
-
浪潮 A:编码 Agent 主流化。 Claude Code、Cursor、Codex、Gemini CLI 在 2026 年已是开发者日常。 -
浪潮 B:MCP 成为事实标准。 MCP(Model Context Protocol)把"工具接入 AI"标准化,业界戏称其为"AI 时代的 USB-C"。REA 正是第一批把"重型专业工具"接入 MCP 的完整产品。
REA 团队对客户端的支持广度也印证了这点:Claude Code、Claude Desktop、Codex、Cursor、Gemini CLI、Windsurf、Devin、OpenCode、Copilot CLI、Qwen Code、Grok Build、Hermes、Pi、OMP、DeepSeek Harness(dsh)……几乎覆盖了 2026 年所有主流 Agent 客户端。这不是运气,是刻意为之的"全渠道卡位"。
洞察点 3:REA 的爆发不能脱离时间轴。2022 年 NYU 的《Pop Quiz!》论文让大模型首次辅助逆向,但那只是"复制粘贴式阅读理解外挂";2026 年 Agent + MCP 成熟,才让"端到端自动逆向"从论文变成产品。同一个技术方向,2022 年是论文,2026 年是 13 万星。
3. 创新层:真正的创新点在"证据语义",而非"能反编译"
这是本报告最重要的判断。
如果 REA 只是"Ghidra 的 MCP 封装",它绝不可能达到 13 万星——市面上早就有 Ghidra MCP。REA 的差异在于它把"证据纪律"设计成了产品的核心契约:
-
每个工具返回 Evidence,带稳定 Evidence ID,可被后续操作引用; -
结论严格区分 观察(observation)/ 推断(inference)/ 未知(unknown); -
声明 覆盖范围(coverage)与限制(limitations),缺失的覆盖是"未知"而非"不存在"; -
会话( BinarySession)绑定不可变的分析配置,可导出、可复现; -
值流截断、未解析边等残留不确定性被显式保留,而非静默丢弃。
官方工具设计文档(docs/tool-design.md)里那几句话,堪称 AI 逆向的"可信度宣言":
"Missing coverage is unknown, not absence."(缺失的覆盖是未知,而不是不存在。)
"Every conclusion must distinguish observations, inferences, and unknowns."
再看技能指令(reverse-engineer-anything/SKILL.md)里的要求:
"Cite Evidence IDs, preserve limitations and incomplete coverage, and never imply that static analysis observed execution."
洞察点 4:AI 做逆向最大的敌人不是能力不足,而是 "一本正经地胡说"。反编译结果本身就可能不完整、AI 又可能幻觉。REA 用"证据账本 + 认识论纪律"直接对冲了 AI 最大短板,把"看起来对"变成了"可核查、可追责"。这才是它区别于玩具级 Ghidra-MCP 的本质,也是它敢把结果交给严肃工程使用的底气。
4. 工程层:用"可验证的严谨"换取信任
开源项目能在一周内爆火,靠故事;能持续被信任,靠工程。REA 的工程投入在同类项目中属于"过度严谨"级别:
(1)严格的分层架构与依赖方向
官方 docs/architecture.mermaid 定义了清晰的向内依赖:入口(CLI/MCP) → 组合根 → 应用层 → Provider 适配器 → 进程基础 → 契约层 → 领域层。并且用 verify:module-boundaries、verify:architecture-guards 脚本在 CI 中强制守卫——架构不是文档里的画,而是会被 CI 拒绝的代码约束。
(2)"真工具链"验证 lane
README 与 docs/testing.md 列出了十余个必须用真实引擎跑的验证命令:verify:ghidra、verify:hopper、verify:ida、verify:browser、verify:managed、verify:android、verify:jeb、verify:firmware…… 例如:
verify:hopper会用真实的 Hopper,检查调用链、CFG 边、引用、批量注记的原子回滚; verify:jeb对 Signal 8.30.3(109 MB) 和 Flutter Gallery 2.9.2(112 MB) 这类真实 APK 做方法反编译验证; verify:adb对真实 Android 14 模拟器跑完整的"安装→解析→启动→观察→强停→卸载"生命周期。
测试被严格分层为 module / composition / boundary / mcp-boundary / acceptance / conformance / evaluation,并明确写入"什么样的测试能证明什么"的表格。
(3)进程与清理的所有权语义
src/process/ 专门处理"受管进程组、私有根目录、超时、有界读取、清理"。文档反复强调:"Retain ownership of resources whose cleanup failed"(清理失败的资源仍需保留所有权)——这暴露了团队对"AI 会反复重试、外部引擎会挂"这类真实工程问题的深刻理解。
(4)发布工程化
使用 release-please 自动化版本与 CHANGELOG;用 turbo + oxlint + oxfmt + knip + jscpd 做质量门禁。
洞察点 5:3 个月 32 万行代码、6 个主版本、640 个测试文件、19 个 CI 工作流——这套工程体系不是"爆火后才补的作业",而是"爆火前就有的肌肉"。开源项目的爆发往往暴露它此前的准备程度:REA 的准备程度高得不像一个新项目。
5. 分发层:为病毒式传播而设计的增长引擎
REA 的"拉新"路径被压缩到极致:
-
一行命令: npx rea-agents setup—— 零安装、零构建,npx 直接拉最新版; -
零门槛静态能力:即便不装任何逆向引擎,JavaScript/Electron 静态分析也能直接工作("Static JavaScript analysis needs no native analysis engine"),让用户第一次尝试就能成功; -
BYO 引擎策略:深度原生分析复用你已有的 Hopper/Ghidra/IDA;setup 可在你批准后帮你装 Hopper,但从不擅自安装无关软件; -
多语言 README(19 种):直接覆盖全球开发者社区; -
技能生态:通过 skills.sh 分发 reverse-engineer-anything技能,进入 Agent 技能分发的流量池; -
官网 + 案例 + Showcase: rea.tools上是一批"可复现的实战案例"(DX-Ball 音场计算、Notion 剪贴板桥、TH04 弹幕环、Aegis 登录码、CTF 掩码方格),每个案例都能点进重建仓库; -
社区:Discord + X + GitHub Issues/Discussions。
洞察点 6:注意"第一次成功"的设计——静态 JS/Electron 分析不需要任何外部引擎。这让新用户
npx一次就能拿到结果,形成正反馈。降低首次成功门槛,是增长设计的黄金法则,REA 严格执行了。
6. 叙事层:"软件完蛋了吗?"制造了最强的传播燃料
技术项目的传播峰值,往往由一个能引发情绪对立的一句话点燃。这次是:"闭源护城河破产了。"
-
Replit CEO 的话被广泛引用:"AI 驱动的逆向工程和反编译领域正在发生的事情简直不可思议。很快,所有软件都可能事实上变成开源软件。" -
社交平台的极端表达:"这些订阅制都该消失""软件完蛋了""以后没有什么东西还算专有了"。 -
InfoQ 的标题本身就是最强的传播装置:"软件完蛋了吗?REA 三天狂揽 12 万星:无需源码,Agent 就能克隆一切软件。"
明星项目的爆发曲线,本质是"技术事实"被"情绪叙事"放大的结果。REA 的技术事实(真能跑通)足够硬,情绪叙事(闭源末日)足够炸,两者叠加才有 13 万星。
结论
REA 的火爆,表面是"Agent 能克隆一切软件"的惊悚叙事,底层却是一次教科书级的"专业能力 Agent 化"实践:
-
它没有发明反编译器,而是发明了 AI 与逆向引擎之间的可信编排层; -
它没有追求模型更强,而是用 Evidence 语义 解决了 AI 逆向最致命的信任问题; -
它没有靠营销起量,而是把 工程严谨、分发体验、合规边界 全部产品化; -
它踩准了 编码 Agent 主流化 + MCP 标准化 的双重时机。
"闭源护城河破产"言过其实,但"代码将越来越不构成稀缺"是真实趋势。REA 不是软件的末日,而是软件价值定价逻辑迁移的一座路标:能被复制的会越来越便宜,能建立信任与服务的会越来越值钱。
对于开发者和产品人,最该从 REA 身上学到的不是"怎么克隆软件",而是它证明的那条通用规律——
在 AI 时代,把一个领域的"专家手艺"转化为"Agent可信可用的能力",其价值可能远超领域本身。
(REA在架构设计上也优势、还有一系列创新的功能特性,对行业有很好的启示,这些内容留到下一篇)