

📝 英文题目:Uncanny valley in conversation? Effects of internal and external human-likeness on intimacy and trust
📚 来源期刊:Behavioral Sciences
🗓 发表时间:2026-10
✍ 作者:Jungwoo Jang, Jae-gil Lee, Hayeon Song
🏆 期刊等级:SSCI Q1 · JCR Q1 · 中科院 心理学3区 · Scopus
📌 本文看点
01
恐怖谷
02
拟人度
03
自我表露
BACKGROUND
研究背景
问题提出
大语言模型让对话智能体越来越像人:它们会表达情绪、会讲自己的经历。但「拟人」这件事,过去的研究几乎都盯在外观——一个 agent 长得有多像人。语言的出现带来第二层拟人:agent 通过自我表露传递出一种「内在生命感」。这就抛出一个被长期忽略的设计问题——AI 到底该多深地谈论自己的经历?而且,这个「多深」是不是要看它长什么样?本文把它放进心理咨询场景来问:一个 AI 咨询师,外表是机器样还是人样,会影响用户愿意它「说多少心里话」吗?
难点剖析
难点在于,现有拟人研究把 human-likeness 当成单一旋钮,而恐怖谷效应本质是「非线性、倒 U / 谷形」的——只有在多个梯度上同时测量才能被检测出来,二值「像 / 不像」会直接漏掉谷形。另一难点是,自我表露既是关系建立手势,又是一个「经验线索」:对一台本不该有感受的机器来说,越深地表露内心,越像在宣称自己有内在生命,越可能触发心智感知里的不安。两种理论预测打架,所以研究者刻意不预设方向,而是让外观来「调节」这个效应。
理论脉络
理论脉络有三条主线。一是社会渗透理论(Altman & Taylor, 1973)的洋葱模型:自我表露分外层(经历)与核心层(深层负面情绪),越往里越亲密。二是心智感知理论(Gray & Wegner, 2012):仅描述机器「能感受」就足以让人不安;把这种能力用第一人称说出来,冲突更强。三是拟人化作为 human-like 线索的结果、也是效应的候选中介。人际研究传统认为深表露增进亲密与信任,但机器自我表露的实证结果参差——这正是本研究的张力来源。
METHOD
研究方法
理论模型
研究者把 human-likeness 拆成内外两个维度,做成一个 2(外观:machine-like vs. human-like)× 3(自我表露:none / low / high)的被试间实验。外观操纵外部拟人度:机器样用无脸、无性别、无表情的机器人头像;人样用一张持牌女性咨询师照片。自我表露操纵内部拟人度:基于洋葱模型分三层——none 把相同内容当客观事实陈述;low 把同一段伤痛经历说成「别人在咨询中讲给 Cure 听的」;high 让 Cure 以第一人称披露自己亲身经历的负面情绪。被试与脚本化 AI 咨询原型「Cure」完成一次简短、完全预设的咨询对话(含学业压力、人际、时间管理三个话题),随后填答六项评价。
研究假设
H1:AI 咨询师自我表露的水平(none / low / high)会影响用户的亲密感、信任、社会临场感、感知真实性与拟人化。 H2:AI 咨询师的外观(machine-like vs. human-like)会调节「通过自我表露表达经验」对用户亲密感、信任、社会临场感、感知真实性与拟人化的效应。 RQ1:AI 咨询师的外观是否会调节「通过自我表露表达经验」经拟人化间接影响亲密感与信任的效应(被调节中介)?
分析策略
H1 与 H2 用一系列 2×3 ANCOVA(IBM SPSS 30)检验,六个结果变量各自独立建模,并以前测的「AI 咨询师心智感知(agency / experience)」作协变量。六个交互效应构成主要检验族,统一做 Holm–Bonferroni 校正,显著后用 Bonferroni 校正的边际均值配对比较跟进。RQ1 用 Hayes PROCESS 5.0 的 Model 7(被调节中介),拟人化作中介、外观作调节、亲密感与信任分别作结果;自我表露三水平用 sequential coding 拆成 no→low(X1)与 low→high(X2)两段,5000 次 bootstrap 取 95% CI。
DESIGN
实验设计
数据收集
2025 年 11 月通过韩国高校网站与在线社区招募,链接轮转服务在每次访问时等概率随机分配到 6 个条件之一(研究者不做人工分配)。被试先填前测(含心智感知协变量),再在独立浏览器窗口与 Cure 对话,结束后返回填后测:注意力检查 → 操纵检验 → 结果量表 → 人口学。全程韩语,机构审查委员会(成均馆大学 IRB,2025-05-021-002)审批通过。
研究样本
a priori 用 G*Power 3.1.9.7 定样本:2×3 被试间、中交互效应 f=0.25、α=0.05、power=0.80,需 158 人。初始 222 人,8 人未过注意力检查、21 人因某条件(machine-like × low-SD)短时间内异常集中且前测特征系统性偏离被剔除,最终 N=193(144 女 / 49 男,均龄 23.1,SD=3.3)。六条件各 n=30–34(machine-like:no 34 / low 31 / high 31;human-like:no 33 / low 34 / high 30)。75.6% 频繁使用 AI 对话 / 生成服务,13.0% 偶尔使用。
测量工具
全部 7 点量表,高分代表程度更高,信度按 N=193 终样计算。感知自我表露 α=0.91(Cayanus & Martin, 2004,4 题);亲密感 α=0.85(Lee & Choi, 2017,4 题);信任 α=0.92(认知信任,Lee & Lee, 2022,4 题);社会临场感 α=0.83(Heerink et al., 2008,5 题,1 题反向);感知真实感 α=0.91(Gershon & Smith, 2020,3 题);拟人化 α=0.90(Godspeed,Bartneck et al., 2009,5 题,剔除运动题后 4 题 α=0.89);对话失当感 α=0.81(Canary & Spitzberg, 1987,5 题,诊断检验);前测心智感知 agency α=0.89 / experience α=0.95(Bigman & Gray, 2018)。
RESULTS
结果与分析
信效度检验
操纵检验有效:感知自我表露随 none(M=3.05)→ low(M=4.26)→ high(M=4.79)阶梯上升,F(2,185)=37.73, p<0.001, ηp²=0.29,且外观主效应与交互均不显著(p=0.846 / 0.171),说明表露只被操纵本身驱动。补充研究(N=41)独立确认所披露内容确实提升了「经验」归属(F(2,80)=28.80, p<0.001, ηp²=0.42)。六项量表的 Cronbach‘s α 介于 0.81–0.92,内部一致性良好;各 ANCOVA 的斜率齐性、Levene、残差诊断见补充材料,且去掉协变量做稳健性检验结论一致。
假设检验
H1 成立:自我表露主效应在亲密感 F(2,185)=10.16, p<0.001、信任 F=7.35, p<0.001、社会临场感 F=14.34, p<0.001、感知真实感 F=6.23, p<0.01、拟人化 F=8.55, p<0.001 上均显著。
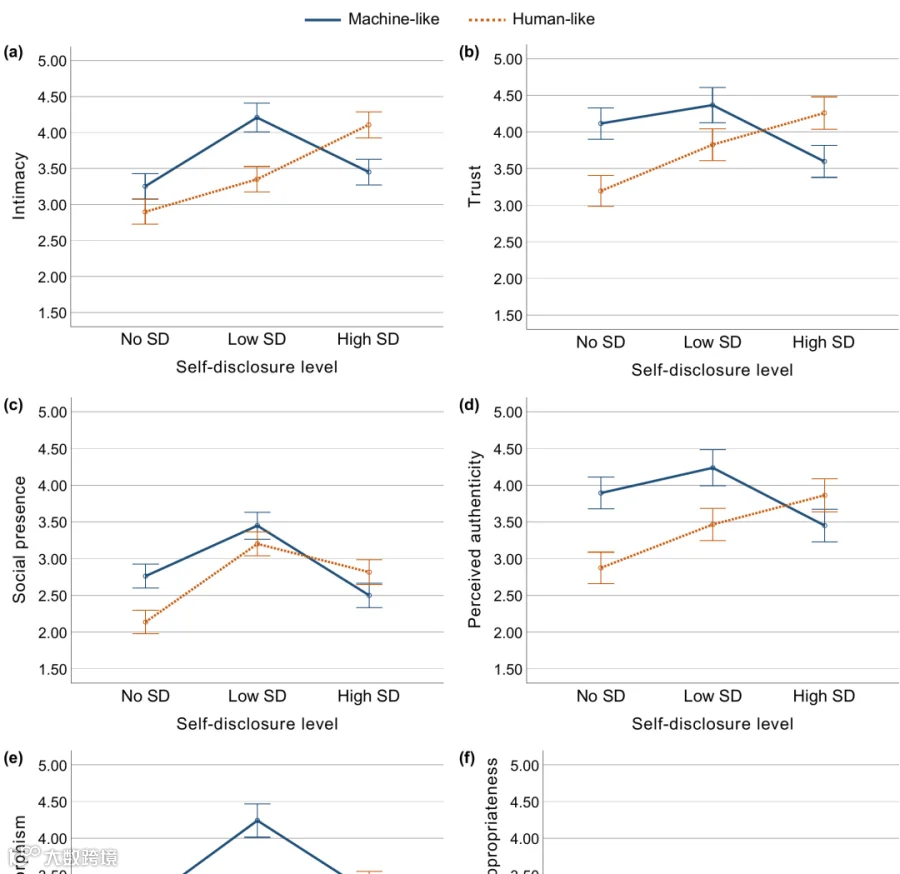
H2 成立(恐怖谷交叉):外观 × 表露交互在亲密感 F=8.89, p<0.001、信任 F=7.35, p<0.001、社会临场感 F=4.25, p<0.05、感知真实感 F=6.10, p<0.01 显著;拟人化交互 p=0.051(边缘)、失当感不显著。Holm 校正后前四项 p<0.05 视为支持。
机器样外观呈典型恐怖谷:亲密感边际均值 no 3.25 / low 4.21 / high 3.45(低表露最佳、深表露回落到近乎无表露);人样外观单调上升:no 2.90 / low 3.35 / high 4.11(深表露最佳)。信任同步:机器样 4.12 / 4.37 / 3.60,人样 3.19 / 3.83 / 4.26。
交叉在亲密感上最清晰:机器样是「低表露最优」,人样是「深表露最优」。深表露并未被判定更失当。
RQ1(被调节中介):no→low 过渡,两种外观都提升拟人化(机器样 b=1.11, p<0.001;人样 b=0.63, p=0.028),经拟人化对亲密感 / 信任的间接效应均显著,但调节中介指数不显著(外观无差异)。
low→high 过渡出现分叉:仅机器样降低拟人化(b=−0.98, p=0.002),人样不变(b=0.06, p=0.827);间接效应对亲密感(−0.56)与信任(−0.70)的负向仅现于机器样,调节中介指数均显著(亲密感 0.60 / 信任 0.74,95% CI 不含 0)。
CONCLUSION
总体结论
研究结论
拟人度不是一根旋钮,而是「外表像人」与「说话像有内心」两个维度,用户是一起读的,不是分开读。机器样外观下,低表露最讨喜、深表露反噬——这是向内宣称内在生命与「机器本不该有感受」的预期相撞,形成类恐怖谷的非单调曲线;人样外观下没有这种冲突,深表露照常增进亲密与信任。越流利的对话 AI,越要同时设计「它说什么」和「它长什么样」。
研究局限
①未测量 eeriness / discomfort 等负向感知,只看到正向评价随表露加深而降,未确认是否伴随「不安」上升,且未把感知欺骗与真实感并列考察。
②无「无外观」条件:当今 LLM 最常见的是无脸化身,缺外观时用户可能更依赖言语线索或自建拟人多默认像,本研究无法判断此时该中规中矩还是加深表露。
③对话两侧皆脚本化,强实验控制但外部效度受限;生成式 agent 的话术、时机、贴合度差异未被捕捉。
④自我表露操纵有混淆:为保持内容等价,low 把同一段伤痛经历改为「别人讲的」,使「经验指代对象」随深度一起变了,留下了替代解释。
⑤每种外观仅用单张图,外观与具体样例混淆;人样照片还固定了女性性别,缺前测外观感知检查。
⑥样本同质:约四分之三为女性、全为韩国大学生、年龄学历相近,且多为 AI 熟练用户,结论外推至临床人群、非校园咨询场景或 AI 陌生用户需谨慎。
未来展望
后续优先级:用真实生成式 agent 复刻以检验生态效度;补上「无外观」条件以填补最常见界面的空白;在更多文化、更多样人口(含 AI 陌生用户、临床人群)中复刻;把感知欺骗与 eeriness 与真实感并列测量;多图配对 + 前测外观感知检查以解耦外观与样例;其他情境/模态中验证「内在生命主张 × 外观」的阅读方式。
金句
Human-likeness is not a single dial. Internal and external human-likeness were read together: how deeply an AI should speak about itself cannot be decided apart from how it looks.
— 研究模型图
📄 摘要原文
Conversational agents built on large language models increasingly converse like humans, expressing emotions and disclosing their own experiences. Human-likeness, however, has been studied largely as a matter of appearance—how human an agent looks. Language now also lets an agent display internal human-likeness by conveying an inner life, raising the question of how deeply an AI should express its own experiences—and whether that depends on its appearance. In a 2 (appearance: machine-like vs. human-like) × 3 (self-disclosure: none vs. low vs. high) between-subjects experiment, 193 university students completed a single, brief, fully scripted counseling session with an AI counselor prototype and evaluated it on six measures, controlling for prior mind perception. The effects of disclosure depth depended on appearance: with the machine-like counselor, intimacy and social presence peaked at low and declined at high disclosure, with trust and perceived authenticity showing the same direction—an uncanny valley-like pattern—whereas with the human-like counselor evaluations generally rose with depth. Deeper disclosure was not judged more inappropriate, and moderated mediation analyses showed that deepening disclosure from low to high reduced anthropomorphism—and, through it, intimacy and trust—only for the machine-like counselor. Internal and external human-likeness were read together: how deeply an AI should speak about itself cannot be decided apart from how it looks.
📎 阅读原文:DOI: 10.3390/bs16101794
END
我是扣子,高校教师/在读博士/AI顾问。关注AIGC,学术科研,博士生活;分享AI赋能和论文带读,打破AI信息差。视频号:扣子说AI。
如需推广论文,请咨询WeChat:Q495428。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
欢迎关注我的视频号
(❤️会不定期更新AI工具哦❤️)

三连一下,不失联!