


全球能接触到前沿实验室内部 AI 系统的,可能只有约 5000 人。
这是 Andrej Karpathy 最新抛出的判断。今天他翻出自己今年 4 月的推文,说人们对大模型能力的认识差距还在扩大:原来是两拨人各说各话,现在更像一只急剧收窄的漏斗。
漏斗最窄的地方,在他的描述里,已经有成千上万个 Agent 协作数周,推进大型软件项目和科学研究。外面的人,还在判断聊天机器人是不是又答错了一道题。
我们用着同一个词,看到的却是几种很不一样的 AI。

连 Karpathy,也在重新学怎么写代码
先看 Karpathy 自己。
去年 10 月,他在 Dwarkesh 的访谈里反对把当时叫作“Agent 元年”。他更愿意说,这是 Agent 的十年:要让它像一名真正能交付工作的员工,还有不少难题要解决。
那时他已经每天使用 Claude、Codex,也觉得这些早期 Agent 很惊人。只是离一个能记住交代、操作电脑、可靠完成工作的同事,还差着一截。
两个月后,另一种焦虑冒了出来。
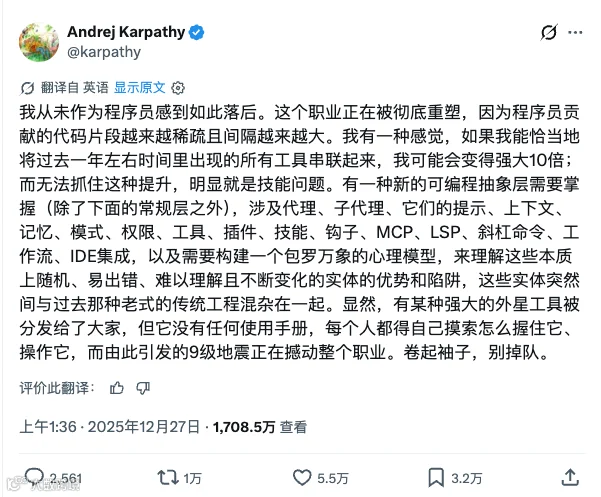
去年 12 月底,他在 X 上感叹,作为程序员,自己从来没有这么强烈地觉得落后。
他列了一长串东西:Agent、Subagent、MCP、Skills、记忆、工具、工作流、IDE 集成……编程突然多出了一层需要掌握的东西。把它们串起来,也许能强上十倍;没串起来,反而像是自己的使用能力跟不上。
他用了一个很形象的说法:像是有人递来一件强大的外星工具,却没有附说明书。所有人都在摸索怎么拿、怎么用,软件行业已经在震动。
到了今年 3 月的 No Priors 访谈,他已经说自己基本不再亲手写代码。Agent 仍有不少毛病,他却又多了一种焦虑:自己有没有充分用上它。
读博时,闲着的 GPU 会让他觉得算力被浪费了。现在,没用完的订阅额度也会让他紧张:还有这么多 token 可以拿来推进工作,怎么就让它们闲着?
到这次推文,他把变化说得更直白。不到一年前,他还在编辑器里一个字符一个字符地敲命令,偶尔按 Tab 补全一小段。现在,一些原来要花几周甚至几个月的复杂项目,已经可以交给 Agent,从一个指令开始推进。
同一个人,同一份编程工作,一年里对 AI 的感受已经变了几轮。
你问一句,他交一个项目
Karpathy 把漏斗中使用前沿模型做数学和代码的专业用户,估在约 2000 万人。
他们交给 AI 的,是做应用、复刻应用、翻译应用、从二进制逆向应用这类任务。工作有目标、有材料,也有后续:读代码,改代码,运行,遇到问题,再改。
这种用法,和让聊天机器人改一封邮件,带来的冲击自然不同。
一封邮件改得更漂亮,可能只是今天少花了几分钟。一个原本要排上几周的项目开始由 Agent 推进,改变的就是接下来几周怎么安排。Karpathy 认为,能力的影响会随着问题的规模、难度和时间跨度放大。一个用一段话就能回答的问题,还没怎么让系统发力。
但漏斗另一头,大多数人甚至还没有走到这一步。
他估计约 60 亿人几乎没怎么接触过大模型,另有 10 亿到 20 亿人偶尔使用免费 ChatGPT 类产品。问点东西、写段文字,碰上几次胡说八道,觉得 AI 也就那样。

微软 9 月的全球 AI 普及报告,提供了一个参照:今年 6 月,全球 15—64 岁人口中,在报告期内用过生成式 AI 产品的比例是 18.8%。这是微软根据遥测并作人口等校正后的估计。AI 在技术圈里天天刷屏,在全球仍远未成为每个人的日常工具。
即便开始付费,用法也会继续分岔。
a16z 10 月 5 日发布的第七版消费级 AI 报告里,有一组很直观的数据。按 YipitData 的美国消费者样本,8 月 AI 付费用户的月支出中位数是 25 美元;花钱最多的 1%,平均每月花 903 美元。
这 1% 贡献了样本中 19.5% 的 AI 消费,超过花钱较少的半数用户加起来的 16.6%。
这批重度消费者更倾向于购买自动化、产品开发和创作工具,例如 n8n、fal、Manus、Figma、HeyGen。他们是在为自己的工作买工具。相同的“我也在用 AI”,可能是一份聊天订阅,也可能是一组持续帮自己做产品、出内容的服务。
而且,数学和代码恰好是模型进步格外显眼的地方。程序能运行,测试能给反馈,证明可以检查。Karpathy 将这种能力分布与可验证奖励的强化学习联系起来:数字化、可验证、又有经济价值的任务,更容易成为训练投入的重点。
所以,一个模型能连续处理复杂代码,也可能在普通聊天里犯让人哭笑不得的错。有人每天撞上它的高点,有人总在碰它的短板。两边的体验都可以是真的。
实验室的门里面,又是另一档
即便天天用付费模型,Karpathy 说,还有一道访问权限的差距。
他估计,约 5000 人能接触前沿实验室的内部系统。他描述的已经是成千上万个 Agent 连续协作数周,处理顶尖专业人士原本需要多年投入的软件和研究工作。
公众看到的,可能还只是预告片。
一个已经公开的例子,是 OpenAI 10 月 6 日放出的数学成果。
生成这些成果的,是尚未发布的内部模型。它在评估中尝试了约 4000 个研究问题。到本文核对时,公开仓库收录了 719 份稿件,归为 372 个成果系列;同一系列可以包含主要结果、配套论证、推论或另一种证明。
人们可以下载稿件,查看部分推理摘要和 Lean 形式化证明,却还不能直接使用生成它们的那款模型。
这就是很具体的一道门:外界在读它交出来的作业,内部已经在拿它继续做研究。
模型把研究材料集中交出来,人的工作随之转向阅读、检查、理解和接着研究。Karpathy 在原帖里说,人的审阅和理解开始落在后面。这种落差,在这样一摞稿件面前,比一个新版本的跑分更容易感受到。
几个月前,他看到的是两拨人谈不拢。现在,用不用 AI、拿它做多大的事、在哪个领域用、能接触哪一档系统,一层层把人分开了。
同一个 2026 年,有人在给聊天机器人纠错,有人在给一队 Agent 分任务,还有人已经要花时间消化内部模型交出的一大摞研究稿。
彼此的感受,可能都没说错。
参考链接
-
Dwarkesh 与 Karpathy 访谈:https://www.dwarkesh.com/p/andrej-karpathy -
No Priors 与 Karpathy 访谈:https://www.youtube.com/watch?v=kwSVtQ7dziU -
微软全球 AI 普及报告介绍:https://blogs.microsoft.com/on-the-issues/2026/09/21/the-continued-state-of-global-ai-diffusion-in-2026/ -
a16z 消费级 AI 报告:https://a16z.com/100-gen-ai-apps-7/ -
OpenAI 数学成果仓库:https://github.com/openai/math -
OpenAI 数学成果发布:https://openai.com/index/sharing-ai-progress-in-mathematics/