


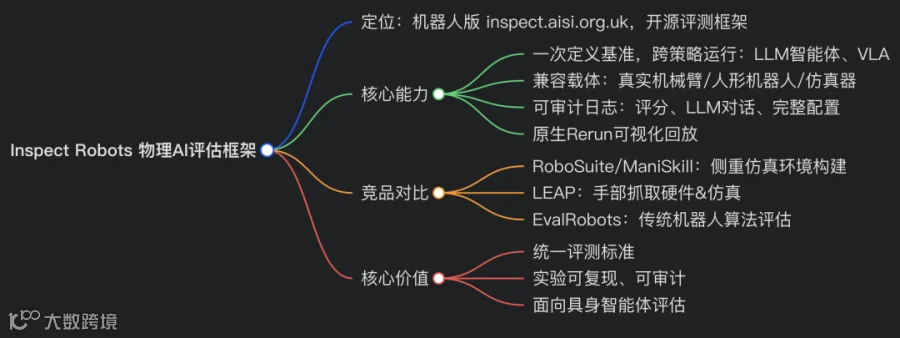
10 组关键问题 Q&A
-
Q:Inspect Robots 是什么? A:面向物理 AI 的开源机器人评估框架,对标inspect.aisi.org.uk,专门评测机器人智能体。 -
Q:它最核心特点是什么? A:一套基准任务,可在不同智能体、不同机器人本体(真机 / 仿真)上复用评测。 -
Q:支持哪些待评估策略? A:LLM Agent 大模型智能体、VLA 视觉语言动作模型。 -
Q:支持哪些机器人载体? A:真实机械臂、人形机器人,也支持各类仿真模拟器。 -
Q:可审计日志包含哪些内容? A:评分结果、大模型交互对话、全部实验配置,方便复现。 -
Q:Rerun 在这里的作用? A:提供完整可视化回放,直观查看机器人执行全过程。 -
Q:和 ManiSkill、RoboSuite 最大区别? A:后者是仿真任务环境;Inspect Robots 是评测框架,不是仿真器。 -
Q:LEAP Hand 和它定位差异? A:LEAP 侧重灵巧手硬件与抓取仿真;Inspect Robots 做通用智能体评估。 -
Q:EvalRobots 与 Inspect Robots 的区别? A:EvalRobots 偏向传统机器人算法;Inspect Robots 主打 LLM/VLA 具身智能评测。 -
Q:这个框架解决行业什么痛点? A:解决不同具身智能评测标准混乱、实验无法审计、难以横向对比的问题。

Inspect Robots 是 面向物理 AI(Physical AI)的开源评估框架,对标 AISI 的 Inspect AI(大模型评估框架),专门解决机器人领域「一套基准任务,跑任意策略 + 任意机器人本体」的标准化评测问题。
一、定位
一句话:定义一次机器人基准任务,即可在任意兼容机器人本体(真机 / 仿真器)上,跑任意策略(LLM 智能体、VLA 视觉语言动作模型),输出可审计日志 + Rerun 可视化回放。
-
类比: inspect.aisi.org.uk是纯软件大模型评估;Inspect Robots = 机器人版 Inspect AI -
当前状态:Alpha 早期开发版,API 会变动,生产使用需要锁定版本 -
许可证:MIT 开源
核心设计思想
机器人评测长期痛点:策略、机器人硬件、仿真环境强绑定,换机械臂 / 换 VLA 模型就要大量改代码,日志不统一、回放困难,评测结果不可复现。 Inspect Robots 做了解耦:
- Policy(策略)
VLA、LLM Agent、代码生成策略、脚本策略,独立可插拔 - Embodiment(本体)
真实机械臂 / 人形机器人、IsaacLab 仿真、Mock 虚拟环境,独立可插拔
框架在运行前提前校验策略与本体的动作空间兼容性,不等到机器人运行中途才报错。
二、核心能力
1. 统一可审计日志 EvalLog
每一轮评估生成固定 Schema 版本的EvalLog,包含:
-
完整配置、Git 版本、依赖包版本 -
打分器分数、LLM 对话转录文本 -
相机帧、本体感知、动作序列 日志支持离线重新打分、跨版本读取,所有评估过程可追溯审计。
2. Rerun 原生可视化
内置 Rerun.io 可视化,实时流式推送:相机画面、机器人 3D 位姿、关节时序、动作流、任务成功标记,保存.rrd回放文件。
-
日志非阻塞:可视化慢时优先丢弃图像帧,不阻塞机器人控制循环 -
支持远程流式查看:机器人端跑,笔记本打开 Rerun 看实时画面(SSH 端口转发)
3. 多类型策略插件(Policy)
表格
|
|
|
|---|---|
inspect-robots-agent |
|
inspect-robots-xpolicylab |
|
inspect-robots-capx |
|
|
|
|
LLM Agent 模式:模型输出分块动作,每块动作会经过校验器校验后再下发给机器人。
4. 丰富机器人本体插件(Embodiment)
真机硬件支持:
-
YAM 6 自由度双臂、Franka FR3/Panda、Agibot A2 Ultra 双臂、Unitree G1 手臂、SO-ARM100、WidowX 250S -
通用 ROS 桥接插件 inspect-robots-ros:任意 ROS1/ROS2 机械臂,不需要评估机本地安装 ROS,通过 rosbridge 通信
仿真环境:
-
IsaacLab 仿真 inspect-robots-isaacsim -
内置 CubePick Mock 虚拟世界:纯 Python、无 GPU 无硬件,用于快速开发测试
5. 其他特色功能
- 运行时语音交互
: inspect-robots-voice,本地麦克风转录,操作员实时给策略反馈(仅反馈,不会自动结束任务) - 失败经验总结与复用
summarize命令把失败日志导出为 Markdown 经验文件,下一轮评估加载prior_learnings,让 Agent 从过往失败学习 - 统一 CLI + Python 双 API
-
CLI:一行指令下发任务,自动生成日志、HTML 报告、视频导出 -
Python API:可直接在代码中定义 Task、Scene、打分器,执行 eval 拿到日志 - 自动 HTML 报告看板
inspect-robots view logs/批量渲染所有评估记录,生成可筛选索引页面,包含指令、模型、成功率、终止原因 -
支持静态浏览 / 本地服务,新实验自动刷新 -
可导出 MP4 视频(ffmpeg) - 安全护栏
:默认自带动作限幅、单步动作增量限制,本体插件可叠加自定义安全规则;必须显式参数 --disable-guardrails才可以关闭 -
仿真一键切换:同一个任务指令,增加 --sim参数,直接切换到仿真本体执行
三、安装 & 快速上手(极简流程)
# 创建虚拟环境并安装(带Rerun可视化)
uv venv && uv pip install "inspect-robots[rerun]"
source .venv/bin/activate

# 示例1:最简单,CubePick虚拟环境,Claude Agent控制,不需要硬件
export ANTHROPIC_API_KEY=sk-ant-...
inspect-robots "pick up the cube" --policy agent \
    -P model=anthropic/claude-fable-5 -P effort=low --embodiment cubepick

# 示例2:YAM机械臂 + MolmoAct2 VLA策略
uv pip install inspect-robots-yam
inspect-robots setup
# 在GPU机器启动MolmoAct2服务后执行
inspect-robots "place the fork on the plate"

# 示例3:IsaacLab仿真 + XPolicyLab π0 VLA
inspect-robots run --task my-task --embodiment isaacsim \
    --policy xpolicylab -P url=ws://gpu-box:19000
四、框架核心概念映射(Inspect AI ↔ Inspect Robots)
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
基准任务定义和评估日志规范放在独立仓库:
worldevals,本仓库只保留评估框架。
五、Python API 最小示例
from inspect_robots import eval
from inspect_robots.mock import CubePickEmbodiment, ScriptedPolicy
from inspect_robots.scene import Scene
from inspect_robots.scorer import success_at_end
from inspect_robots.task import Task

task = Task(
    name="cubepick-reach",
    scenes=[Scene(id=f"layout-{i}", instruction="reach the cube", init_seed=i) for i in range(5)],
    scorer=success_at_end(),
    max_steps=80,
)

(log,) = eval(task, ScriptedPolicy(), CubePickEmbodiment())
print(log.status, log.results.metrics)
六、适用场景
-
VLA/LLM 机器人智能体的标准化 Benchmark 评测(真机 + 仿真一套代码) -
不同模型之间公平对比(GR00T、π0、OpenVLA、Claude Agent、Code-as-policy) -
机器人算法迭代:失败日志复盘、自动总结经验、回放调试 -
真机安全评估:统一安全护栏,限制动作范围,故障分级(继续 / 停机等待人工) -
学术实验:可复现、可审计评估记录,方便论文实验与引用
七、局限
-
Alpha 阶段,API 不稳定,不建议直接上大规模长期实验,需要锁定版本 -
硬件本体依赖独立插件,小众机器人需要自行开发 Embodiment 适配器 -
CaP-X 代码策略依赖外部服务(SAM3、Contact-GraspNet),部署链路更重
八、引用
@software{inspect-robots,
  author  = {Robocurve},
  title   = {Inspect Robots: The open-source evaluation framework for physical AI},
  year    = {2026},
  url     = {https://github.com/robocurve/inspect-robots},
  license = {MIT}
}