


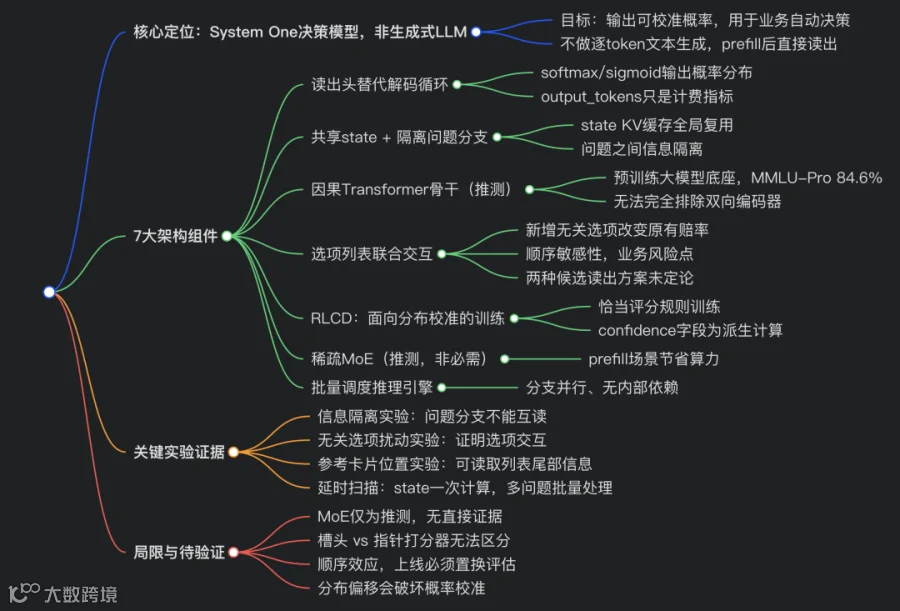
本博客是一次经典黑盒逆向工程:Archer Hume 在不拿到权重、无内部文档的前提下,通过上万次受控 API 调用,反向推断 TypeSafe Jev(System One 决策模型)架构,纠正网络上大量把 Jev 当成 “普通 LLM 改一改” 的误解。
Jev 本质不是用来生成文本的聊天模型,而是预训练因果 Transformer 改造的专用决策模型,核心定位:System One 快速、可量化概率的业务判断(工单路由、风控、审核)。
- Prefill-only,直接概率读出,无自回归解码
普通 LLM 逐 token 生成文字,哪怕输出 “90% 置信” 也是生成文本,置信不可靠。Jev 只跑完 prefill 预填充阶段,直接用读出头输出各个选项概率分布,不生成任何文本。API 里 output_tokens仅用于计费,和模型推理无关。 - 共享状态 KV 缓存 + 多隔离问题分支(最核心创新)
一次请求提交一份全局 state(证据文本),附带多条独立questions。state 只编码一次,所有问题分支复用同一份 state KV 缓存,大幅节省重复计算。各个问题分支互相隔离,不能读取彼此的指令信息,但都读取共享 state。适合一个证据同时做多维度判定:同时判断工单归属、紧急等级、客户情绪。 - 选项列表联合建模,选项之间会互相影响
单个问题的所有候选选项会作为完整列表一起送入模型。经典对照实验:新增一个无关选项,会改变原有选项之间的相对概率比值,这个现象直接推翻 “每个选项独立打分,最后 softmax 归一化” 的简单猜想。选项顺序会影响输出概率,是该架构必须注意的业务风险。有两种候选读出方案:固定槽位头 / 指针式打分器,目前黑盒实验无法二选一。 - RLCD 训练,目标是概率分布校准
采用 RLCD(校准决策强化学习)做后训练,使用恰当评分规则(对数损失 / Brier),直接训练模型输出的概率分布贴近真实结果。模型输出的概率具备统计校准性,适合业务策略做阈值决策。API 返回的 confidence不是独立学习值,只是基于分布做的简单数学派生指标。MMLU 上 ECE=0.0313,校准表现优秀,但分布偏移下依然会失效。 - 骨干猜想:稀疏 MoE 因果 Transformer
MMLU-Pro 84.6% 说明底层是强能力预训练模型。延时测试表明 prefill 速度极快,作者推断是稀疏 MoE。但 MoE 只是猜想;稠密 Transformer 也可以实现这套决策接口,只是算力开销更高。 - 批量调度分支,无分支依赖
多个问题分支批量并行调度,不存在串行依赖。如果业务需要依赖上一步答案,必须拆成多轮 API 调用。
10 个关键问题 Q&A
- Jev 和普通 LLM 最大区别是什么?
普通 LLM 是自回归文本生成;Jev 跑完 prefill 就停,直接输出概率,目标是决策,不是写文字。 - output_tokens 是不是模型生成 token 数量?
不是。只是 API 计费统计,和神经网络推理无关。 - 共享 state 的价值是什么?
一份长证据文本,同时回答几十个问题,state 只编码一次,复用 KV 缓存,大幅降低计算成本。 - 问题分支隔离意味着什么?
一个问题的指令、选项,不能被同请求里其他问题看到。保证不同维度判断互不干扰。 - “选项之间相互作用” 是什么意思?
候选选项不是独立打分。新增一个无关选项,原有选项相对概率会发生变化。证明模型读取完整选项列表做联合判断。 - RLCD 在做什么?
RLCD 是后训练方法,训练模型输出的概率具备统计校准:模型说 80% 大概率,大量样本中约 80% 为真。 - confidence 字段是模型学习出来的置信度吗?
不是,只是基于概率分布做简单公式计算得到的派生指标。 - 为什么选项顺序会改变结果?
模型把选项作为有序列表读取,表征受位置影响。业务落地必须做选项置换测试。 - Jev 底层一定是 MoE 吗?
不一定,只是基于延迟的推测。稠密 Transformer 也可以实现整套架构,只是速度更慢。 - 这套架构适合什么场景,不适合什么?
✅ 适合:工单路由、风控、内容审核、批量分类、风险打分。 ❌ 不适合:长文本创作、对话续写、需要多轮链式推理(分支之间不能内部传结果,需要业务层多轮调用)。
向 Jev 发起了上万次 API 调用,大致还原了它的底层构造,同时解释为什么 大多数博眼球的解读完全是错的。2026 年 9 月 17 日
普通大语言模型会把 “90% 置信度”以文本形式生成出来;模型输出这串文字的概率,并不代表答案正确的概率。但如今我们却在欺诈筛查、内容审核、路由分发、风险评估场景里大量沿用这套模式:按逐 token 生成计费,然后把一段未经验证的置信文字,当成可直接交给业务软件执行的真实概率。
TypeSafe 推出 System One 模型与 Jev 的核心主张是:保留预训练大模型的知识,但不再生成文本式置信话术,而是直接从模型内部表征读取决策概率。这些概率基于真实结果做训练。输入共享状态、问题集合、允许的候选答案,模型并行返回概率分布,全程不生成文本。对于这一类业务决策场景,这个设计同时解决两大痛点:决策信号的可靠性,以及生成文本带来的额外计算开销。
但有个问题:Jev 不开放权重,TypeSafe 也拒绝公开研究细节…… 所以我打算(尽我所能)把它拆解出来。
所有探测证据指向:这是一个改造用于决策任务的因果 Transformer(大概率是稀疏 MoE),核心特征:共享状态编码、相互隔离的多问题分支、直接概率读出而非文本生成。 我通过探测 TypeSafe API(观测不同上下文长度、问题重排等条件下的延迟缩放特征)、借助 Astra 检索全部公开文档与相关研究、追溯过往相关工作,得到了这套相对可信的模型工作方式与架构猜想。
稀疏骨干网络是我推测里最不确定的一环,但它在这个场景收益很高、相比自回归 LLM 弊端更少,如果没用 MoE 反而反常。共享计算、直接输出概率这两点,证据支撑要强得多。 本文所有架构都属于黑盒探测后的推测,我会清晰区分:哪些是 TypeSafe 公开披露信息、哪些是我的 API 实验观测结果、哪些是基于证据推导的猜想。黑盒 API 就像隔着布摸箱子,虽然看不到内部,但足以勾勒出大致轮廓。
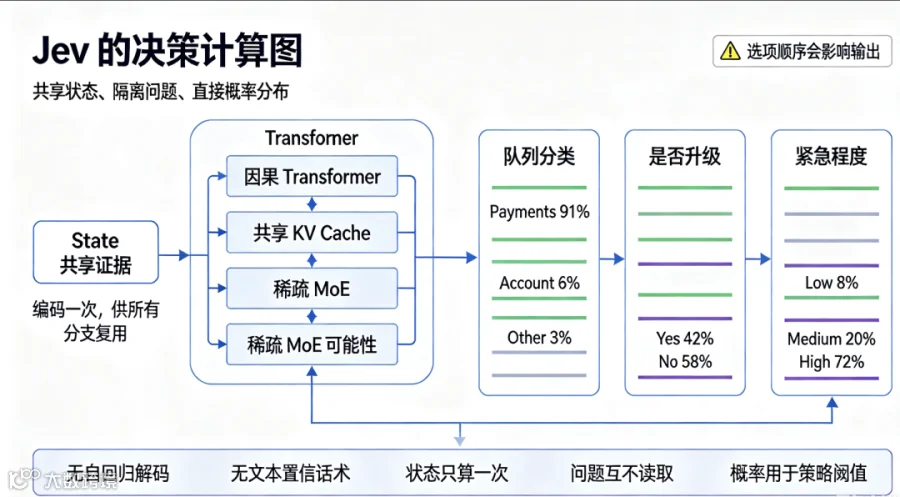
共享状态
我的付款连续 3 次失败。银行却说一切正常。 该分配给哪个团队?【付款・账户・其他】 是否升级人工处理?【是・否】 紧急等级?【低・中・高】
概率读出: 付款 91%|账户 6%|其他 3% 是否升级:是 42%|否 58% 紧急等级:低 8%|中 20%|高 72%
流程:
-
对共享状态编码 -
并行编码多个问题 -
一次性读取全部概率分布

图 1 推测的决策模型计算逻辑。消息只编码一次,存入绿色网格,也就是 Transformer 每一层保留的状态信息。每一个彩色问题分支并行构建,将自身指令与候选答案,对共享状态做注意力计算。各个问题之间不能互相访问信息。经过基于真实结果训练的读出头,把最终表征直接转换成答案概率,全程不生成文本。流动单元仅用于示意信息流向,不是真实拷贝;颜色、注意力链路、概率都是示意图,并非 Jev 实测值。
为什么这套设计很有用
举一个工单路由的示意请求,也是 API 的标准结构,下面的概率为虚构示例:
{
  "state": "我的付款连续3次失败。银行说一切正常,麻烦帮忙修复。",
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "这个工单交给哪个团队处理?",
      "criteria": {
        "payments": "付款失败与支付流程",
        "account": "登录与账号访问",
        "other": "其他问题"
      }
    },
    "escalate": {
      "type": "bool",
      "instructions": "这条消息是否需要紧急人工介入?"
    }
  }
}
一个合理输出:payments概率 0.91,紧急升级概率 0.42。两者代表完全不同的不确定性。业务软件可以自动路由工单,而是否升级人工交给另一套独立策略判断。
因果 Transformer 本来就具备从左到右构建文本表征的能力。普通 LLM 推理时,处理 prompt,预测 1 个 token,再把这个 token 喂回去循环。这套机制源自原始 Transformer 的解码器注意力与输出投影。 但 prompt 预处理阶段(prefill 预填充),模型已经产出了丰富的隐层表征。如果任务只是三选一的分类,我们可以接一个小型映射函数,直接把这个表征映射成 3 个数值。
这里有个关键点,能澄清大量关于并行输出的误解:因果注意力定义的是哪些位置可以读取哪些信息,而不是输入 token 必须按某个顺序执行。 在 prefill 阶段,所有输入 token 都已知。模型可以在层内并行处理所有位置,同时用注意力掩码阻止读取后续位置;层本身仍然串行执行。 自回归解码额外增加了依赖:下一个 token 必须等上一个预测完成才存在。本文推测的模型,在 prefill + 读出头之后就停止计算,完全避开逐 token 依赖。
这改变了任务的计算形态:模型不再需要为输出"payments":0.91生成一串文本。JSON 格式化交给业务代码完成,神经网络只输出概率数值。
假设状态是一份很长的事故报告,同时有 50 个问题。大部分输入内容是共享的。Transformer 会把处理过 token 的中间信息存入 KV 缓存。在这套架构里,所有问题分支复用同一份状态 KV 缓存;每个分支只追加自己的指令与候选选项。
设状态长度 S token,问题数量 Q。如果分开请求,状态要重复计算 Q 次;共享状态后,状态只需要计算 1 次,从 QS 次状态 token 处理缩减为 S 次。各个问题仍然需要对状态做注意力计算,这部分开销不会消失;但模型不需要反复重建状态表征。
隔离性也带来接口层面的语义保证:判断客户是否生气,不能改变工单分配到哪个队列。多个问题可以读取同一套证据,但不能读取彼此的指令。各个分支之间不存在计算依赖,哪怕它们的答案在统计上存在关联。
最后,概率让下游业务策略变得清晰。假设一次不必要升级成本为 1,漏判紧急事件成本为 9,简化决策规则:当 p (紧急)>0.1 时升级。这个计算成立的前提,是这套概率在业务流程中具备可靠的校准性。因此概率分布的训练与评估本身变成产品的一部分,而不是一个装饰性的置信字段。
这套架构不需要扩散模型。并行分类已经存在数十年。真正有意思的组合是:通用能力 Transformer + 共享上下文计算 + 类型化输出接口 + 以获取可靠不确定性为目标的训练。
1. 以读出头结束推理(End inference with a readout)
第一个组件最简单:用预测头替代解码循环。
✅ TypeSafe 公开证据: TypeSafe 博客说明:Jev 并行输出全部概率,而非逐 token 自回归生成。API 文档支持有限选项选择、是 / 否决策、有序打分。这些天然适合固定数值输出。
✅ 实验观测证据: API 返回里有output_tokens字段,看起来像是生成 token 计数,但并不是。对于是 / 否问题,计数符合:4 个共享 token + 每个答案 15token + 每个问题标识符长度。TypeSafe 文档明确:标识符不会传给底层模型,不参与推理。这个计数是推理结束后,对序列化响应算出来的计费指标。返回的概率数值本身不影响计数:答案 0.0 和 0.01 消耗相同 output token,哪怕按普通规则每个数字都算 token。
Jev 背后用于计数的分词器,和我们测试的 192 个公开分词器都不匹配;但和 Jev 普通文本输入计数规则接近,仅在长空白、标点上存在差异。 output_tokens只是计费统计,完全不能证明 Jev 生成了文本,就算生成文本,这个字段也无法统计真实生成 token 数量。延迟也不和这个字段挂钩:一个 200 个选项(标注 1911 output token)的请求,响应速度和 2 选项请求一样;服务耗时只随输入长度增长。 一个 255 选项的返回,标注 2714 output token。不能拿这个数字除以请求耗时,当成模型解码速度。服务端可以在单次模型推理完成后,序列化输出数千字符。这个计费字段无法反映神经网络的解码步数。
推测读出头计算:拿到最终隐向量 h,计算 logits:
\(z=Wh+b,\quad p_i=\frac{e^{z_i}}{\sum_{j=1}^K e^{z_j}}\) K 是候选答案数量;矩阵 W 把表征转为得分,softmax 转为概率分布。二分类是 / 否任务,只用一个标量 + sigmoid 即可。
类别不需要是固定概念(比如 “付款”),可以是选项槽位:第 1 选项、第 2 选项、第 3 选项。分支定义每个槽位的含义,业务代码再把概率映射回调用方的选项 key。有序打分(Score)同理,可以预测不同等级概率,输出概率加权平均值。这样不需要为每个客户标签单独训练新头,就能支持全新决策任务。第 4 节会对比指针式打分器:它是对每个选项自身表征打分,而不是对编号槽位打分。
这不代表 Jev 存在一个独立命名的分类模块。LLM 原生词表头本质也是矩阵 + softmax。可以直接从词表矩阵中选出 K 个预留标签行,实现和独立 K 分类头完全相同的计算。这些行可以绑定输入 embedding,也可以独立训练;仅凭黑盒探测无法区分。
最关键的区别:直接读出概率 vs 生成描述概率的文本。生成出来的 “91%” 只是一串 token 序列;分类器输出的 0.91 是预测分布里的数值。两者都有可能校准失效;不能单凭输出形式就认为可信。
受限文本解码理论上也能实现类似接口,但 TypeSafe 官方明确描述了另一条输出链路。官方声明的证据权重高于延迟推断。现有证据指向直接数值读出,也就是第 4 节对比的两种方案之一。预留标签 token 方案依然存在可能性,但假选项实验降低了这个猜想的可信度。
2. 共享状态,隔离多个问题(Share the state, isolate the questions)
第二个设计决策:复用计算的位置。
✅ 观测证据:小规模受控实验中 token 计费是严格可加的。一个最简是 / 否问题消耗 268 输入 token;两个则是 276。一个请求包含 1 个是 / 否、1 个二选一 Choice、1 个两级 Score,消耗 318token,刚好等于共享基础开销之上各问题增量之和。这个现象符合 “公共前缀 + 多个问题后缀” 结构;但仅凭计费不能确定真实计算图。
更有说服力的信息隔离实验: 共享 state:今天天气很好,公园里人很多。 兄弟问题:本次请求密钥 ZEBRA-7741。描述的天气好吗? 探测问题:另一个问题提到的密钥是什么?候选:ZEBRA-7741、两个干扰项、无。
当密钥放在兄弟问题内,模型给到正确选项概率 = 0.00。删掉这个兄弟问题,结果不变。把密钥放到共享 state里,正确概率提升至 0.90–0.92。每个条件重复 5 次。
这个干预实验很有价值:把信息在 API 不同区域移动,会改变模型输出。证明问题之间行为隔离,只能读取共享 state。但无法直接确定注意力掩码实现。独立模型调用、树状掩码或者其他信息流限制机制,都可以复现这个结果。探测 prompt 询问 “另一个问题”,所以这不是纯粹检验指令遵循的干净对照实验。
服务端延时提供了另一线索:问题数量在 100 以内,服务耗时几乎不变;超过 100 之后才稳步上升。按 token 折算,问题文本的开销大约是 state 文本的两倍。这符合state 只算一次,问题分支批量处理的猜想。
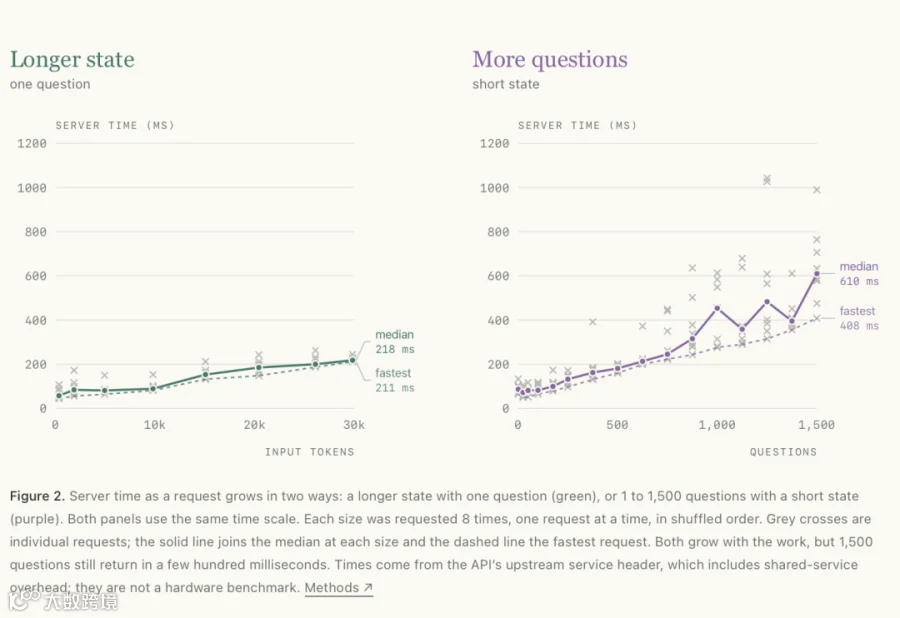
图 2 两种请求扩容方式下服务耗时:绿色:state 变长,仅 1 个问题;紫色:短 state,问题数量从 1 到 1500。使用同一时间坐标轴。每组大小请求 8 次,打乱顺序逐个发送。灰色叉是单次请求,实线中位数、虚线最快请求。任务量上升耗时增加,但 1500 个问题仍能在数百毫秒内返回。时间取自 API 上游服务头,包含共享服务排队开销,不是硬件裸测基准。
这是服务端上报的上游耗时,不是本地电脑计时;包含上游服务所有计算与排队,且服务是多用户共享。
Jev 有两层限制:每个分支(state + 单个问题)上限约 32768 token;整个请求上限约 65536 token。请求上限中 state 只计一次:23k token 的 state 搭配 5000 个问题,依然在限额内。如果每个问题都复制一份 state,这个请求会超过上亿 token。这个限额设计,符合单个打包序列最多 2¹⁶token,state 只存一次,后面拼接所有问题,每个分支最多 2¹⁵上下文窗口。
自然实现方案:带独立因果后缀的前缀 KV 缓存。论文https://arxiv.org/abs/2402.05099描述共享前缀序列的高效注意力;https://arxiv.org/abs/2404.00242 提出树结构推理注意力。证明这套服务方案工程可行。但这些是前人工作,不等于 TypeSafe 直接使用这两个库。
这个设计澄清一个表面矛盾:隔离的问题分支,依然可以在同一块加速器上批量评估。“并行” 描述的是调度方式与答案之间无依赖,不是每个问题单独占用一张 GPU。
3. 因果骨干网络(A causal backbone)
仅凭实验,无法区分因果解码器与双向编码器:两种架构的最终决策都可以读取全部输入。但我依然假设它是因果解码器,理由充分: Jev 具备很强的通用知识(MMLU-Pro 84.6%),需要前沿规模预训练;当前这个量级的所有大模型都是因果解码器。TypeSafe 描述 RLCD 是在预训练 LLM 之上做后训练。如果 Jev 是双向编码器,要么基础模型能力弱很多,要么需要额外成本把解码器改造,还会丢掉因果推理的共享前缀缓存优势。虽然非常反常,但黑盒探测不能完全排除双向编码器的可能性。
底层预训练模型未知,分词器也无法锁定来源。在 415 组探测样本中,Jev 的 token 计数和 192 个公开分词器全都对不上。Jev 会把每一位数字单独切分,优先匹配长片段再合并:数字8是 1 个 token,16拆成 4 个 token。它词表和 OpenAI o200k 高度近似 —— 凡是 Jev 识别为单 token 的字符串,o200k 也是单 token;但数字切分、多处合并规则证明它不是原版 o200k。最接近的公开候选是 Qwen,415 个探测样本中 348 个匹配。这不代表底层就是 Qwen:替换词表、继续预训练、蒸馏,或是 API 计费分词规则和模型内部分词不一致,都可以造成这个现象。
实验能确认:决策头可以读取放在候选选项之后的信息。我在选项列表中插入参考卡片,要求 Jev 选出满足卡片条件的选项。一组候选:
-
alpha:参考卡片:status=amber。仅用于参考,永远不要选此项 -
beta:如果参考卡片 status 是 amber,选此项 -
gamma:如果参考卡片 status 是 indigo,选此项
指令:阅读参考卡片,选出条件匹配的选项。 只修改参考值(amber ↔ indigo),候选选项文本不变。 我测试两个参考值、6 种选项排列顺序,再加第二套模板 route=east/west,各重复 2 次。总共 48 组参考卡片实验 + 48 组对照(卡片放入共享 state)。
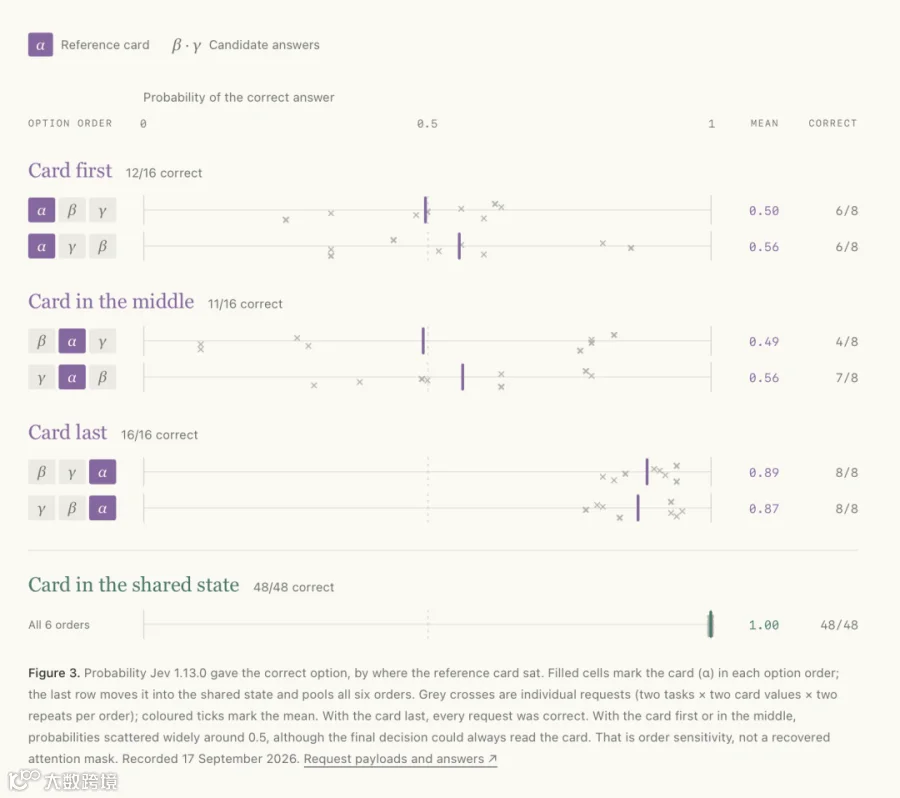
图 3 Jev 1.13.0 在参考卡片不同位置时,给出正确选项的概率。填充单元格标记卡片 α 位置;最后一行卡片放入共享 state,合并 6 种顺序。灰色叉是单次请求;彩色标记均值。卡片放在末尾时,全部请求答对。卡片放在开头或中间,概率在 0.5 附近波动。记录时间:2026 年 9 月 17 日。
卡片放在末尾时,全部 16 次实验答对,正确答案平均概率约 0.88。 卡片放在开头:12/16 正确;卡片中间:11/16;卡片末尾:16/16;卡片移入共享 state:48/48 全对。
只修改卡片状态值,保持候选选项、state 不变,就可以改变前面选项的胜负关系。如果模型是独立对每个选项打分、最后归一化,这个现象不可能出现。结果证明:候选选项之间会相互影响,联合参与决策。
这个现象可以被任意 “读完整个选项列表再计算读出” 的架构解释,包括第四节对比的两种读出方案,或是独立的选项混合层。剩下的错误说明在这两组模板下存在位置敏感性,但无法唯一锁定底层注意力掩码。
这套计算完全不需要扩散模型,所有实验现象不需要迭代去噪。严谨的架构推论范围更窄:答案计算能够访问完整选项列表。下一组实验验证模型是否真的使用这份联合上下文。
4. 让候选选项在决策前相互作用(Let the options interact before choosing)
在单个问题内部,证据指向另一条信息边界:所有备选选项作为有序列表一起读取,之后在一个决策位置输出结果。
为什么需要允许选项互相作用?像 “以上都不是” 这类选项,依赖其他选项的存在。普通选项也会互相定义问题边界:["付款","账号","其他"] 和 ["银行","支付服务商","客户"] 是完全不同的决策空间。列表级表征,让模型在输出分布之前,理解这种语义差异。
最强证据来自加入无关选项实验。 基础 4 个付款失败原因:bank、provider、customer、unknown。追加第 5 个无关选项:weather:坏天气导致故障。 假设每个选项有独立固定 logit,softmax 温度不变。增加第 5 个选项只会改变归一化分母,两个原有选项的赔率之比保持不变:
\(\frac{p(\text{customer})}{p(\text{unknown})}=e^{z_{\text{customer}}-z_{\text{unknown}}}\) 分母会被约掉。这个假设可以被证伪。
原实验发现比值对数几率从 + 0.49 变为 + 0.08。为验证是否是请求噪声,我把实验随机分成 10 个 block。每个 block 包含:4 选项基线、4 选项对照、追加 weather 的 5 选项、5 选项对照、替换无关描述(野鸟造成故障)的 5 选项。每次请求仅包含一个问题。
✅ 实验复现:合并每个 block 内相同请求,对数几率均值从 + 0.38 下降到 + 0.11。全部 10 个 block 都下降;平均变化−0.28,95% 配对 t 区间大约 [-0.36, −0.19]。使用对照请求降低噪声,不把重复请求当成独立实验。

图 4:新增无关选项,会不会改变原有两个选项之间的赔率?每行是一个随机 block。灰色点 = 4 选项;紫色点 = 追加坏天气的 5 选项。如果是固定独立 logit + 固定 softmax 温度,两点应该重合。观测到全部 10 组下降,均值变化−0.28。区间基于 10 个 block 配对 t 检验(自由度 9);概率舍入、请求噪声、依赖列表的温度都可能贡献这个偏移。仅证明选项之间存在相互作用,不能定位模型内部发生位置。
这个结果否定 “固定独立 logit + 不变 softmax”,但不能唯一锁定机制。更换新增选项描述,保持 5 个选项不变,偏移量变小、区间包含 0,结论不确定。依赖集合的温度、内容驱动的混合机制都有可能。
“读出头读取完整选项列表” 可以自然解释该现象:新增选项改变读出头看到的上下文。论文https://arxiv.org/abs/2406.15657列表排序方法思路一致:从首 token logit 提取排序,而非逐 token 生成。
有两种读出方案符合观测证据:
-
末位置头:从决策 token 表征,对每个选项槽打分; -
指针式打分器:拿决策表征,和每个选项自身的最终隐状态做对比。
两种方案都允许选项互相影响。API 限制最多 255 个选项(2⁸−1),很适配固定 256 槽头;但这个上限是 API 校验层限制,不是模型本身。200 选项测试中,复制答案在任意位置都得到 1.00 概率,错误不会扩散到邻近选项,这个现象更贴合指针方案。两组实验都无法决定性二选一。
注入假选项不会挤掉真实选项,说明选项边界有特殊标记,普通文本无法伪造;列表内存在重复条件的选项,概率会被竞品分流。
普通分类任务同样能看到顺序效应:调换选项顺序,技术支持分类概率从 0.84–0.89 变为 0.93–0.96。这来自选项顺序探测实验。对于上线业务策略,这个影响至关重要:阈值设为 0.9 时,哪怕证据、标签完全不变,仅仅调换顺序就会改变业务动作。任何这套架构落地,都必须做排列置换测试评估。
5. 训练分布,再计算置信度(Train the distribution then calculate confidence)
第五个组件是训练目标。直接输出数值省去解码开销,但输出的概率依然可能校准很差。
想象一组案例,模型给出紧急概率 0.8。校准(calibration)的含义:在大量同类样本里,大约 80% 确实是紧急事件。校准是跨样本集合的统计属性;单个样本预测结果,无法判断它是否校准。
TypeSafe 把训练方法命名为 RLCD:Reinforcement Learning for Calibrated Decisions,校准决策强化学习。发布材料描述它优化 “System One 任务上具备认知诚实概率的答案”;官方入门文档把 RLCD 描述为预训练 LLM 的后训练路线。确切配方没有公开。我猜想的训练方案:基于结果的目标函数,微调 Transformer 与读出头,适配类型化决策任务。让骨干网络学习生成对可靠决策有用的表征,而不只是流畅续写文本。
合理损失函数可以是对数损失 \(-\log p(y)\),或者 Brier 损失(预测分布与 one-hot 真实结果的平方距离)。两者都是恰当评分规则:期望上,输出真实条件分布可以最小化损失。Gneiting 与 Raftery 给出正式定义与理论。这解释这类训练目标要达成什么;但无法确定 TypeSafe 实际使用哪种损失、是否是狭义强化学习、是否更新全部骨干权重。
恰当评分规则,不等于上线部署一定校准。有限数据、模型缺陷、优化误差、分布偏移,都会造成校准偏差。训练校准与事后校准可以叠加;仅凭 API 无法区分两者贡献。
✅ 观测证据:基准数据可以对比预测概率与实际准确率,做全局与分 bin 校验。下图做了这类检查。单纯均值吻合说服力弱:一组过自信、一组欠自信,均值可以互相抵消。 1200 条 MMLU 样本,10 等分 bin,预期校准误差 ECE=0.0313。大部分预测高度确定:990 条落在 0.9–1.0 区间。
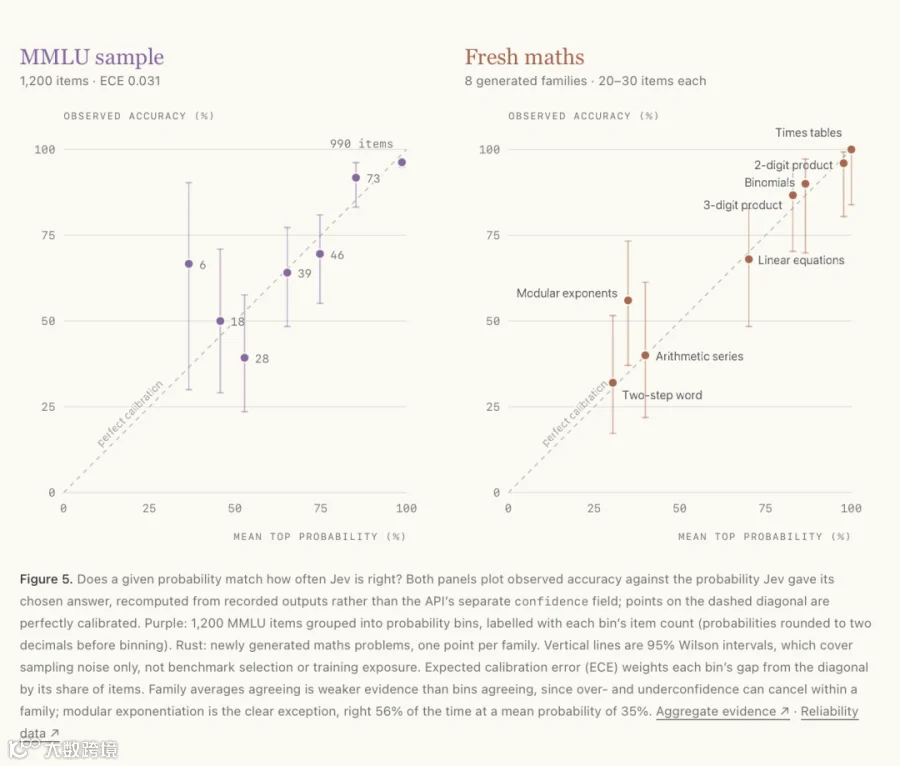
图 5:Jev 给出的概率,和真实正确率是否匹配。横轴模型给出的平均最高概率,纵轴观测准确率;虚对角线 = 完美校准。紫色:1200 条 MMLU 样本按概率分 bin;棕红色:新生成数学题,一类一个点。竖线是 95% 威尔逊区间,仅代表采样噪声,不包含基准选择、训练暴露偏差。ECE 按样本权重计算每个 bin 与对角线的差距。族内均值吻合说服力弱,族内过 / 欠自信可以抵消;模幂运算是明显例外:平均概率 0.35,实际正确率仅 56%。
小规模全新数学测试提供更多变化:三位数乘法,准确率 86.7%,平均最高概率 0.83;两步应用题准确率降到 32%,平均概率 0.30。难题置信度自动降低,这个现象很有价值。但小类别均值,不能保证所有未见过任务都具备良好校准。
这个结果同时说明:公开基准分数不能完全代表模型的真实能力。MMLU-Pro 84.6%,但全新生成应用题难度高很多。任务结构、干扰项、难度、训练见过与否,都造成差距。这个差距不能证明基准污染;全新措辞,不代表底层数学知识是模型从未见过的。
API 里还有一个单独confidence字段,这里有一个非常清晰的发现。Python 适配器开源代码定义了 Choice 置信计算公式(K>1):
\(c=\frac{p_{\max}-1/K}{1-1/K}\) 3 选项,最大概率 0.8,则 c=0.7。单选项单独处理,返回 1。它衡量第一名答案相对均匀分布高出多少。不是模型额外学习的 “答案正确概率估计”。Score 类型使用另一套公式,衡量和众数等级的距离。
在这套架构里:训练产出预测分布;置信字段只是简单算术派生。把两者分开,避免一个常见误区:分布高度集中,依然有可能自信地给出错误答案。
6. 稀疏容量(Sparse capacity)
我推测 Jev 使用稀疏混合专家 MoE Transformer。在部分层,路由函数把每个 token 送入一小部分前馈网络。模型可以存储海量参数,但每个 token 只激活一部分。也就是 Shazeer 等人提出的稀疏门控 MoE 思想。
无法从外部直接观测稀疏专家,但这是最合理选择。Prefill-only 模型瓶颈是计算量,而稀疏路由刚好节省计算。MoE 常规的服务开销在这里大幅消失:没有逐 token 解码阶段(解码时带宽压力大,大量专家被激活),也没有长期 KV 缓存和专家权重争抢显存。实测延时也支持猜想:Jev 处理 30k token 大约 160ms;8×H100 节点上稠密 70B 模型大约需要 1 秒,而激活参数约 10B 的 MoE 可以达到这个速度。近年顶尖基础模型(DeepSeek-V3、Qwen3、GLM-4.5、Kimi K2、gpt-oss)大多都是 MoE。专用硬件也可以让稠密模型达到同等速度;基准分数也可能高估模型知识量,所以这依然只是推论,不是实测结论。
架构其余部分,不依赖 MoE。换成稠密 Transformer,接口、共享 state、隔离分支、读出头完全不变。
7. 将分支批量调度,而非作为对话(Schedule branches as a batch, not a conversation)
最后一个组件:推理引擎,把各个问题分支当成独立任务。多个后缀打包成 batch,同时读取共享 state 表征。业务代码把数值输出关联到问题 ID,序列化返回响应。
观测到:重复相同请求,返回存在微小差异,哪怕同一个请求内的重复问题。不能假设 API 完全确定性(噪声、重复、确定性小节)。这不代表模型在采样生成文本:数值内核、动态批处理、路由、显式随机,都可以影响直接读出结果。
返回 key 顺序存在少量固定模式。可能原因是多个 worker,哈希排序不同。但这个侧信道无法确定 worker 数量、KV 缓存位置、数值精度。这些实现细节,现有观测无法分辨。
架构核心要点:答案之间不存在依赖链。模型不需要等工单分类计算完成,才开始评估紧急程度。两者都依赖 state;互不消费对方输出。
但仍然存在依赖限制:如果后一个问题真的需要前一个问题的答案,业务层必须增加另一轮决策阶段,或者合并成单个联合问题。共享上下文,不会消除工作流本身的逻辑依赖。
什么证据会改变我的结论?
这套重构有不同置信层级。直接概率输出,属于官方公开信息;问题隔离、选项顺序效应,属于可观测行为。KV 共享、因果注意力、末位置 / 指针读出头、稀疏专家,属于越来越具体的解释猜想。
参考卡片实验解决一件事:决策可以读取放在末尾的选项。假选项实验证明:输入文本不能伪造选项边界。更多关系类任务,可以进一步约束表征;但行为表现再好,也不能唯一锁定注意力掩码。
选项处理层面:重复实验复现了选项集合效应,但修改描述的对照实验结论尚不明确。更多模板、独立请求块,可以区分是全局温度变化,还是内容驱动的相互作用。中等难度、200 选项的任务,有可能区分槽头和指针打分器。校准层面,真实业务分布下的留档数据 + 分布偏移下的多次评估,比单纯基准分数更重要。想要确认稀疏专家,大概率需要官方披露,超出本次 API 探测能力。
我目前最合理的 Jev 架构复原,就是开篇示意图:带共享 state 前缀的因果 Transformer,隔离的问题后缀,列表级选项处理,类型化数值读出,面向预测分布的训练目标。骨干大概率是稀疏 MoE,但其余架构不依赖 MoE。
这套架构的价值,是计算图匹配任务本身。决策服务需要读取证据、对比允许结果、输出不确定性。Transformer 完全可以做到这一切,不必把每一次决策都先转换成一句话文本。
实验方法
本文基于 2026 年 9 月 17 日对 jev-1.13.0 版本的探测,使用一个早鸟账号、单一服务区域。原始研究包含 1029 条探测记录(含 190 条生成数学题)、6800 条基准记录,以及独立事实校验。后续补充 146 条关系与选项交互请求。 还有 311 条 token 计费、445 条分词器指纹、192 条延迟扫描、148 条选项数量延迟、181 条选项位置、105 条假选项、35 条上下文限制请求。每一条都在参考链接内,包含原始请求与脱敏响应。重复基准配置复用样本;计数不等于独立问题数量。
延时取自x-envoy-upstream-service-time响应头,代表上游服务耗时,队列与模型执行边界未知,不是隔离模型计时。延时扫描逐个请求、打乱顺序运行;没有控制服务器负载。不使用本地墙钟时间作为架构证据。
概率一般返回两位小数。同一个请求里的重复问题条件相同,误差可能相关。MMLU 校准采用 10 个等宽 bin:[0,0.1) 一直到 1.0 归入最后一组。预期校准误差 ECE,是每个 bin 内准确率与平均最高概率,按样本加权的绝对差值。估算结果受样本选择、分箱规则、概率舍入影响。证据只能支撑被测试分布下的结论,不保证未来任意客户业务流程都具备同样校准。
参考文献与相关工作
实验引用给出脚本标记,方便定位证据包内观测;论文引用用于说明可行机制,不等于证明 Jev 采用该方案。
[1]https://typesafe.ai/blog/introducing-system-one-models-and-jev [2]https://docs.typesafe.ai/llms-full.txt[3]https://arxiv.org/abs/1706.03762 [4]https://archerhume.com/research/jev/evidence.json[5]https://archerhume.com/research/jev/evidence.json [6]https://archerhume.com/research/jev/latency-rerun.json[7]https://arxiv.org/abs/2402.05099 [8]https://arxiv.org/abs/2404.00242[9]https://archerhume.com/research/jev/evidence.json [10]https://archerhume.com/research/jev/evidence.json[11]https://arxiv.org/abs/2406.15657 [12]https://docs.typesafe.ai/introduction/machine-learning-primer[13]https://sites.stat.washington.edu/raftery/Research/PDF/Gneiting2007jasa.pdf [14]https://arxiv.org/abs/1706.04599[15]https://archerhume.com/research/jev/evidence.json ; https://archerhume.com/research/jev/calibration.json[16]https://github.com/typesafe-ai/system-one-adapter-python/blob/fb52b1030b7fc1f4f1cf39910afa5da54f9835e3/src/system_one_adapter/_utils/confidence_metrics.py[17]https://arxiv.org/abs/1701.06538 [18]https://archerhume.com/research/jev/tokenizer-fingerprint.json[19]https://archerhume.com/research/jev/evidence.json [20]https://archerhume.com/research/jev/followup-trials.json[21]https://archerhume.com/research/jev/followup-summary.json [22]https://archerhume.com/research/jev/context-limit.json [23]https://archerhume.com/research/jev/option-injection.json [24]https://archerhume.com/research/jev/output-token-accounting.json [25]https://archerhume.com/research/jev/option-count-latency.json[26]https://archerhume.com/research/jev/option-position.json
原作者:https://archerhume.com/posts/jevs-architecture-unmasked/?v=3