


AI 技术科普
AI 世界模型
2026年10月12日 · 约4分钟读完 · World Models & Predictive Planning
今天的新闻里有两条看着各说各的:LeCun 团队开源了 H-JEPA,让模型在抽象空间里做分层规划;Odyssey 放出 140 亿参数的 Odyssey-3,能按一句话实时生成可以进去走动的环境。
一个只"想"不画,一个"画"出来还能进。看似两条路,其实指向同一个东西:让 AI 在动手之前,先在脑子里把后果演一遍。这就是今天要讲的世界模型。
一
它是什么:从"接龙"到"在脑子里放电影"
先说清楚现在的语言模型在干什么。无论它写诗还是写代码,底层动作只有一个:根据前文预测下一个 token。它更像一个把人类所有文字背到滚瓜烂熟的人,靠"语感"接龙——它能写出"杯子从桌上掉下去会摔碎",因为它读过一万句类似的话,但它并不知道松手之后会发生什么。
世界模型(World Model)要补的正是这块。它让 AI 在内部建立一套"如果我这么做,世界会变成什么样"的推演机制,先演完再动手。专业一点说,就是学出状态转移函数——给定当前状态和即将执行的动作,预测下一刻的状态。
一个生活里的比喻
一个从没进过厨房的人,把菜谱背得一字不差,知道"开火、倒油、下菜"的顺序——这是语言模型。另一个在厨房炒了三年的人,知道油冒青烟就该下菜、湿菜叶下去油温会掉、锅太满会溅出来——这是世界模型。前者能答对试卷,后者才真的做得出一盘菜。
判断一个系统有没有世界模型,有个很土但好用的标准:你中途改一下世界,它能不能跟着改判断。你把杯子挪到桌沿,它得意识到"现在更容易掉了"。只会接龙的模型做不到这件事,因为它的答案在你说完之前就定了。
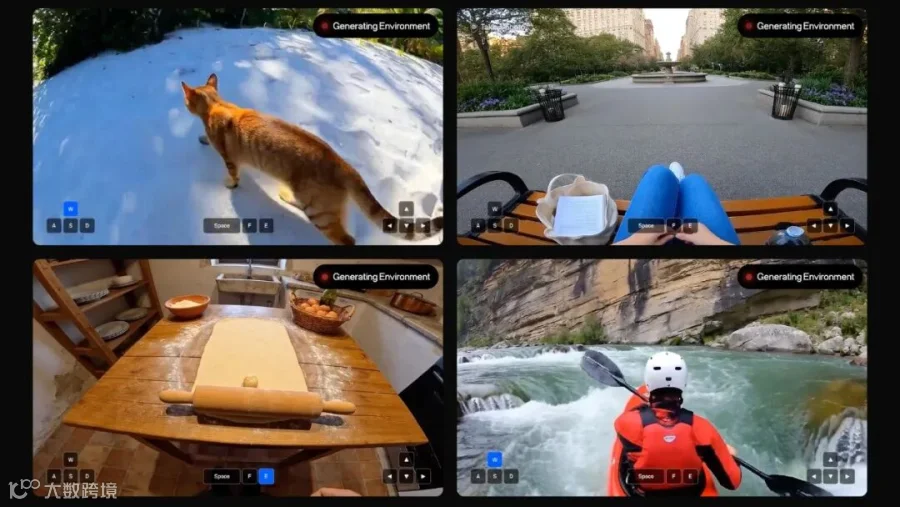
Odyssey-3 按文本提示实时生成的可交互环境:不是一段录像,而是一个能走进去的世界
二
为什么现在重要:三股力量把它推到台前
第一,靠"背"已经摸到天花板。语言模型的 scaling law 在文本上依然有效,但物理世界的因果关系没法靠语料穷举——你不可能把"所有物体在所有角度掉落的结果"都写成文字让模型背。世界是连续的,文字是离散的,中间隔着一道坎。
第二,机器人的数据太贵了。真机采集一条成功轨迹,要摆设备、要复位、要人工兜底,一次几分钟,还经常损坏硬件。仿真数据几乎不要钱,但仿真和现实之间有差距,这就是业界说的 Sim2Real Gap(仿真到真实的差距)——在模拟里跑得再好,上真机也可能摔个跟头。世界模型的价值在于:让大部分试错发生在"脑子里",只有最终验证上真机。
第三,智能体的动作变得不可逆了。过去的模型最坏也就是骂人;现在的模型能提交表单、能改数据库、能控制机械臂。微软 CEO 纳德拉最近提出要给 AI 装"紧急刹车",本质诉求是同一个:动作一旦不可撤销,你就必须先知道它会带来什么。而"知道后果"这件事,只有世界模型能提供。
三
核心原理:三步闭环 + 五个术语
世界模型不是拍脑袋来的,它有一套固定流程:① 编码——把眼睛看到的原始画面压成一串紧凑的状态描述;② 推演——在内部模拟执行某个动作之后的状态变化;③ 对账——拿推演结果和真实发生的事对比,算误差、回传修正。三步循环往复,模型对世界的"手感"越来越准。
下面这五个词,你在任何一篇世界模型的论文里都会撞见:
① 潜在表征(Latent Representation)
把高维的原始观测(比如 1080P 的画面,两百万个像素值)压缩成一串低维数字,只保留"做决策用得上的"信息。
大白话:不是把整段监控录像存下来,而是记一句"杯子在桌沿,桌高一米,地上是瓷砖"。省掉了无关细节,留下的全是能用来判断"会不会碎"的信息。
② 自监督学习(Self-supervised Learning)
不需要人工标注数据,用数据自身的结构构造监督信号——遮住一部分让模型猜,猜错了就修正。
大白话:相当于自动出"填空题"。给模型看一段视频,把中间几帧挖掉让它补;补对了说明它真的懂物理,补错了就扣分。整个互联网的视频都是免费教材,不需要雇人标注。
③ 表征坍塌(Representation Collapse)
训练中的典型失败模式:模型发现"不管输入什么,都输出同一个固定答案"就能让损失降下来,于是所有输入被压成同一个点,信息量为零。H-JEPA 用了名为 SIGReg 的技术来防止这件事。
大白话:像学生答题,发现不管问什么都写"同意"能拿一半分,于是整张卷子全是"同意"。分数看着不低,其实一个字的信息都没提供。防坍塌就是断了这条偷懒的路。
④ 分层规划(Hierarchical Planning)
不在同一层里规划所有细节,而是多层堆叠:高层只定粗略目标,把预测的中间状态当作子目标交给低层,低层再细化成可执行的动作序列。
大白话:先定"从北京去上海",再拆成"打车去车站—坐高铁—转地铁",最后才具体到"左转、迈左脚"。H-JEPA 的实测很能说明问题:同一个迷宫任务,三层模型成功率 73%,单层只有 18%。

H-JEPA 论文图:三层 JEPA 自上而下规划,第 1 层预测 5 步、第 2 层 10 步、第 3 层 20 步(来源:arXiv:2610.06805)
⑤ VLA 与 Sim2Real
VLA(Vision-Language-Action,视觉-语言-动作模型)把"看见场景、听懂指令、输出动作"合成一条端到端的链条;Sim2Real 指模型在仿真环境训练后迁移到真实硬件上部署,两者之间始终存在性能落差。
大白话:一个是"眼睛、耳朵、手"连成一根筋,不再各管各的;另一个是"在驾校模拟器上练的方向盘,真上路还是有点飘"——这道坎是所有机器人公司成本的大头。
顺带带出两个容易在论文里被略过、但工程上极其要命的词:开环与闭环——开环是"规划完一路执行到底,中途不看来没达成",闭环是"边做边看,发现偏了立刻改";以及分布外泛化(OOD)——训练时没见过的情况,模型还能不能对付。叠衣服之所以难,就是因为衣物的形变状态几乎是无穷的,永远都在分布外。
四
它和"视频生成"有什么区别
这是最容易混的地方。用一句话切开:视频生成给你的是一段录像,世界模型给你的是一个沙盘。
录像只能顺着看,你在旁边推一把,画面不会有任何反应;沙盘可以被你推动,你推了杯子,后面的每一步都会跟着变。所以生成模型考的是"画面像不像",世界模型考的是"我做了 A,结果是不是 B"——前者考的是像真度,后者考的是因果正确性。
还有一层区别常被忽略:视频生成必须把每个像素都算出来,昂贵且容易在细节上露馅;而以 JEPA 为代表的一类路线根本不生成像素,只在抽象空间里预测状态。LeCun 坚持这条路的理由就在这——他多次公开表示,像素级的细节大量浪费算力,而真正做决策需要的只是"杯子快掉了"这一个信号。
五
回到今天的新闻:能读出什么
H-JEPA 代表的是"抽象派"。LeCun 任董事长的 AMI 联合纽约大学、巴黎 INRIA 与布朗大学发布,多个 JEPA 逐层堆叠,各层在自己的表征空间里预测不同时间跨度之后的状态,高层定计划、低层补动作,并用 SIGReg 防止表征坍塌。代码和预训练权重同步公开,Visual AntMaze 迷宫任务里三层 73%、单层 18%——这个差距基本说明了分层是不是必需的。
Odyssey-3 代表的是"生成派"。140 亿参数,按文本提示实时生成可交互环境,官方称能控机器人和无人机,并演示了兼容 GTA V,预览期免费。值得留意的是,Odyssey 自己主动承认物理基准的评测方法存在局限——这种自我标注在当下并不常见,也提醒我们:世界模型的成绩单,目前还没有公认的尺子。

Odyssey 公布的物理基准成绩,官方同时注明评测方法存在局限
国内这边有一条容易被归错类的新闻。雄安企业稳准智能联合清华的"极数"LimiX-2 在三大国际榜单登顶,主打因果稳定学习。它处理的不是图像而是表格、时序、图谱这类结构化数据,但思路同宗:不满足于找到变量之间的相关性,而要找出因果结构——这其实就是世界模型在数据表上的另一个版本。
六
做 AI 产品的人,该记住三句话
1. 别把"能生成画面"当成"懂物理"。画面流畅和因果正确是两回事。做产品选型时,用"中途改条件看它跟不跟得上变化"来测,比看 demo 视频靠谱得多。
2. 机器人场景先把仿真跑通,再谈真机。Sim2Real 的落差是真金白银。今天西湖机器人 WR1 演示自主叠衣之所以稀罕,正因为柔性衣物的形变在仿真里最难还原,谁先把这块补上,谁先拿到长任务链的门票。
3. 不可逆的动作,必须配预判层。自动驾驶、机械臂、自动化交易、批量改数据库——凡是"错了收不回来"的场景,都要在执行前加一层后果推演,并且保留人工中断的入口。这是世界模型真正该被用上的地方。
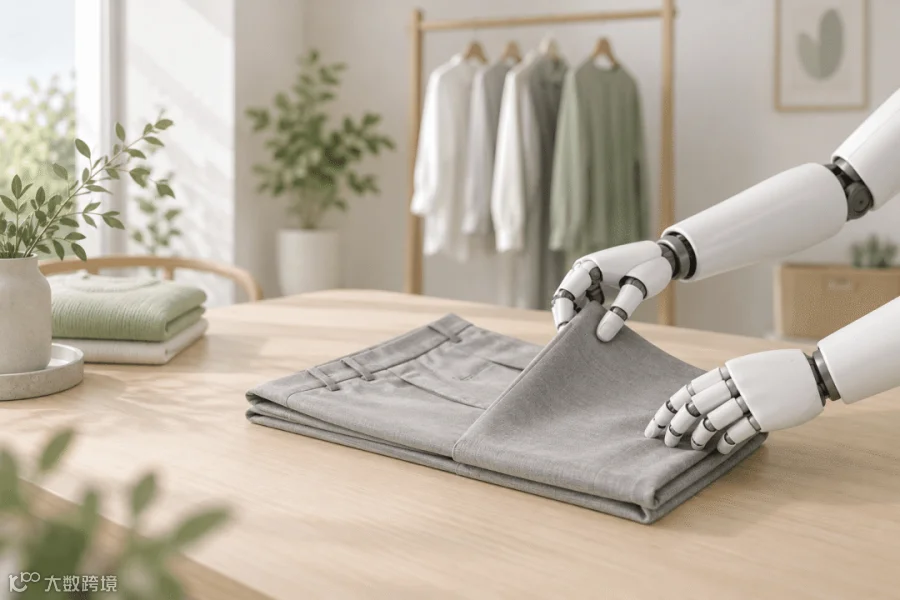
西湖机器人 WR1:柔性衣物的形变是仿真里最难还原的一类,也是 Sim2Real 落差最集中的地方
一句话记住
语言模型让 AI 会说,世界模型让 AI 会想——而"想"的第一步,是能在动手之前,先在脑子里把后果演一遍。
KunlunMeta · AI 科普
长按二维码,识别关注我们!