

最近,姜东甫(Dongfu Jiang)在X上官宣,博士答辩顺利完成,下一站将加入 Meta FAIR,担任 Research Scientist!
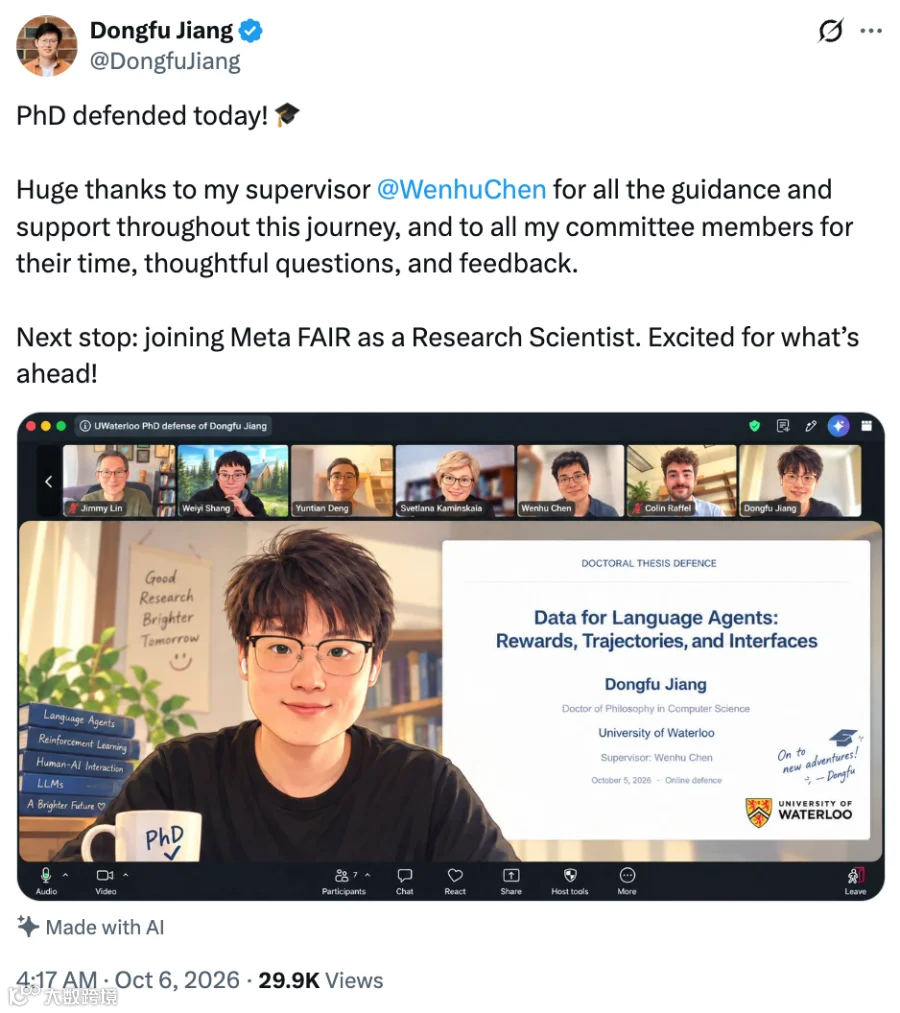
姜东甫本科毕业于浙江大学计算机科学与技术专业,随后前往加拿大滑铁卢大学攻读计算机博士,师从陈文虎教授。
博士期间,他的研究逐渐聚焦于大语言模型、多模态推理以及AI Agent,尤其关注如何通过数据、强化学习和工具使用,让大模型从“会回答问题”进一步走向“能够自主完成复杂任务”。

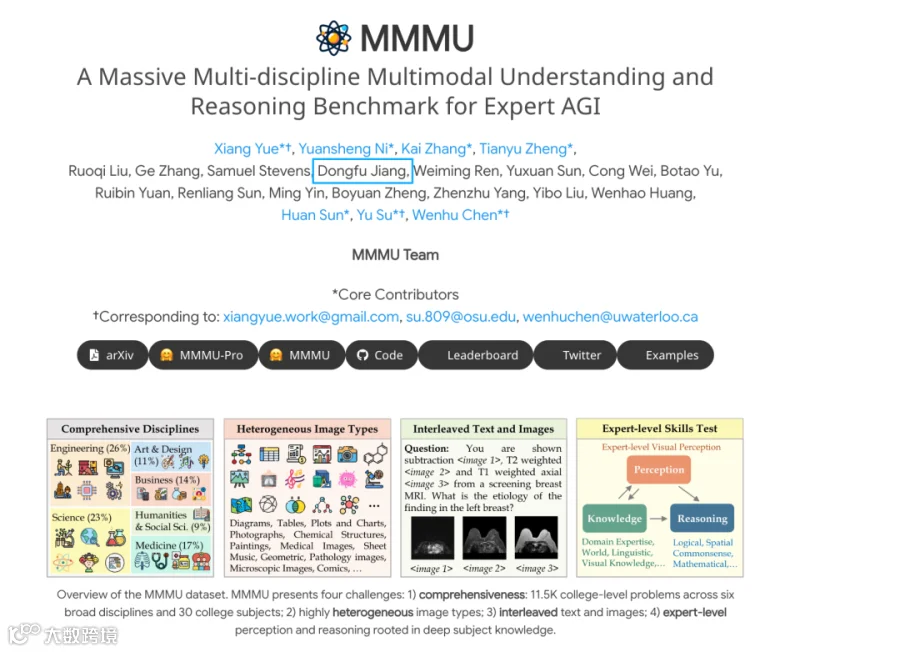
很多人第一次注意到姜东甫博士,可能来自MMMU。
MMMU是一个面向多学科、多模态理解与推理的大规模Benchmark,覆盖大学级别的专业知识。该工作入选CVPR 2024 Oral,并成为Best Paper Finalist,后来也被Llama 3、LLaVA-OneVision、Kimi-VL等大量多模态模型和评测工作采用或引用。
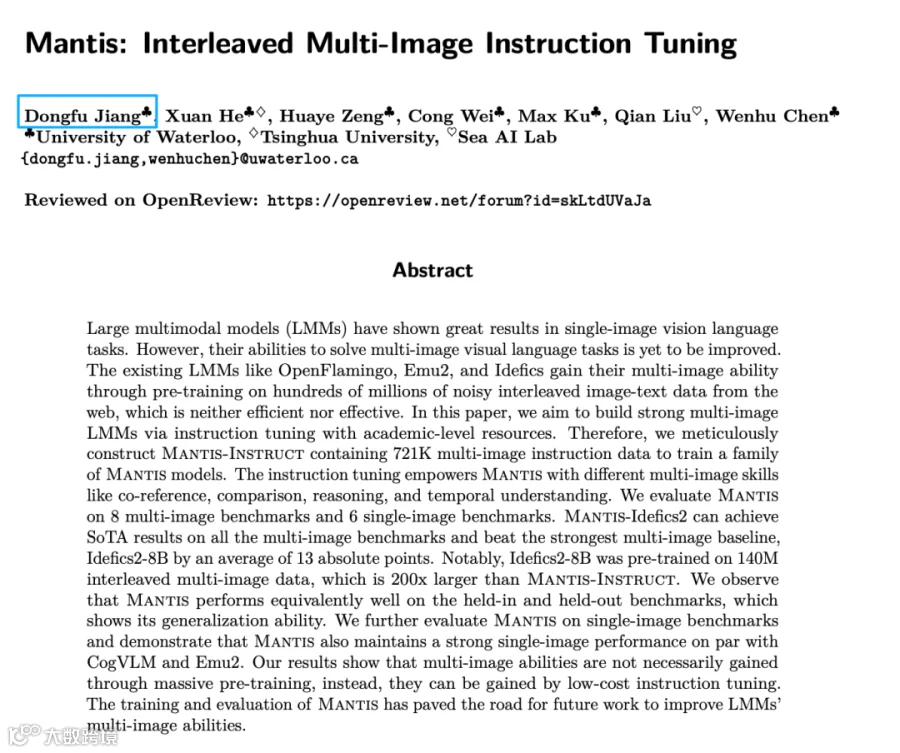
之后,他又参与推出Mantis,将研究进一步延伸至多图理解,探索模型如何处理文本与多张图片交错输入的复杂场景。该工作后来获得TMLR 2025 Outstanding Paper Award。
最近两年,姜东甫的研究重心开始转向更热门的Agentic AI方向。
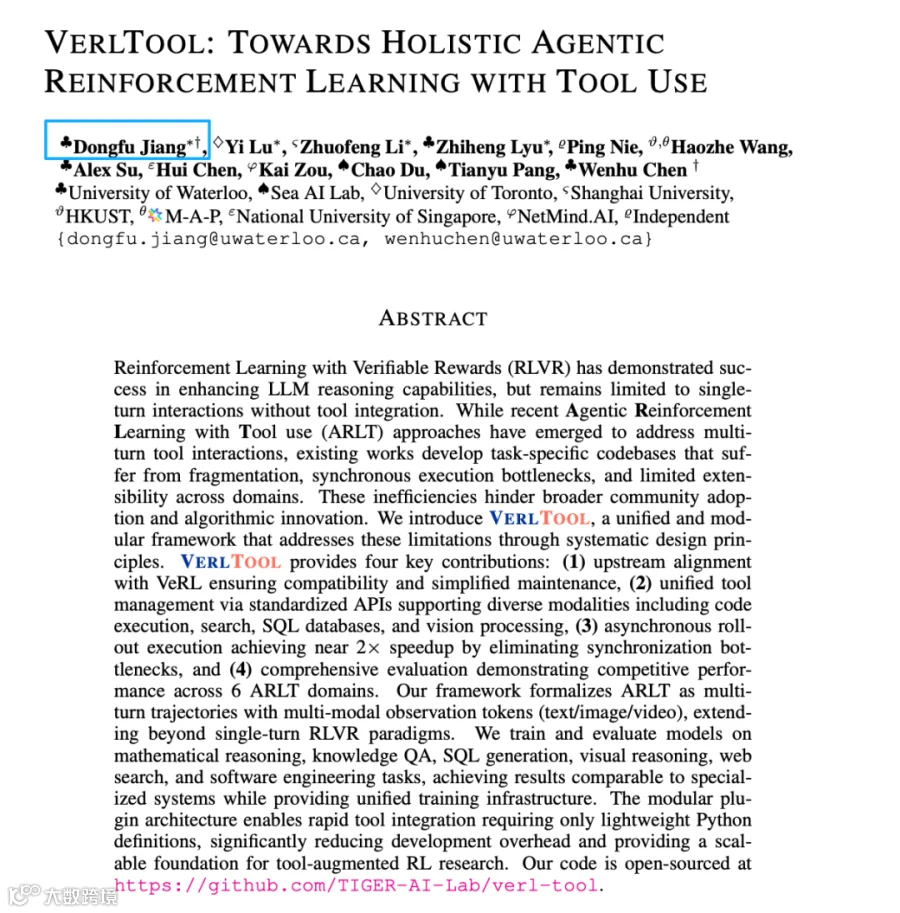
2025年,他参与开源VerlTool,试图解决Tool-using Agent强化学习基础设施碎片化的问题。
现有不少方法往往围绕特定任务开发独立的训练代码和工具环境,而VerlTool希望将这些能力整合进统一的强化学习框架,支持代码执行、搜索、SQL数据库和视觉处理等不同工具。
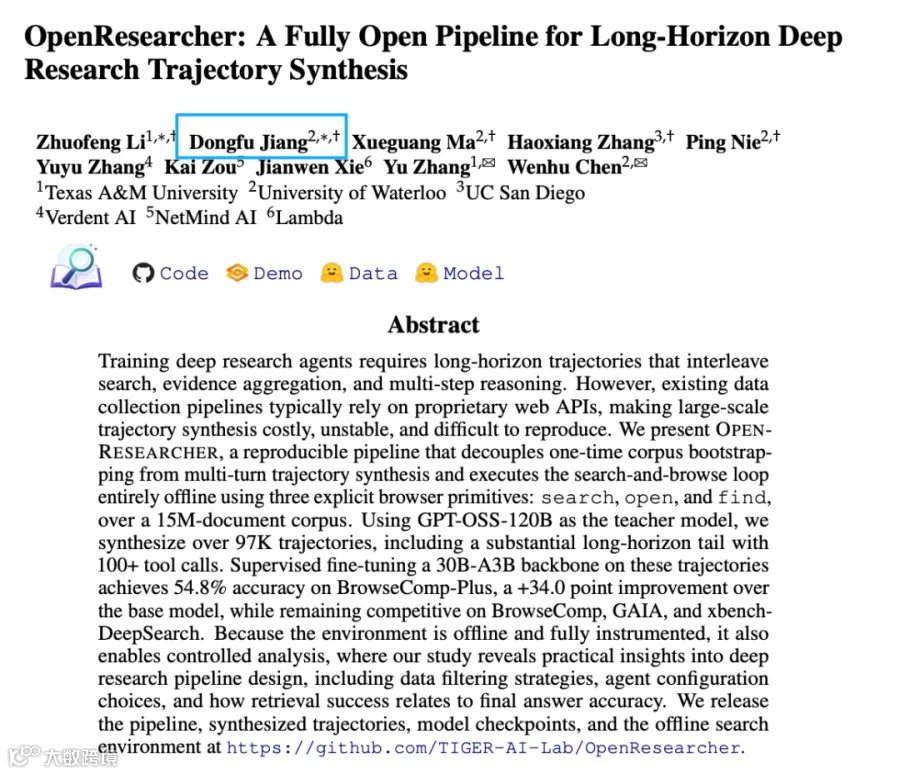
今年,他又参与推出OpenResearcher,进一步瞄准Deep Research Agent的数据问题。
与普通聊天模型不同,一个真正能够进行Deep Research的Agent,可能需要连续搜索、浏览资料、判断信息价值,并在几十甚至上百次工具调用之后才能完成任务。
因此,如何获得高质量的长程Agent轨迹,正在成为训练这类模型的重要问题。
OpenResearcher正是围绕这一方向展开:团队基于约1500万篇文档构建离线搜索环境,并合成超过9.7万条Research Trajectory,其中还包括大量需要100次以上工具调用的长程轨迹,为训练能够自主研究的Agent提供数据。
与此同时,姜东甫也积累了不少工业界前沿大模型研发经历。
2025年,他进入NVIDIA ADLR担任Research Intern,研究Agentic Reinforcement Learning和Tool Use,并参与Nemotron系列模型的Post-training工作。
他的博士论文题为《Data for Language Agents: Rewards, Trajectories, and Interfaces》,核心关注Language Agent训练中的三个关键元素:奖励、轨迹和接口。
预训练可以让模型获得大量知识,但要让模型真正成为Agent,仅仅“知道答案”还不够。它还需要学会使用工具、与环境交互、从长程轨迹中学习,并根据反馈不断调整自己的行为。
而随着Meta持续押注大模型、强化学习与智能体研究,这位长期围绕Agent展开研究的年轻学者,接下来会做出什么样的工作,也值得继续关注。
END
关注+星标,获取AI前沿进展与开源一线动态