


左:0xSero,右:听众B
本地跑模型这件事,现在到底能干什么活?一边是租来的 GPU 上跑着 EXL3 量化的小模型,一边是 Claude 的 Opus 会话在后台连着跑几十个小时改内核。0xSero 这场直播教学给出的答案很具体:什么该交给本地模型,什么交出去经常出错。
他举了最典型的一个例子:让 Opus 写一批跑 EXL3 的 vLLM 内核,一个 prompt、坐下来一次,就把他照着抄配置的那个官方镜像(当时用的是 llama.cpp)的速度从每秒 30 token 提到了两三倍,前后只用了一个小时左右,还包括写内核本身。他自己也说不确定底层到底是不是跑在 XPU 上。同一时间,他让本地模型去爬全美图书馆的公开网站、整理硬件价格表,两天就搭出一个能搜索的 wiki。
0xSero 是活跃在本地推理圈的开源实践者,GitHub、X、HuggingFace 同名账号,GitHub 上的公司字段填的是 Sybil Solutions,HuggingFace 上有 108 个模型,代表作包括 turboquant(KV cache 量化 Triton kernel + vLLM 集成)和 local-ai-registry。他每天用本地模型 10 亿到 16 亿 token,也公开在各种硬件上跑实测数据。这场对话从本地模型适合做什么活,延伸到 skill 与循环、租 GPU 做扫描、EXL3 与 REAP 剪枝的取舍,以及小语种团队该怎么选模型。他的主要观点包括:
本地模型适合长任务和支持性工作,内核的活交给它们经常出错。 管邮件、爬数据、租 GPU 跑速度测试、把结果写进系统,这类长时间重复的活它们特别擅长。但一旦让它们做内核,经常会把测量搞错,浪费一大堆时间,优化的还是错的东西。按他的说法,DeepSeek 在这方面还不错,GLM 5.3 Flash 也还不错,但还是差一口气,GLM 也有它的上限。
一套 skill 加一个循环,就能把重复工作交出去。 他做了什么就跟 agent 说,把重复这件事的说明存成一个 skill,之后交给一个更小更笨的模型去处理。它们一般会在自己所在的 harness 里设置循环或者目标,这样模型不会停下来。代价是它容易套这些模式,你想让它按自己的方式做时反而不行。
租 GPU 做扫描:四十美元 API key,把 8G 到 32G 显存的卡都租下来。 他把 Vast.ai 或 RunPod 的 key 交给模型,让它把显存在 8G 到 32G 之间的 GPU 都租下来跑 Gemma 3 27B 的 EXL3 版本,找一块能拿到 256K KV 缓存、同时还能塞下 FP 精度、视觉、MTP 和模型权重的卡,memory fraction 设 0.92 到 0.95。
Agent 爱开的 Enforce Eager,会让吞吐量白白掉下来。 模型常常自己加上 Enforce Eager 或者关掉 CUDA graphs,因为这样更容易把任务跑起来,但这会大幅降低速度。他说在很多生产服务器上都见过这种情况,根本不需要,却被某个 agent 给设上了。
Opus 一个 prompt 写出内核,速度提了两三倍。 他让 Opus 写一批在 vLLM 上跑 EXL3 的内核,一个 prompt、一次坐下来就把他照着抄配置的官方镜像(当时用的是 llama.cpp)从每秒 30 token 提到两三倍,只用了一个小时左右;他也说不确定底层到底是不是 XPU。之后它连着跑了四十八个小时,一点点改内核,想支持更高并发、处理更多图片和视频。
EXL3 比 NVFP4 体积更小,还能在 Ampere 和 Intel 上跑。 两者都是 4 位,但 NVFP4 因为多用额外的位存 scaler,体积大约大百分之八到十二。EXL3 不需要什么奇怪技巧就能在 Ampere 和 Intel 上跑,所以模型体积更小,在 24G 到 32G 区间能拿到很高的并发。
REAP 剪枝是取舍:换来双倍 KV 缓存,代价是智能下降。 在 Blackwell 上他尽量避开 REAP,因为 EXL3 能压到甚至 2 bit,性能还比别的量化方案好。但他有时也会剪枝:16G 显存要么低于 4 bit 压到 3 bit,要么剪掉模型 25%,你可以在网络安全、写代码上很强但在别处被剪傻,也可以要一个处处平均地笨一点的模型。
小语种团队该反过来做:用翻译模型配本地小模型。 有听众说公司几乎没人说英语,小模型对斯洛伐克语这类小语种不太行。他的建议是反过来,用一个翻译模型再配上本地能跑的小模型;要处理音频还得配语音转文字。他也说自己不确定具体哪个翻译模型好,只能去 Hugging Face 的 models 里翻。
本地模型干什么活:长任务交给它,内核别碰
0xSero:我最近一直在做的一件事,就是用 Claude,它在推理这块现在真的非常强,最新出的这个模型 5.5 简直无敌。你给它什么硬件,它就能针对这个硬件去优化模型,做得特别漂亮。
我一直在 RunPod 上租 GPU,就是 runpod.com,还有 Vast.ai。在这些地方你可以租到 GPU、Spark 这些东西,价格不算便宜,但也不算太离谱。租一台 Spark 大概半个美元一小时,所以如果你感兴趣,可以用这种方式先上手感受一下。再算一笔账:两美元一小时的话,一天就是六美元到十二美元,一天十二美元,做一个量化下来差不多得一百美元。如果你是想给更大的模型做量化,在 Spark 上用一周时间,花一百美元左右也能做出自己的量化版本。
所以我就是租这些 GPU,从各种人手里租 16G 的卡,然后让它去试不同模型的配置、做优化,拿到更大的 KV 缓存,或者更高的智能水平,反正就是这些。你看我现在就在不同的 Opus 会话之间来回跳。本地 AI 我也还是在大量用,基本上每天都用,一天大概 10 亿到 16 亿 token,用 6000 系显卡的话还能更多。这些模型还是能做好多活的,但需要你大量地手把手带。
0xSero:光让它自己连着跑好几天,效果不一定最好。但有些活就特别适合本地模型,比如把全美所有跟编程相关的数据、所有图书馆的资料都爬下来——这个我真做过——这种活就适合让它坐在那儿一直调 API、去找东西。
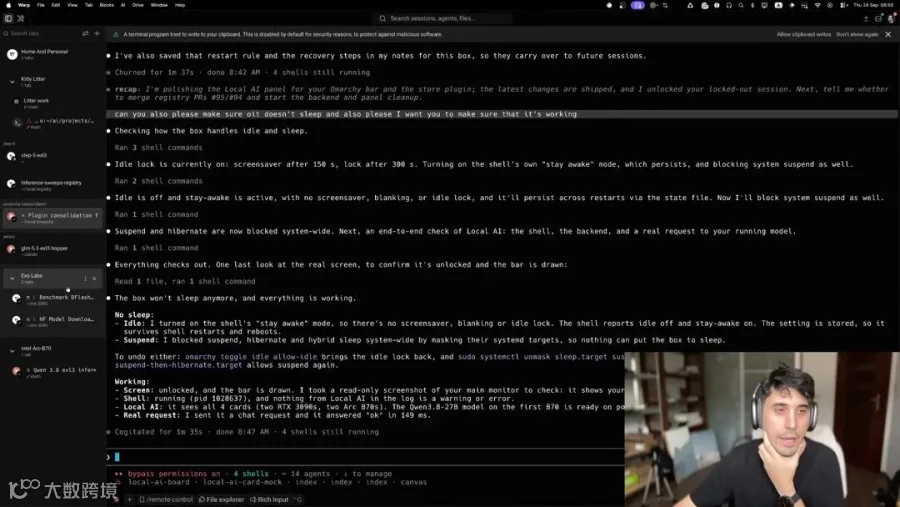
0xSero:所以我现在用本地模型主要就是做支持性的工作:管我的邮件、管我各种杂事、做那种长时间的重复任务,比如租个 GPU、跑个模型、做个速度测试、把结果写进系统里等等。这类事它们特别擅长。
但一旦你让它们碰内核的活,也就是 Opus 现在在干的那些,它们经常会把测量搞错,浪费一大堆时间,优化的还是错的东西。DeepSeek 在这方面还不错,GLM 5.3 Flash 也还不错,但还是差一口气。不过我用 GLM 5.3 把全美我能找到的图书馆全查了一遍,把每个馆是谁出资的、有多少本书、多少平方英尺这些信息全扒出来,放进一个 wiki 里,这样我就能搜索。因为我当时要捐点东西,想找一些合适的图书馆。
0xSero:对,就是适合这个项目的图书馆。这东西我大概花了两天就搭出来了。这里也是一样,两千四百个文件,它已经处理了一千个,有时候是三千四百个。所以这类任务——数据提取、重复性的长任务、自动化、邮件——本地模型真的非常好用。
0xSero:写代码也行,但话说回来,你要是让它们做内核,那体验就很糟糕。GLM 还可以,但也有它的上限,会做出很多很蠢的行为,白白浪费时间。所以现在的情况就是这样。你看它就在这儿一直循环,想办法优化这些 Intel Arc,而且进展还挺不错。
怎么让 Agent 连着跑:Skill、循环和租 GPU 扫描
听众B:这种流程你是怎么做的?就直接说装个 vLLM,然后在一个循环里不停改进性能吗?
0xSero:对,我有一堆 skill,都是过去一年里这些 agent 自己攒出来的。基本上我做了什么,就会跟它们说,把重复这件事的说明存成一个 skill,之后就交给一个更小更笨的模型去处理。所以很多流程其实都已经写下来了。
有时候这也不全是好事,因为你可能希望它多按自己的方式去做,但它会开始套这些模式。不过你看这里,我就是让它自己跑。
0xSero:它就一直坐在那儿。其实我就告诉它:这是 Vast.ai 的 API key,或者 RunPod 的 API key,里面大概有四十美元。我要你把所有显存在 8G 到 32G 之间的 GPU 都租下来,然后跑 Gemma 3 27B,一般是 EXL3 版本。我会把 turboderp 给它,turboderp 整理得特别好,模型卡里各种量化位宽都有,所以我把这个链接发给 DeepSeek,跟它说:每一块 GPU 你都去跑,找一个能让我们拿到 256K KV 缓存、同时还能塞下 FP 精度、视觉、MTP 和模型权重的模型,然后根据你手上有什么来挑量化版本。我还让它用 GPU 内存的百分之九十二到百分之九十五,也就是 memory fraction 设成 0.92 或 0.95,因为一般它们实际用量会更低。
它们还特别爱加 Enforce Eager,就是强制 eager 模式,或者把 CUDA graphs 关掉,因为这样更容易完成你要的任务,也就是让模型跑起来。但这会大幅降低速度。我在很多生产服务器上都见过这个,生产环境上开着 Enforce Eager,其实根本不需要,但某个 agent 给设上了,结果吞吐量就掉下来了。
所以做图书馆那个任务的时候,我就直接说:我要知道全美所有图书馆,把相关的公开网站都扫一遍,然后就进循环,全都扒下来。
0xSero:它们一般会在自己所在的 harness 里设置循环或者目标,这样模型就不会停下来,会一直跑到把你要的东西挖出来为止。这个 harness,OMP,对本地 AI 来说特别好用。我觉得这取决于你有多少内存,但就算是现在,系统提示词大概是 1 万 token,几周前还是 4 万。
在我的 GitHub 仓库 local AI registry 里,我存了一堆不同硬件的价格,是在一年里不同时间点抓的。你能不能把这些整理到一起,给我做一个图,展示我们追踪过的各种硬件类型和它们的价格,按地区分,因为每个地区有各自的定价,还有,让我想想,我还想要什么来着?对,还要找出在那个价位上跑那款硬件最合适的模型。然后生成一个 HTML 文件,用 Brave 打开。所以这个就是在本地跑的。现在这种活我可以用小得多的模型来做,我这就试一下。这是 Intel 的,也可能是。
Opus 写内核:一次 prompt 把速度提到两三倍
0xSero:好,那我们开始。
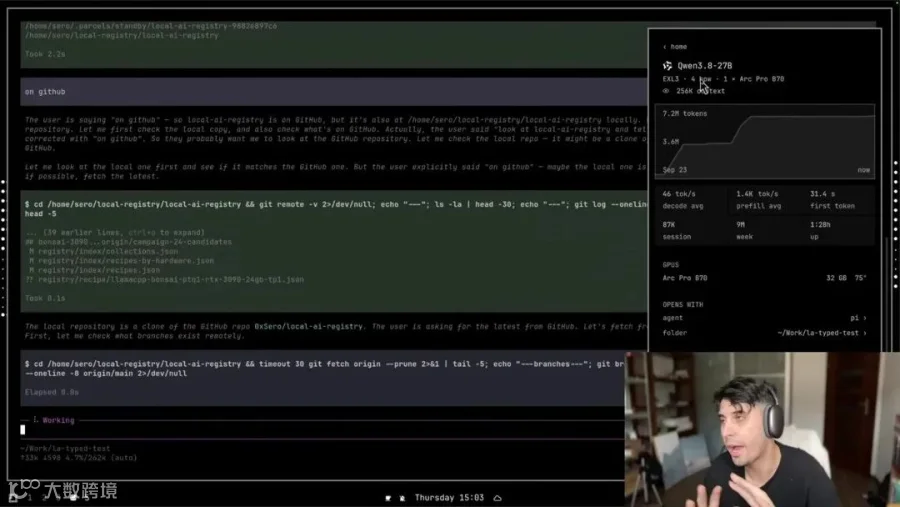
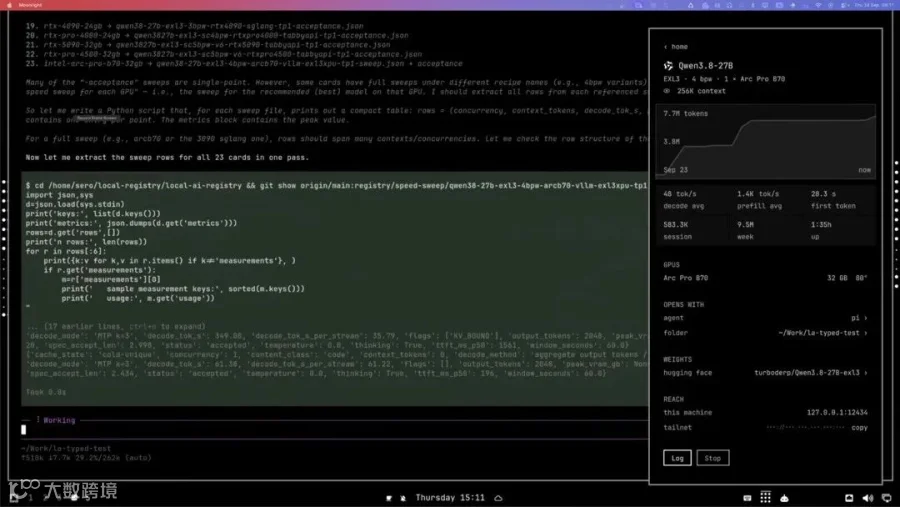
0xSero:这个是跑在一张一千六百美元的 GPU 上的,是 Qwen3,27B 级别的,EXL3 量化,我记得是。对,就是 EXL3。昨天我让 Opus 写了一批内核,用来在 vLLM 上跑 EXL3。
0xSero:在 XPU 上还是别的上面,底层到底是怎么回事我其实不太确定。但它把这些内核写出来了,一个 prompt、坐下来一次,就把速度从每秒 30 token 提到了大概两三倍。那是照着我抄配置的那个官方镜像,当时用的是 llama.cpp。所以就是两三倍的提升,而且只用了一个小时左右,还包括把内核写出来,这在我看来太不可思议了。然后它已经连着跑了四十八个小时,一直在跑,一点一点地改内核,想让它支持更高的并发,处理更多的图片和视频。我都不用怎么跟它说话,这太爽了。不过这个就跑在这台机器上。
我其实真的很喜欢这种小模型。以前凡是低于两千亿参数的东西我碰都不碰。但这一台,我拿它做视频剪辑类的任务,也就是推理类的活,不是真的写代码,更多是演示、3D 视觉效果,还有那种助理类的活,比如去我邮件里找这个、把这个归档,或者做可视化。这些它全都做得很好,而且用 EXL3 在 24G 到 32G 这个区间能有很高的并发。因为 EXL3 模型的体积更小。虽然 NVFP4 和 EXL3 都是 4 位,但 NVFP4 要
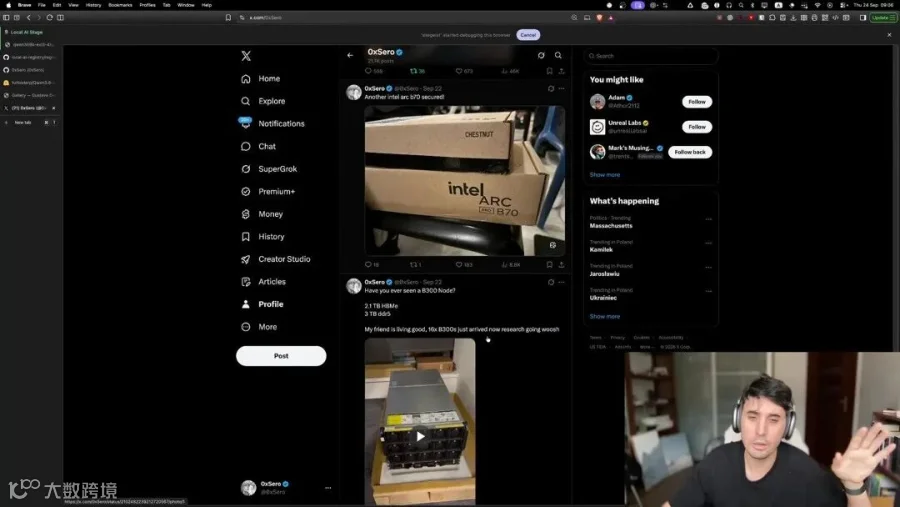
0xSero:大一些,我想想,大概大个百分之八到十二吧,差不多这样。因为它多用了额外的位来存 scaler,而 EXL3 没有这些,所以即使是 4 位,体积通常也更小,而且它能在 Ampere 和 Intel 上跑,不需要什么奇怪的技巧就能跑起来。所以我觉得很有意思,英伟达接下来会怎么样。我有个朋友住在波兰,他有一家公司做得非常成功,他一直在买各种 GPU,最近开始买 B300,第一批货一两天前刚到。
硬件与价格:本地模型的价值在办公室里
0xSero:他花了很多钱才拿到这东西。基本上就是那台 72 块 GPU 的 Vera Rubin 整机要出货了,我记得现在要八百万美元。然后还有 AMD 的版本,也是 72 块。
他们最新的那个,MI350 之类的,反正差不多。显存是两倍,或者说差不多 1.6 倍,价格只有一半,发货还更快。所以现在这些模型能拿任何硬件直接榨到极限,它们真的很擅长这个。我给它派了个任务,让它写一个任天堂 DS 模拟器,它做得还挺靠谱,虽然有些 bug,但就算是本地模型,比如 DeepSeek——好吧,说本地有点夸张——但这些 flash 模型都能半可靠地做出来。
所以接下来会很有意思,看看这会对那家靠硬件和软件口碑成功的公司造成什么影响。现在就很微妙了,Intel 更便宜,AMD 更便宜。你看这儿,它还在跑,往回倒一点,这就是价格和速度扫描的那个关系。
0xSero:这是它正在生成的 HTML 文件,所以它还在跑,速度还不错,大概 100 到 200 tokens/秒,取决于是不是在做预填充,有时候低一点有时候高一点。
但如果我们想想办公室里那些花钱买 Codex 的普通人的体验,他们根本不用 AI 写内核或者干什么疯狂的事。他们把它当成工作里的自动化工具,某种人和人之间的沟通层,比如我们怎么组织一个线性流程、怎么做,只要你把同步做对,AI 是能帮上忙的。而且很多这类任务并不需要多高的智能,只需要模型……
0xSero:对,只需要模型能用、有视觉、回答足够快、别犯蠢。而这样的东西能塞进 16G 里,真的很惊人。我觉得下一个也快出了,我听好几个人说 4.4 很快会发布。好,现在平均大概 50 tokens/秒。你们有什么问题吗?
小语种方案:用翻译模型配小模型
听众B:我一直在想给我们公司引入本地模型,但问题是这边几乎没人说英语,而这些小模型对斯洛伐克语这种小语种又不太行。你知道有什么项目是专门给特定语言做小模型的吗?
0xSero:我觉得你该做的是反过来:用一个翻译模型,再配上你们本地能跑的小模型。这个思路更合理。
听众B:那你了解什么翻译模型的项目吗?
0xSero:我会去 Hugging Face 上找,在 models 里翻。如果你们要处理音频,那大概还需要语音转文字;不涉及音频的话,说实话我也说不好哪个翻译模型好。
你看,这就是 DeepSeek 干的活:它把各种硬件的价格全抓过来放进一张表里。6000 那个是 14000,这是现在的价格。DGX Spark 多少钱?不过这类东西它经常搞错,这里就是错的,现在应该是 4700 或者 4800,有些数据需要更新了。对,这是 RTX 6000 Pro 的价格。所以它能去各个卖硬件的网站,把所有价格抓下来,再试着展示这一年价格是怎么变的。
听众B:好。
0xSero:这些图表它们也全都做得很烂,每次都要改半天,还是得让模型学一下 Picard。好,我要的东西都齐了,可以回答了。你看它还在跑——这就是 Qwen 的毛病,它会一遍一遍反复推理。最近有个新模型叫 Thinking Cap,这帮人应该是对 Qwen 做了后训练,让它别想那么多。
听众B:我昨天试了,我的工作流大概快了,不知道,40%?目前还没发现质量下降。他们发布十分钟后我就下载了,真的是秒下。

Qwen 3.8 27B 的实测与 GLM 5.3 Flash 的取舍
0xSero:好,看着不错。现在你只需要专注做优化。把目前最好的那个存下来——我觉得这个就是已经存在 repo 里的那个,如果不是就存一下。然后我们要优化的是预填充和解码怎么做。预填充和解码之间别停太久,如果能拿到好性能,尽量把这两个交错起来。试试看。
0xSero:这就是我现在整天干的事,坐在这儿想办法怎么帮它们解锁。
最近还有一个新模型叫 Step 5 Flash,开源了大概一个小时就被撤回了。但在开源的那段时间里,很多人都 fork 了它。抱歉,说“所有人”不准确,是 Hugging Face 上很多人 fork 了它。所以我装上了,正在对它做 EXL3 量化。他们正式发布之前我不会公开,但它在 max thinking 上的得分基本上比 Sol 高一分,就是 5.6 那个。所以我觉得它也是开源这边最强的模型,或者跟 Kimi 并列第一。
什么时候撤的?他们把模型权重撤了。你知道为什么吗?文章里说他们打算 10 月 15 号发布,结果就这么放出来了,可能是有人没经过允许就发了。
0xSero:明白了。我觉得大概就是这么回事,但我不确定,只是猜的。
0xSero:好了,出来了。我们看到本地模型 Qwen 把数据交回来了,我来看看这数据对不对。Qwen 3.8 27B,这就是我在到处推荐的东西,Qwen 就是最好的,就这样,没有别的能比得上。你知道,Thinking Cap 也有它的优势,因为 Qwen 不加它就疯狂推理。
它给我列出了我们支持的所有 GPU,每个上面哪个模型最好,速度是多少。12G 上我推荐 9B 的 Qwen,现在可能有更好的了,但为了简单起见就这样。27B 从 16G 一直到 32G 都推荐,我们能看到它跑出来的速度。我还放了一些别的模型作为选项,20G、24G、32G,全是 Qwen。
0xSero:Qwen 3.8 27B,在所有东西上都是最好的模型。还有这个速度扫描,它会告诉我们开不开推理分别是什么数字。它这块拆得还不够细。它给我列了 Intel Arc B70,这是真的,是最新的。所以它真的去读了 GitHub 的 repo,把东西都整理出来了。对,4500 上的预填充快得离谱。
0xSero:太夸张了。好,这是一个本地模型。这套系统很酷的一点是它能在运行中自我更新,这是我很想看到更多的东西。我还有一两个问题的时间,然后就得走了。有谁想聊点什么吗?
听众A:我刚在 general 频道发了个问题,主要是关于 GLM 5.3 的,就是你能不能找到质量和速度之间的好平衡,我说的应该是你前几天提到的那个剪枝版本。
0xSero:是 flash 还是?
听众A:GLM 5.3 Flash。我觉得就是这个。
0xSero:在 Blackwell 上我一直尽量避开 REAP 剪枝,因为 EXL3 能让我们压到甚至 2 bit,性能还比别的量化方案好很多。所以我就尽量用 EXL3。不过我也能在 EXL3 上做剪枝,但那样性能会更差。
这点很多人可能不明白,这是个取舍:是的,这肯定会损失一些智能,但好处是我们能塞下双倍的 KV 缓存。我有时候会剪枝,比如说我们有张 16G 的显卡,要么低于 4 bit 压到 3 bit,要么剪掉模型 25%。这里面有个取舍:你可以要一个在网络安全、写代码上很强,但在别的方面又蠢又剪过的模型;也可以要一个在哪都平均地笨一点的模型,这么说能理解吧。这点得记住。但现在我只专注 EXL3,因为它的方案更好。
听众A:好,我之前主要还是盯网络安全和编程这两类模型。
0xSero:对,我发在 GitHub 上的,基本都是我手上能调到的最好的版本。所以你去我那些仓库里翻,一般都能找到,比如 DGX Spark 上跑的 GLM 5.3 Flash 这种。你要是直接去搜,东西是挺多的,不过你把它扔给 agent,它自己就能理清楚。
另外你看这儿,能看出速度的差别:右边这个是 NVIDIA,NVIDIA 在这边,然后这个是 Intel Arc B70。当然这不算完全公平的对比,它不是从零跑的,但预填充还是快了两倍,这挺常见的。对,它那个预填充得跑到天荒地老。好,这个是 130.90,飞一样快。这完全说得通。在我看来,它比几个月前的 5.3 Coder 表现还好,能做的事更多,管起来也没那么烦,而且就这个水平来说价格还算便宜。总之,谢谢大家抽时间来参加,我们下期见。
原视频:How I use Opus-5.5 and Qwen3.8-27B for Kernels and AI work
https://www.youtube.com/watch?v=iTUNk9XfoGU
中文播客:在小宇宙App搜《播客快译》,或直接访问下面的链接
https://www.xiaoyuzhoufm.com/episode/6acb6cec195d838e2af02a61
编译:磊哥Thomas