

想在本地跑一个自己的模型,很多人卡住的地方不是显卡不够,而是配置。哪张卡配哪份权重、什么量化、用哪个引擎、开多少张量并行,这些参数散落在论坛、博客和零星的分享里,愿意公开分享配方的人不多。0xSero 说,本地 AI 现在最头疼的就是配置问题。
他举的例子很具体:注册表里的一个 JSON 文件,里面是在四张 RTX Pro 6000 上用 vLLM 跑 DeepSeek v4 flash 的完整配置,连要用的 Docker 镜像都写好了,用户不用自己一项一项调,拿起来就能消费。而现有的 Spark Arena、LocalMaxxing、local.ai 会收集配方,却没有一个统一的注册表能直接查。
本期对话里,0xSero 既是主讲人,也是这份 Local AI 配置注册表项目的主导者;另一位嘉宾在对话里提到 Hugging Face 出的 Tau 深受 Pi 启发、基本是照 Pi 移植的 Python 版,并说自己测过 HiCache、发现它没法跟 SGLang 的 HiCache 模式一起用。两人从注册表的三层结构聊到实战里怎么选 harness、怎么复用 KV 缓存,以及没有硬件的人该怎么开始。他的主要观点包括:
注册表是给配置做的对照表:一个 GitHub 仓库,硬件、模型、模型实例各存成 JSON。 每个硬件有自己的 ID,还带显存带宽、价格和限制;模型指向原厂发布的基础模型,比如 GLM 5.2,而不是 Hugging Face 上那些有细微差别的版本。0xSero 说,现在公开的只有硬件这一块,模型和配方他做好了但还没推上去。
三层里真正有用的是模型实例:配方绑死具体硬件,一个 JSON 就是一条可消费的命令。 0xSero 举例,这些 ID 基本就告诉了你配置是什么:Gemma 4、EXL3 量化 4 bit、跑在 RTX 4090 上、用 TabbyAPI、张量并行 1;如果是 TP4,那就是 GLM、NVFP4 REAP、跑在 6000 上。你不用逐项配,镜像会在机器上自动装好。
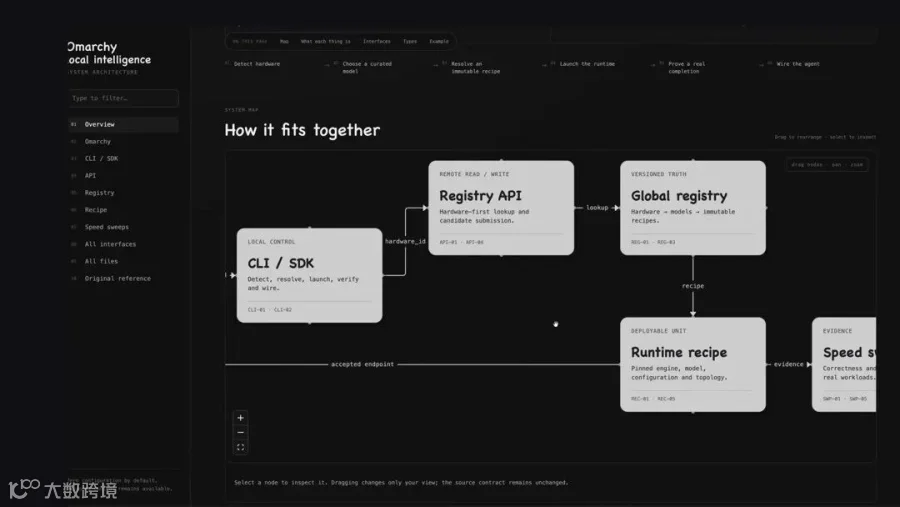
硬件匹配在本地完成,注册表只是一个装着数据的 JSON 文件。 软件在本地跟注册表做匹配:你给它硬件,它返回模型,模型再给出所有可能的配置,有的 KV 缓存更大,有的更快。消费方包括一个叫 Omarchy 的 Arch 系 Linux 系统,拉取配方后点一下就能加载模型。
0xSero 说,本地模型跑起来之后,能直接塞进 Pi 或 Hermes 这类 agent。 用 Omarchy 时,选好模型点运行,它会加载模型、把模型塞进 agent,再把 agent 启动起来,agent 那边完全不用配置。他提到这等于把操作系统的直接权限交给模型,显然有风险;不过 Mac 上也能做同类的事,只是 Omarchy 跟系统结合得更紧。
0xSero 说 ZCode 可以自己添加服务商,让 app 直接调用本地跑的模型。 他演示时说自己对 ZCode 很满意,可以添加模型列表和这些模型的配置,跑在家里能跑的那些模型,还能设 goals 和 automations。他提到在 ZCode 里 GLM 表现相当好,另外 DeepSeek harness 那几种模式也不错,直接把 JSONL 给你,可以拿去做后训练。
0xSero 提议配方应该在 JSON 里标注生成时用的引擎版本。 他担心 vLLM 或 SGLang 版本迭代后更新会碰上 bug,标一下版本会有用。他说他对每个条目都做了版本管理,记录什么时候发布、怎么跑的、跑出来的速度,条目里还会显示跑在什么硬件上、用的哪个引擎和实测数据,其中“每秒 25 个 token”是他随口举的例子。
嘉宾认为最好的 harness 是 Pi,理由是它轻、吃内存少,0xSero 也认同。 他让 Pi 报过自己的 system prompt 占用:二十万里只占 0.7%,不到 2k token,这里面还包括所有 skills、system prompt、文档和 Pi 的文档索引,所以本地模型用它的表现很好。嘉宾则提到 Hugging Face 出的 Tau 深受 Pi 启发,有专门的 API 暴露思考过程,0xSero 说自己还没试过。
0xSero 用一个假设场景说明 KV 缓存复用的必要性。 他设想用 Ollama 或 Claude 的 agent 工具跑本地模型:Claude 启动时会往模型那边塞一个四万 token 的 system prompt,如果预填充速度是每秒三四百 token,光这四万个 token 就得等好几分钟,不缓存的话每次开新会话都要重等。嘉宾补充说自己测过 HiCache,现在有个 bug,没法跟 SGLang 的 HiCache 模式一起用。
本地AI配置为什么需要一个注册表
0xSero:今天我就想专门聊这个。如果你们玩过本地AI,肯定对配置这个问题不陌生,每一类硬件都有自己的一套配法。我开始把各种卡都租了一遍,我自己有3090,也租过很多做本地推理常用的卡。后面还会把Mac也加进来,Mac也算本地,所有Mac设备都算。现在本地AI最头疼的问题就是这些配置,我打算这么解决。
嘉宾:相当于给配置做一个LM Studio?
0xSero:是个配置注册表。注册表本身就是一个GitHub仓库,里面存这些条目。
先说硬件,每个硬件都有一个ID,我还把显存带宽、价格这些都加进去了。每个硬件自己有ID、显存,还有它的各种限制,因为你有Blackwell的卡,还有各个代际的卡。
硬件之后是模型。模型指的是原厂或者原提供方发布的那个基础模型,不是Hugging Face上那些各有细微差别的版本。比如GLM 5.2就是一个模型。
0xSero:模型这部分我还没推上去,现在公开的只有硬件这一块,剩下的我做好了但还没推。它会带一个Hugging Face的链接、LocalMaxxing的链接,跟这个模型相关的东西都会放在注册表里,就是你现在看到的这套schema。每个模型都有自己的一个JSON文件。
0xSero:对你们真正有用的是模型实例。模型实例就是硬件加配方的组合。配方是你在这张卡上把模型跑起来的初始配置。问题是现在大部分配方一出来就是面向数据中心或者特别贵的卡的,愿意分享配方的人不多,公开信息也很少,基本得自己摸索。有Spark Arena、LocalMaxxing、local.ai这些网站会找配方、收集配方,但没有一个统一的注册表能让你直接查,查完基本就等于拿到一条命令。
所以这个JSON文件,就这一个文件,里面是在四张RTX Pro 6000上用vLLM跑DeepSeek v4 flash的完整配置。你打开看,里面是我们验证过没问题的各种配置,还有镜像,镜像就是Docker镜像。所以你不用自己一项一项配,全都自动在你机器上装好。你只要消费这个注册表就行。
刚说岔了,这个是操作系统,一个Linux操作系统,跟Arch很像,叫Omarchy。它就是我说的配置注册表的消费者,会从注册表里拉配方。任何人都能把注册表里的内容拉下来,它是开源的。
现在配方的提供方有四家:local.ai、经过他们同意的LocalMaxxing、Mia Labs,还有我。我觉得Spark Infer之后也会进来。你可以用CLI、用SDK,或者直接上网站操作,就跟用Hugging Face一样,只要你把硬件连上去,它就能告诉你该用哪个模型、用哪套配置,还会告诉你有多少KV缓存可用。用起来就是通过shell或者菜单,某个app或者某个CLI,网站也行。
0xSero:你调用它,它找到你的硬件,然后返回你的配置,比如你是四张卡还是两张,走不走PCIe,是什么型号的卡。这个软件跑在本地,在本地跟注册表做匹配。注册表就是那个装着所有数据的JSON文件,它只是在本地帮你对上。
0xSero:它就能给你拉来对的东西。对,不管你用哪个界面,你给它硬件,它给你模型,模型再给你所有可能的配置。有的配置KV缓存更大,有的更快,各有所长。它会给你那个配方、那套配置的版本,你可以自己跑,也可以让软件帮你跑。
用Omarchy的话它就能帮你跑起来,你点一下想跑的模型,它就加载起来了。界面看着有点乱,但你可以直接输指令。其实挺直白的,你挑一个模型就行。比如你选Qwen,它要么直接加载,要么把现在跑的先卸掉,再给你加载Qwen。跑起来之后它会塞进你想要的任意agent。agent那边你完全不用配置,它直接给你加载Pi或者Hermes。你就说运行,想象一下就是本地AI运行Pi。聪明,聪明就是Qwen。它加载模型,把模型塞进Pi,再把Pi或者Hermes启动起来。
因为Omarchy就是Arch,Arch Linux,你可以把系统配置细到每一个细节。所以模型是有权限去配置你的操作系统的。这显然有点风险,因为你等于把操作系统的直接权限交给了一个模型。但它能干一些事,Mac上当然也能做,只是它跟系统结合得更紧。
0xSero:如果这些你能看懂的话,这些ID是有点长,但它基本告诉了你配置是什么。比如Gemma 4,EXL3量化,4 bit,跑在RTX 4090上,用TabbyAPI,张量并行是1。如果是TP4,那就是GLM,NVFP4 REAP,跑在6000上,张量并行4。

配方要不要记录引擎版本
0xSero:配方生成的时候,会记录用的 vLLM 或者 SGLang 是哪个版本吗?因为有时候会有版本迭代,你更新之后可能碰上 bug 之类的。标一下配方做好时用的是哪个版本,应该会挺有用,至少写在 JSON 里。
嘉宾:对,我们给每个条目都做了版本管理,记录它什么时候发布、怎么跑的、跑出来的速度。
回到 local AI 这边,你看,模型在哪呢,这块我好像还没放进去,但它会告诉你是在什么上面跑的。比如 DGX Spark,用的哪个引擎、运行时长,还有实测数据。
这些就是我们用的参数,它会告诉你,哦,跑了大概每秒 25 个 token。这数字我是随口说的。
Zcode实用体验:让App用上自己的模型
嘉宾:我一直想试试 ZCode,只是一直不知道该怎么念。我看你在用,你现在觉得 ZCode 怎么样?
0xSero:挺好的。我先静音一下,停一会儿共享屏幕。它确实很好用。我很满意,我再开一下共享屏幕。
它允许你添加自己的服务商,也就是说你可以跑本地推理,让这个 app 很轻松地用你自己的模型。你可以添加模型列表,还有这些模型的配置。看这里,我可以跑我自己的模型,就是能在家里跑的那些模型。它真的在干活,有 goals,你可以设目标;还有 automations,挺不错的。ZCode 里 GLM 表现相当好,这点很加分,对,在 ZCode 里挺好用。
这些 app 我都在用,有 ZCode,有我自己的,还有这个。DeepSeek harness 其实挺酷的,它那几种模式很不错,而且直接把 JSONL 给你。这些全是训练数据,你可以拿它做后训练,这就是他们做后训练或者训练用的格式。我看看。行,我用得挺舒服的。让我想想还有哪些 harness。还有这个,OMP 其实挺香。

最推荐的harness是Pi,Tau还没试
0xSero:不知道你们有多少人试过 OMP,但要说最好的 harness,我会说是 Pi,这么多里面我最推荐 Pi。它能帮你搞明白这一堆东西到底是怎么回事,而且特别轻量,哪怕你内存不多它也能有奇效。它的 system prompt 很小,我们让它报了一下,20 万里只占 0.7%,也就是不到 2k token,这还包括所有 skills、system prompt、文档,以及 Pi 的文档索引。所以你如果用本地模型,它表现是真好。
0xSero:我觉得你会喜欢这个。
嘉宾:你们试过 Hugging Face 出的 Tau 吗?它深受 Pi 的启发,基本上是照着 Pi 移植成了 Python 版。我听了一期播客,说它有一套专门的 API 来暴露思考过程和推理这些,所以你能更清楚地看到实际发生了什么,这点在 Pi 里默认不太看得到。
0xSero:我还没试过。是叫 TAU 吗?
嘉宾:TAU,T-A-U,就是两个 Pi,TAU 这个 harness。二乘 Pi,我猜域名就是这个。
0xSero:对,就是那个域名。GLM 我喜欢的地方是,它基本不会拒绝你。你不用费劲去说服它做什么,直接告诉它要干什么,它就干了。
KV缓存与HiCache的现状
嘉宾:把 TP 从四改成二之类的,然后在第二个菜单里就能配置了。数量大概是两百来个吧,不是八个。
嘉宾:另外,HiCache 这块我测过,现在好像有个 bug,没法把 SGLang 的 HiCache 模式跟这个东西一起用。
0xSero:HiCache 是什么?是 SGLang 那个吗?
嘉宾:我觉得算是 LMCache,但是原生的。而且你甚至能把它接到 Mooncake 之类的上面,我觉得可以,L3 那个模式我没试过。
0xSero:HiCache 就是,如果你用 SGLang 的话有 HiCache,另外还有 LMCache。它们能让你把预先算好的 KV 缓存存下来。
想象一下,你用 Ollama 或者 Claude 的 agent 工具跑本地模型,Claude 启动的时候会往模型那边塞一个四万 token 的 system prompt。如果你的预填充速度是每秒三四百 token,那光是这四万个 token 你至少得等好几分钟。而且如果你不把这部分缓存留住,每次开新会话都得重新等一遍,太难受了。
所以你可以配好 LMCache 或者 HiCache 之类的,我记得 LM Studio 也有一个,MLX 也有,把缓存放到 NVMe 存储或者内存里。

不必自己买卡:按需求挑模型和算力
0xSero:你要做的就是,先想想有哪些模型能填上这个需求,再想想你需要它跑多快,然后去 OpenRouter 上挑一个提供你想要的模型的供应商,或者去 Vast.ai 租张卡。Vast.ai 上有 Spark,你甚至可以租 Spark 来试试东西。
0xSero:这样你就能判断,这东西到底值不值得买。你不一定非要自己有硬件,没有硬件天也不会塌。你没有落后。就按你的节奏来,别担心,没事的。
每个行业都有这种 FOMO 的时候。加密圈当年大家都在 FOMO 那些币,现在全归零了。所以别太焦虑。
原视频:Local AI 101 - How to run your agents with Local Models
https://www.youtube.com/watch?v=fQIjK1s5Moc
中文播客:在小宇宙App搜《播客快译》,或直接访问下面的链接
https://www.xiaoyuzhoufm.com/episode/6acb617ae742e36efcc14021
编译:磊哥Thomas