

——象信 · 系统一系列之六
前五篇讲的都是它能做什么。这一篇反过来。
我们把模型的短板整理成了一页文档放在官网上,谁都能看。现在把它讲给你听——因为看完这篇,你才会相信前面五篇。
先给总原则
只有一条:
用你自己的数据测一测,再用置信度做路由。
任何通用结论都不能替代你在自己业务上的抽样评测。下面所有内容都是"类型描述"和"规避方法",不是量化承诺。
十项速查表
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|

十项速查表:别这样用它 / 为什么 / 更好的做法
下面挑几条最容易踩的展开说。
第 4 条:它不是计算器
它能理解"金额很大""时间很紧"这样的语义,但不擅长精确的数值处理。
计数。 统计一段话里某个词出现几次、一个列表有多少项符合条件,结果都不可靠,而且数量越大误差越大。
算术与比较。 两个金额相减、判断 ¥1,280.00 是否超过 ¥1,200 的报销上限——这类问题交给模型没有意义。
日期。 模型把日期当文本读,不是当可比较的数值。"哪个日期更早""相差几天""是否在 7 天无理由退货期内"都不可靠,混合格式(2026/9/1、9 月 1 日、下周三)时更差。
正确做法是把判断和计算彻底分开:
python items = ["苹果", "路由器", "香蕉", "充电宝", "荔枝", "数据线"]
# 判断交给模型:每一项是不是水果 resp = client.system_one( state={"items": items}, questions={ f"item_{i}": Noul(instructions=f"`items[{i}]` 是不是一种水果?") for i in range(len(items)) }, )
# 计数留给代码 count = sum(resp.answers[f"item_{i}"].noul > 0.5 for i in range(len(items))) print(count) # 3 |
顺带说一个细节:Score 的 score 不能用来反推两档之间的精确数值。 它是各档编号的概率加权平均,适合和阈值比较,但别拿它当"精确刻度"。
第 1.1 条:它不擅长说"没有"
这一条最反直觉,也最容易在生产里翻车。
系统一模型擅长判断"文中说了什么",不擅长判断"文中没说什么":
-
用 Noul 问"文中是否提到了 X?"时,即使文档里完全没有 X,答"是"的概率也可能偏高; - 不要用 Noul 的 0.5 阈值判断某个内容是否存在
; -
用 Choice 并提供「文中未提及」选项通常更好,但仍会随状态长度波动。
正确做法是换个顺序:
python # 不要这样问 Noul(instructions="`doc` 里是否提到了传真号码?") # 没有也可能给高概率
# 先用正则在代码里确认候选是否出现 candidates = re.findall(r"(?:传真|fax)[::]?\s*([\d\-+() ]{7,})", doc) if not candidates: return None # 代码直接判定:没有
# 然后再让象信判断含义 Choice(instructions="`doc` 里哪一个号码是传真?", criteria={**{c: c for c in candidates}, "none": "都不像是传真"}) |
存在性交给代码,含义交给模型。
第 6 条:它回答的是你写下的问题
这一条最像"人的问题":它不一定是你心里想问的那个问题。
限定词、否定和隐含条件都会被按字面理解。比如问"用户是否要求退款?",对"不退款的话至少给我换一个吧"这样的消息,模型和人的理解可能不同。
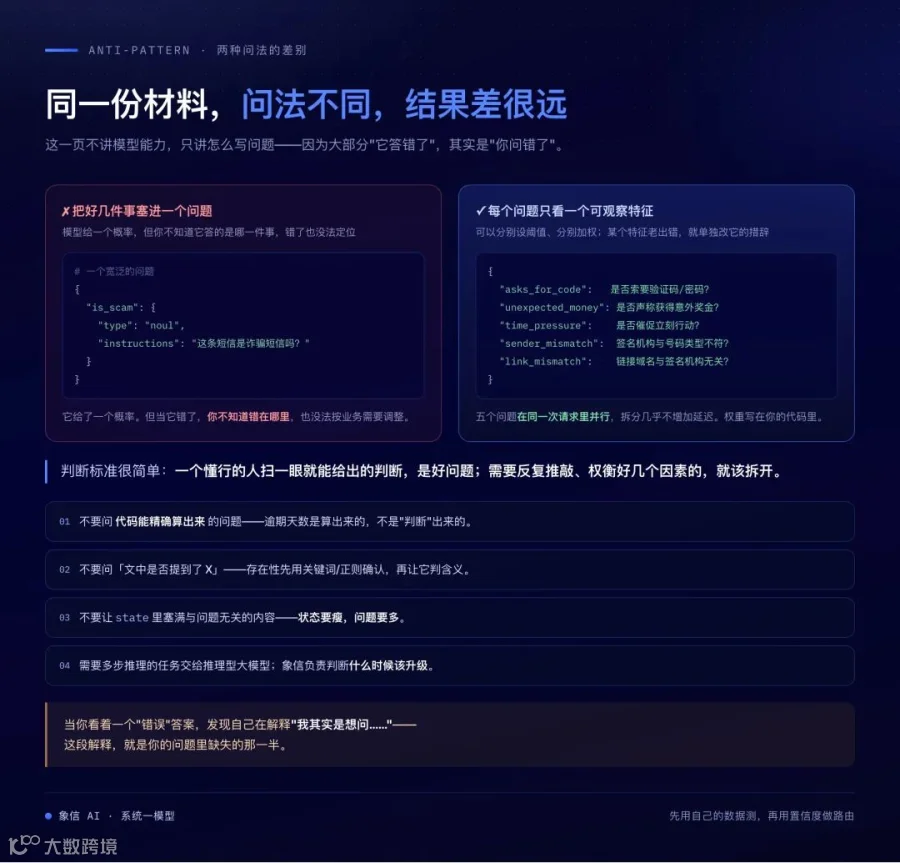
两种问法:把好几件事塞进一个问题 vs 每个问题只看一个可观察特征
文档里有一句话,我认为是整个项目里最有价值的一句经验:
当你看着一个"错误"答案,发现自己在解释"我其实是想问……"时,这段解释就是问题里缺失的那一半。
把它补进 instructions 或 criteria,问题往往就对了。这比反复调提示词有效得多。
第 8 条:不要假设它满足数学关系
对于语义相近的输入,象信输出相当一致。但很多你可能默认成立的"数学关系"并不保证:
-
同一个问题分别用 Noul 和"是/否"两个选项的 Choice 来问, noul和probabilities["是"]不一定接近; -
一个问题和它的否定形式分别用 Noul 问,两个概率之和不一定等于 1。
示意:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
1.15 |
原因是:Choice 是相对判断——回答"几个选项里哪个最合适";每个 Noul 是绝对判断——所有候选都可能同时偏低。
所以:每个判断只用一种你真正想要的问法;不要把在 Noul 上调好的阈值直接搬到 Choice 上;需要的恒等关系在代码里自己保证。
第 9 条:近似确定,不是逐位确定
这一条会影响你的单元测试。
象信不采样,同样的请求会得到几乎相同的结果。但由于低精度浮点与批处理,中间区间的概率会有小幅波动:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
所以:
-
单元测试里不要写 assert noul == 0.81,改成区间或阈值断言; -
不要把阈值恰好设在你观察到的某个值上; -
落在阈值附近的样本,本来就应该按"不确定"处理。
第 5 条与第 2 条:两个结构性问题
多跳推理。 需要连续好几步推理的问题("A 的上级所在部门的负责人是否批准过 B?")、需要在很长规则文档上逐条套用的问题、依赖大量专业知识的问题——准确率明显低于简单的单步判断。双重否定和"关于某个属性的属性"这类间接表述也会降低准确率。
做法:把多跳拆成多步,中间结果用代码查好放进状态;在 instructions 里用反引号直接点名状态中的相关字段("申请单.金额 是否符合 报销制度.差旅 的规定?"),减少模型自己找内容的负担。
选项首位偏好。 当多个选项的内容能明显区分时,调换顺序基本不影响结果。但当选项之间难以区分(描述相同、过于相近,或状态里根本没有足够信息做出区分)时,概率会倾向于集中在排在前面的选项上。
极端情况:20 个描述完全相同的选项 → 第 1 个选项分到大部分概率;100 个以上高度相似的选项 → 末尾选项几乎为 0。
做法:给每个选项写出能与其他选项区分开的描述;选项很多时先在代码里粗筛到少量候选;对关键决策,用两种顺序各问一次(放在同一个请求里,几乎不增加延迟)再取平均。
五条避坑清单
抄在便利贴上:
- 不要问代码能精确算出来的问题。
- 不要在一个问题里藏好几个判断
——拆开问,在代码里组合。 - 不要把需要多步深度推理的任务交给它。
- 不要往
state里塞超出问题所需的内容。 - 不要对概率做精确相等比较。
为什么要把这些写出来
说一句实话:把短板整理成一页放在官网上,对获客没有帮助。
但我们认为它有三个好处:
- 对你
:省下几个小时甚至几天的试错,不至于把不适合的任务硬塞给它,然后得出"这东西不行"的结论; - 对我们
:这些吐槽我们早就自己提过了,客户的反馈质量会更高,指向真正需要修的地方; - 对这个品类
:"系统一模型"是个新东西,行业里还没有共识。把边界说清楚,比喊它什么都能干,更有利于它被正确使用。
如果你发现了这一页没列出的问题,欢迎发最小复现请求(附上 x-request-id)给我们——文档里就是这么写的,我们也希望你真这么做。
下一篇:《Agent 行动安全:在工具执行前那 200 毫秒里》。
动手入口
-
领免费额度(注册送 ¥5):console.xiangxinai.cn -
完整短板列表:model-jaggedness/xiangxin-2.0 -
置信度怎么用:confidence -
反馈问题:wanglei@xiangxinai.cn(附 x-request-id)
说明:本页内容整理自象信 2.0 已知短板文档;具体数值与结论以官网当前版本为准,请用你自己的数据复测。